字符串及文件读写
字符串及文件读写
-1 检查浏览器渲染数学公式情况
因为笔者发布文章当天,本博客仍然存在 Latex 可能无法渲染的情况,下面是一个 Latex 示范:
$x$
- 如果正常显示为衡水体 x,则代表读者的浏览器已经成功渲染了 Latex
- 如果显示为 带有美元符号的 x 即
$x$(已除去换行符),则代表读者的浏览器没有成功渲染 Latex,读者可能需要刷新重试,如果刷新多次仍然无法渲染,请尝试换一个浏览器/网络环境
0 框架
你好,这里是 https://www.tropical-fish.cn/,本专题主要讲解 字符串及文件读写,感谢 深入浅出程序设计竞赛(基础篇) 提供的重要支持
这是 C++ 语法基础 的重要补充部分,包括了在 CCF 及其他系列比赛 获得 $\text{非}0$ 分数的方法,注意,这不是危言耸听
$$ \begin{aligned} &\textbf{字符串} \begin{cases} &\text{char}\\ &\text{string}\\ &\text{freopen} \end{cases} \end{aligned} $$
如上面的框架,笔者会介绍
- 字符串的存储
- 字符串的处理方法
- STL 字符串
- 文件输入输出
不废话了,现在开始!
1 char 字符数组
字符数组的 ASCII 本质与常用字符表
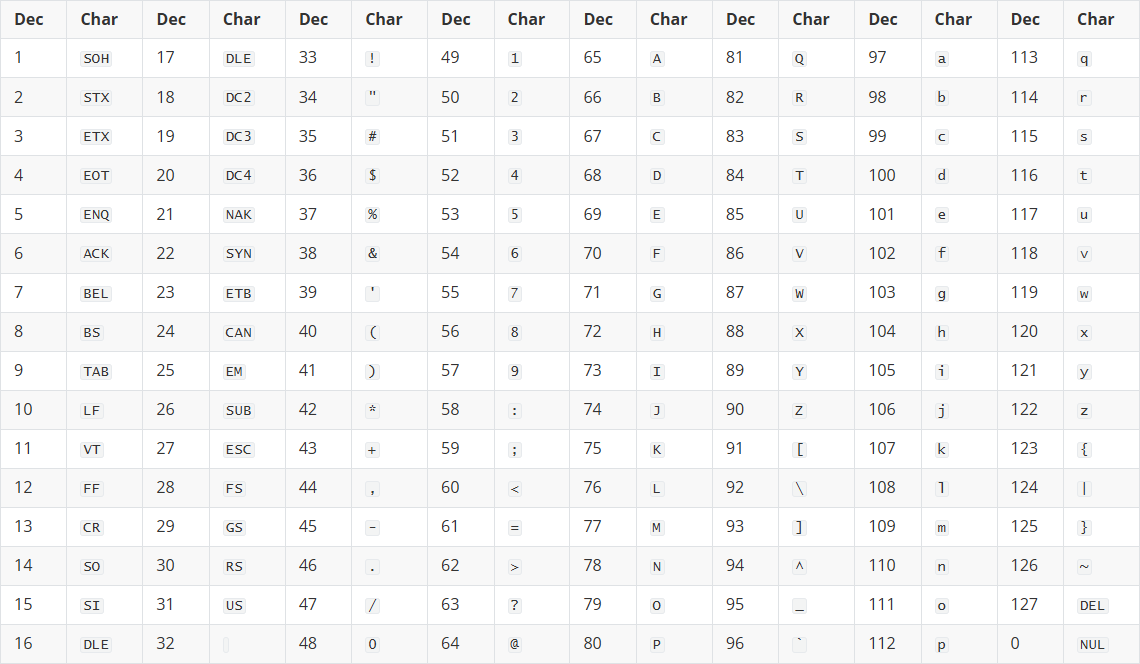
字符数组本质上和整数数组并没什么太大的区别,整数数字每一个下标存的是数字,字符数字存的是 字符(其实是 ASCII 码对应的数字),将这些字符存到数组里,便成为了一串字符,即 字符串,下面这张表是 ASCII 表,它们分别将 数字 对应了 字符,读者并不需要记忆全部的内容,仅需要记忆关键的键值,例如 0、A、a、 (空格),它们相对重要
| Dec | Char | Dec | Char | Dec | Char | Dec | Char | Dec | Char | Dec | Char | Dec | Char | Dec | Char | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | SOH | 17 | DLE | 33 | ! | 49 | 1 | 65 | A | 81 | Q | 97 | a | 113 | q | |
| 2 | STX | 18 | DC2 | 34 | " | 50 | 2 | 66 | B | 82 | R | 98 | b | 114 | r | |
| 3 | ETX | 19 | DC3 | 35 | # | 51 | 3 | 67 | C | 83 | S | 99 | c | 115 | s | |
| 4 | EOT | 20 | DC4 | 36 | $ | 52 | 4 | 68 | D | 84 | T | 100 | d | 116 | t | |
| 5 | ENQ | 21 | NAK | 37 | % | 53 | 5 | 69 | E | 85 | U | 101 | e | 117 | u | |
| 6 | ACK | 22 | SYN | 38 | & | 54 | 6 | 70 | F | 86 | V | 102 | f | 118 | v | |
| 7 | BEL | 23 | ETB | 39 | ' | 55 | 7 | 71 | G | 87 | W | 103 | g | 119 | w | |
| 8 | BS | 24 | CAN | 40 | ( | 56 | 8 | 72 | H | 88 | X | 104 | h | 120 | x | |
| 9 | TAB | 25 | EM | 41 | ) | 57 | 9 | 73 | I | 89 | Y | 105 | i | 121 | y | |
| 10 | LF | 26 | SUB | 42 | * | 58 | : | 74 | J | 90 | Z | 106 | j | 122 | z | |
| 11 | VT | 27 | ESC | 43 | + | 59 | ; | 75 | K | 91 | [ | 107 | k | 123 | { | |
| 12 | FF | 28 | FS | 44 | , | 60 | < | 76 | L | 92 | \ | 108 | l | 124 | ` | ` |
| 13 | CR | 29 | GS | 45 | - | 61 | = | 77 | M | 93 | ] | 109 | m | 125 | } | |
| 14 | SO | 30 | RS | 46 | . | 62 | > | 78 | N | 94 | ^ | 110 | n | 126 | ~ | |
| 15 | SI | 31 | US | 47 | / | 63 | ? | 79 | O | 95 | _ | 111 | o | 127 | DEL | |
| 16 | DLE | 32 | | 48 | 0 | 64 | @ | 80 | P | 96 | ` | 112 | p | 0 | NUL |
其中的第 $0 \sim 31 \& 127$ 号字符是控制字符,第 $32$ 号字符是空格
在 OI 的场景下,一般只有第 $32 \sim 126$ 号元素起到了相对关键的作用
【题目样本 1.1】P5733 自动修正
题目描述
https://www.luogu.com.cn/problem/P5733
大家都知道,一些办公软件有自动将小写字母转换为大写的功能
输入一个长度不超过 $100$ 且不包括空格的字符串。要求将该字符串中的所有小写字母转换成大写字母并输出
例如输入 Luogu4!, 输出 LUOGU4!
做法 1
分析
既然单个字符可以使用 char 类型存储,那么存储一串字符就可以使用数组,我们可以定义一个数组 $s[]$,其中每一个下标都是字符类型,即 char s[100];,这样的 字符数组 就叫 字符串
读入字符串的办法大同小异
- 使用
scanf("%s",s);读入一个字符串,其中%s代表数据类型,即字符串,s是定义的字符数组的名字
至于为什么不需要取地址符&,因为s是一个数组,这里的s在大多数表达式中会 自动转换为指向数组首元素的指针,即&s[0],类型是char*,仅此而已 - 使用
cin>>s;
请 特别注意 这一点,这两种读入方法只能读到空格、换行符、EOF(文章后面会有讲解),至于输入想要包含空格、换行符又想读入到同一个字符数组中,需要使用其他办法,文章后面同样会有讲解
参考代码
这段代码摘取至 深入浅出
#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    char s[110];
    scanf("%s", s); // 读入这个字符串,还可以使用 cin>>s; 语句
    for (int i = 0; s[i] != '\0'; i++) // s[i] != '\0' 也有别的方法获取,具体会在文章后面提到
        if ('a' <= s[i] && s[i] <= 'z') /* 如果这个字符在'a'到'z'中间,说明是小写字母 */
            s[i] -= 'a' - 'A'; // 把这个字母转换成对应的大写字母,减去偏移量
    printf("%s\n", s); // 输出这个字符串,还可以使用 cout<<s<<endl; 语句
    return 0;
}
ASCII 码偏移量
这本身并不是一个特有名词,反倒是一个通俗的用语,它的意思由 Deepseek V4 Pro 提供:利用 ASCII 码表中字母的连续编码,通过加减一个固定值(偏移量)来实现大小写转换或字符映射
至于能否听懂,那就因人而异了,下面是一段解释:
如果你认真看了上面的 ASCII 表,你应该会发现 小写字母的顺序和大写字母的顺序分别是按照字母表的顺序排列的,a-A 是小写字母和对应大写字母的 ASCII,这被通俗地认为为 偏移量,这在其他的场景中也有体现,为了缩短篇幅,这里不再阐释,请 特别注意,小写字母的 ASCII 码相对于大写字母大
那么就很好说了,上面的代码利用 if ('a' <= s[i] && s[i] <= 'z') 判断是否是小写字母,如果是,减去偏移量,这样得到的字母就是大写字母了
字符串存储与 \0 结束标记
这段字符串在字符数组中的存储方式如下图
| s[0] | s[1] | s[2] | s[3] | s[4] | s[5] | s[6] | s[7] |
|---|---|---|---|---|---|---|---|
| 76 'L' | 117 'u' | 111 'o' | 103 'g' | 117 'u' | 52 '4' | 33 '!' | 0 '\0' |
$s[]$ 中的每一个元素,都存储了一个不超过 $127$ 的整数,它们分别对应了 ASCII 编码中的字符
最开始的字符存在 $s[0]$,这个字符串虽然有且仅有 $7$ 个字符,但它却占用了 $8$ 个下标,即 $s[0] \sim s[7]$,字符串的末尾,存了一个特殊的字符 结束标记字符,它是 \0 ,也可能会有 ,这个结束标记被用于提示一个字符串的结束位置,它会在修改字符串的时候自动调整,一个例子,我们在用 \n 换行符,划掉的原因是因为笔者暂时没有找到任何明确的证据cout<<s 的时候,结束标记就会告诉 cout 字符串已经没了,提一嘴,类似这样的 “特殊字符”,还有好几个,例如 \n(ASCII 表中可能被表示为 10,划掉的原因同上)
[collapse status="true" title="如何表示 \?"]
#include <bits/stdc++.h>
using namespace std;
int main(){
    cout<<"\\";
}
cout 内的第一个 \ 是转义符,转义后面的字符,因为第二个 \ 转义了 ",为了避免第二个 \ 被转义,所以只好用第一个 \ 转义第二个 \,这样第二个 \ 就不会转义 " 了
控制台输出:
PS D:\Users\Lenovo\Downloads\output> & .\'test.exe'
\
[/collapse]
做法 2
分析
当然,也不用一次直接读入整个字符串,可以每次只读入一个字符,判断是否需要处理,(处理后)输出这个字符即可
这里可以使用 getchar() 函数获取输入中的一个字符,如果你具有好奇心,你可以打开下面的折叠框
[collapse status="true" title="getchar() 的返回类型"]getchar() 被定义于 cstdio 头文件,因此你需要在使用的时候导入这个头文件
答案:getchar() 返回 int 类型
至于为什么不返回 char,这是因为它要正确处理文件结尾标识符 EOF,后面你就能看见了,马上
因此,尽管你定义了一个 char 类型的变量,调用 getchar() 的时候他会自动根据 ASCII 表转换成 char 类型
这是一个例子:
#include <bits/stdc++.h>
using namespace std;
int main(){
    char s;
    cout<<"请键入一个字符:";
    s=getchar();
    cout<<"您键入的字符是:"<<s;
}
PS D:\Users\Lenovo\Downloads\output> & .\'test.exe'
请键入一个字符:s
您键入的字符是:s[/collapse]
相应的,putchar() 用于输出一个字符
参考代码
#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    char s;
    while (1) {
        s = getchar(); // 每次调用 getchar() 函数,读入一个字符
        if (s == EOF)
            break;
        if ('a' <= s && s <= 'z') // 如果这个字符是小写字母
            s += 'A' - 'a'; // 把它转换成大写字母,这样写和上面是一样的
        putchar(s); // 调用 putchar() 函数,输出一个字符
    }
    return 0;
}
输入结束和 EOF
运行程序,结果发现无论输入什么,程序都没有反应,这是因为程序不认为输入已经结束了,继续在等待输入
遇到这种情况,输入完字符串后,按一下 Ctrl+Z 组合键,再按一次回车,就可以完成读入了
程序中读入一个字符都会判断是否读完了整个文件,如果文件被读完了,那么 getchar() 函数会返回 EOF(一个特殊的常量),即 End of File,这标志着读入已经结束了
在控制台中可以使用 Ctrl+Z 组合键(Windows 下)或者 Ctrl+D 组合键(Linux 下)来输入 EOF 标记提示程序输入已经完毕
至于一些教材使用的
gets()函数将字符串读入字符数组,由于存在字符数组越界的风险, 已经不再建议使用,新的 C++11 标准更是删除了这个函数而输出一个字符串还可以使用
puts()方法,同时会自动输出换行,这倒是还能使用如果您了解 HUSTOJ,您应该会遇到
#define gets(S) fgets(S,sizeof(S),stdin),仅仅提一嘴
【题目样本 1.2】P1914 凯撒密码
题目描述
https://www.luogu.com.cn/problem/P1914
凯撒密码是由原文字符串(由不超过 $50$ 个小写字母组成)中每个字母向后移动 $n$ 位形成的
z 的下一个字母是 a,如此循环
给出 $n$ 和移动前的原文字符串,请求出密码
分析
你可以导入这个字符串,一个一个处理,然后输出
你需要注意,你不能直接给每一位加上 $n$ 然后输出,因为可能会溢出,举一个例子,一个字符串是 $\text{z}$,$n=5$,如果直接加上答案就是 $\text{DEL}$($127$),如果不清楚这是什么,请翻阅前面的 ASCII 表,很明显答案是错的
所以,我们应该使用 s[i]-'a' 来计算和 $\text{a}$ 的偏移量,然后加上 $n$,得到目标字母的位置,一个例子,$\text{b}$ 这个字母移动 $4$ 位,就是第 $1$ 个字母($\text{a}$ 是第 $0$ 个字母)向右移动 $4$ 位,是第五个字母,即 $\text{f}$
为了要求这个位置始终在 $0 \sim 25$ 之间,我们应当把上一段计算除的结果对 $26$ 取模,后面还需要再加上 $\text{a}$,以还原为字母,记 s[i]-'a' 为 $t$,则计算的答案为 $(t \bmod 26)+\text{a}$
警告:读者应当理解 $a$ 与 $\text{a}$ 的区别,第一个指的是字母,第二个指的是值
参考代码
#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    int n;
    char s[60];
    scanf("%d %s", &n, s);    // 读入字符串
    for (int i = 0; s[i] != '\0'; i++)
    putchar((s[i] - 'a' + n) % 26 + 'a');    // 计算偏移量并还原
    return 0;
}
【题目样本 1.3】P1125 [NOIP 2008 提高组] 笨小猴
题目描述
给出一个单词(由不超过 $100$ 个小写字母组成),假设 $maxn$ 是单词中出现次数最多的字母的出现次数,$minn$ 是单词中出现次数最少的字母的出现次数,如果 $maxn-minn$ 是一个质数,那么笨小猴就认为这是个 $\text{Lucky Word}$,输出 Lucky Word,然后在第二行输出 maxn-minn 的值;否则输出 No Answer,第二行输出 0
分析
考虑 计数排序思想,读入一个字母,用 $f[]$ 数组记录 $a \sim z$ 字母出现的数量,可以转换成 $0 \sim 25$ 的数字但是直接存更方便,$f[]$ 数组的大小为 $129$,这是 ASCII 表 非拓展字符的值域,随后使用 打擂台 思想寻找出现 次数最多的字母 和 非 $0$ 的最少,判断差是否为质数
bool isPrime(int n) { // 判断质数
    // 小于2的数不是质数
    if (n < 2) {
        return false;
    }

    // 从2到n-1逐个试除
    for (int i = 2; i < n; i++) {
        if (n % i == 0) {
            return false;  // 能被整除,是合数
        }
    }

    return true;  // 都不能整除,是质数
}
[collapse status="false" title="判断质数极限方法"]
inline uint64_t isqrt_u64(uint64_t n) { // 判断质数:小数字用试除(快),大数字用 Miller-Rabin(更快)
    if (n < 2) return n;
    uint64_t x = n;
    uint64_t y = (x + 1) >> 1;
    while (y < x) {
        x = y;
        y = (x + n / x) >> 1;
    }
    return x;
}

inline uint64_t mod_mul(uint64_t a, uint64_t b, uint64_t mod) {
    return (__uint128_t)a * b % mod;
}

inline uint64_t mod_pow(uint64_t a, uint64_t d, uint64_t mod) {
    uint64_t res = 1;
    while (d) {
        if (d & 1) res = mod_mul(res, a, mod);
        a = mod_mul(a, a, mod);
        d >>= 1;
    }
    return res;
}

bool isPrime(uint64_t n) {
    if (n < 2) return false;
    if (n == 2 || n == 3 || n == 5 || n == 7) return true;
    if ((n & 1) == 0 || n % 3 == 0 || n % 5 == 0 || n % 7 == 0) return false;

    // 小数字用试除(更快)
    if (n < 1000000000ULL) {
        uint64_t limit = isqrt_u64(n);
        for (uint64_t i = 11; i <= limit; ) {
            if (n % i == 0) return false;
            if (n % (i + 2) == 0) return false;
            if (n % (i + 6) == 0) return false;
            if (n % (i + 8) == 0) return false;
            if (n % (i + 12) == 0) return false;
            if (n % (i + 18) == 0) return false;
            if (n % (i + 20) == 0) return false;
            if (n % (i + 26) == 0) return false;
            i += 30;
        }
        return true;
    }

    // 大数字用 Miller-Rabin
    uint64_t d = n - 1;
    int s = 0;
    while ((d & 1) == 0) {
        d >>= 1;
        s++;
    }

    static const uint64_t bases[] = {2, 3, 5, 7, 11, 13, 17, 19, 23, 29, 31, 37};
    for (uint64_t a : bases) {
        if (a >= n) continue;
        uint64_t x = mod_pow(a, d, n);
        if (x == 1 || x == n - 1) continue;
        bool composite = true;
        for (int r = 1; r < s; r++) {
            x = mod_mul(x, x, n);
            if (x == n - 1) {
                composite = false;
                break;
            }
        }
        if (composite) return false;
    }
    return true;
}
具体内容不解释,自行搜索
上述内容取自 Deepseek V4 Pro
[/collapse]
如果有需要,可以封装成 namespace
参考代码
同样取自 深入浅出
#include <stdio.h>
#include <iostream.h>
#include <string.h>
using namespace std;

int main() {
    char a[110];
    int ans[26] = {0};              // ans[0] 到 ans[25] 分别代表 'a' 到 'z' 出现的次数,注意要初始化
    int l, mmax, mmin, delta;       // 字符长度,出现次数最多的字母出现次数和出现次数最少的字母出现次数,以及差值

    scanf("%s", a);
    l = strlen(a);

    for (int i = 0; i < l; i++) {
        ans[a[i] - 'a']++;          // 统计增加某个字母的数量
    }

    mmax = 0;
    mmin = 10000;                   // 最大最小值初始化

    for (int i = 0; i < 26; i++) {  // 寻找每个字母的最大值和最小值
        if (ans[i] > mmax) {
            mmax = ans[i];          // 如果超过最大值
        }
        if (ans[i] != 0 && ans[i] < mmin) {
            mmin = ans[i];          // 如果小于最小值,但是不能为 0
        }
    }

    delta = mmax - mmin;

    if (delta == 0 || delta == 1) { // 质数特判
        printf("No Answer\n0\n");
        return 0;
    }

    for (int h = 2; h * h <= delta; h++) {  // 枚举质数
        if (delta % h == 0) {
            printf("No Answer\n0\n");       // 直接输出答案并退出程序
            return 0;
        }
    }

    printf("Lucky Word\n%d\n", mmax - mmin);
    return 0;
}
string 头文件
这是一个前所未有的新头文件,它包含了一些新的头文件
这里有一些新的用法,供读者参考:
size_t strlen(const char *s);求char数组的长度,将要求长度的数组放进()之中,在大部分情况下被typedef定义为unsigned int,这也是为什么你在用for(int i=0;i<strlen(s);i++)会报 Warn 的原因,类型不同char *strcpy(char *dest, const char *src);将*str复制到*dest,即复制字符串,返回值一般无用int strcmp(const char *s1, const char *s2);判断两个字符数组是否相同,下面是返回值及意义- $=0$ 是 $s1$ 和 $s2$ 完全相同
- $\lt 0$ 是 $s1$ 小于 $s2$
- $\gt 0$ 是 $s1$ 大于 $s2$
字符数组不能直接复制一个字符串,因为字符数组中的数组名也只是一个数组名,上面提供的函数可能会有作用
但是 char a[100]="TropicalFish"; 是合法的
【题目样本 1.4】P1957 口算练习题
题目描述
https://www.luogu.com.cn/problem/P1957
王老师收集了 $i(i \leq 50)$ 道学生经常做错的口算题,并且想整理编写成一份练习
王老师希望尽量减少输入的工作量,比如 $5+8$ 的算式最好只输入 5 和 8,输出的结果要尽量详细以方便后期排版使用
对于上述输入进行处理后,输出 5+8=13 以及该算式的总长度 6
输入数据第 $1$ 行是 $i$,接着的 $i$ 行是需要输入的算式,每行可能有 $3$ 个数据或两个数据
- 若该行是 $3$ 个数据,则第一个数据表示运算类型,
a表示加法运算,b表示减法运算,c表示乘法运算,接着的两个数据表示参加运算的运算数 - 若该行是两个数据,则表示本题的运算类型与上一题的运算类型相同,而这两个数据为运算数
分析
笔者写到这里的时候,就比较随意了,因为本题没有多大的实际意义,一般地,它只是作为一道相对复杂的应用题/模拟题
在本题中 switch-case 相对于 if-else 更加方便
sscanf 与 sprintf
他们的作用都是从字符串中读入/写出
请区别 scanf 与 printf
参考代码
#include <iostream>
#include <cstdio>
#include <cstring>
using namespace std;
int main() {
    int n, a, b, c;
    char last, s[20], ans[20];
    scanf("%d\n", &n);
    while (n--) {
        fgets(s, sizeof(s), stdin); // 读入一行
        if (s[0] == 'a' || s[0] == 'b' || s[0] == 'c')
            last = s[0], s[0] = ' '; // 获取计算符号,并替换为空格
        sscanf(s, "%d %d", &a, &b); // 从这个字符串里面读入两个数 a 和 b
        switch (last) {
            case'a': c = a + b; sprintf(ans, "%d+%d=%d", a, b, c); break; // +
            case'b': c = a - b; sprintf(ans, "%d-%d=%d", a, b, c); break; // -
            case'c': c = a * b; sprintf(ans, "%d*%d=%d", a, b, c); break; // ×
        }
        printf("%s\n%d\n", ans, strlen(ans)); // 输出
    }
    return 0;
}
上面的代码同样改编于 深入浅出
2 string 字符串
从 C 风格字符串到 C++ STL 的 string 类型
$$ \left\{ \begin{array}{l} \textbf{C++ 标准库} \\ \left\{ \begin{array}{l} \textbf{STL(标准模板库)} \\ \left\{ \begin{array}{l} \text{容器} \left\{ \begin{array}{l} \text{vector} \\ \text{list} \\ \text{map} \\ \boxed{\text{string}} \quad \text{(核心问题)} \end{array} \right. \\ \text{迭代器} \\ \text{算法} \\ \text{适配器} \\ \text{分配器} \\ \text{函数对象} \end{array} \right. \\ \text{其他组件} \left\{ \begin{array}{l} \text{I/O 流} \\ \text{异常处理} \\ \text{内存管理} \end{array} \right. \end{array} \right. \end{array} \right. $$
上面的思维导图由 Deepseek V4 Pro 生成,它体现了 string 与 STL 的主要关系
很明显的,使用 C 语言的字符数字有很多不便(char 是属于 C 语言的),比如 不能:
- 弹性变化长度
- 直接赋值
- 直接复制
- 有数组越界的风险(
gets)
好消息是,C++ 中提出了 STL 这一概念,即 标准模板库,将很多有用的功能进行了封装,直接就可以用,不需要重新开发这些功能,我们为 2017 年的 OI 选手默哀,已经封装的功能包括但不限于:
- 栈(
stack) - 队列(
queue) - 排序(
sort)
总的来说,封装了容器、算法、其他功能,现在,我们会使用 string 解决字符串问题
【题目样本 2.1】P5015 [NOIP 2018 普及组] 标题统计
题目描述
https://www.luogu.com.cn/problem/P5015
凯凯刚写了一篇美妙的作文,请统计这篇作文的标题中有多少个字符
注意:标题中可能包含大、小写英文字母、数字字符、空格和换行符,且字符串中的字符和空格数总和不超过 $5$
统计标题字符数时,空格和换行符不计算在内
分析
因为使用 cin 读入字符串时会忽略空格,并且读到 空格 或者 换行符 就停止了,所以可以将读入写进 while() 中,每次读入一个字符串,把长度加入答案即可
至于读入整行,会在 【题目样本 2.3】 中给出方法
参考代码
#include <iostream>
#include <string>
using namespace std;

int main() {
    string s;
    int ans = 0;
    while (cin >> s)
        ans += s.length();
    cout << ans << endl;
    return 0;
}
深入浅出
string:字符串的加强版数据类型
这里没使用 char,而是使用了一种新的数据类型 string,一个 string 类型的变量可以用来存储一个字符串,还可以把这个字符串当成一个整体的处理,string 的功能包括但不限于:
- 赋值
- 拼接
- 裁剪
char 毕竟是个数组,能做到这些就很烦了
输人时使用 cin 语句,不断读入字符串
当发现读入文件读完后(遇到 EOF,可以按 Ctrl+Z 组合键),cin>>s 本身就会返回 $0$,中断 while 语句,结束读入
这里的 $s$ 变量可以被认为是一个“加强版“的字符数组,可以使用 s.length()(s.size()) 来直接查询字符串 $s$ 的长度,也可以和字符数组一样使用 $s[0]$ 来查询这个字符串最开头的字符是什么
更厉害的是,string 类型的字符串可以直接拿来赋值、拼接操作,比如 s=s+s 就是将两个字符串 $s$ 拼接在一起,其结果赋值回 $s$ 的意思,请注意,这里提到的代码操作的时间复杂度是 $O(n)$,建议写 s+=s(s.append(s) 会在 【题目样本 2.2】 提到)
上述描述操作的便利性可不是字符数组可以比较的
【题目样本 2.2】P5734 文字处理软件
题目描述
https://www.luogu.com.cn/problem/P5734
现在需要开发一款文字处理软件
最开始时输入一个字符串(不超过 $100$ 个字符)作为初始文档
可以认为文档开头是第 $0$ 个字符,需要支持以下操作
1 str: 后接插入,在文档后面插入字符串 $\text{str}$,并输出文档的字符串2 a b: 截取文档部分,只保留文档中从第 $a$ 个字符起 $b$ 个字符,并输出文档的字符串3 a str: 插入片段,在文档中第 $a$ 个字符前面插入字符串 $\text{str}$,并输出文档的字符串4 str: 查找子串,查找字符串 $\text{str}$ 在文档中最先出现的位置并输出;如果找不到输出-1
为了简化问题,规定初始的文档和每次操作中的 $\text{str}$ 都不含有空格或换行
最多会有 $q (q \leq 100)$ 次操作
例如输入数据是:
4
ILove
1 Luogu
2 5 5
3 3 guGugu
4 gu
那么输出数据是:
ILoveLuogu
Luogu
LuoguGuuguugu
3
保证每次操作输入的字符串长度不超过 $100$ 且输入合法(($2$) 和 ($3$) 操作不会越界)
分析
string 需要头文件 string,方法包括但不限于:
string s: 定义一个名字为 $s$ 的字符串变量s += str或s.append(str): 在字符串 $s$ 后面拼接字符串 $\text{str}$s < str: 比较字符串 $s$ 的字典序是否在字符串 $\text{str}$ 的字典序之前s.size()或s.length(): 得到字符串 $s$ 的长度s.substr(pos, len): 截取字符串 $s$,从第 $pos$ 个位置开始 $len$ 个字符,并返回这个字符串s.insert(pos, str): 在字符串 $s$ 的第 $pos$ 个字符之前,插入字符串 $\text{str}$,并返回这个字符串s.find(str, [pos]): 在字符串 $s$ 中从第 $pos$ 个字符开始寻找 $\text{str}$,并返回位置,如果找不到返回 $-1$,$pos$ 可以省略,默认值是 $0$
灵活地运用上面的这些办法,可以使笔者更好地玩此题目
额外需要注意:s.find() 在 无法找到 时,会返回 string::npos,因此,你可以利用 s.find("bqiu")!=string::npos 判断 $s$ 中是否包含 $\text{bqiu}$,如果包含,返回 $1$,反之 $0$
string 的赋值
string a, b;
a="bqiu";
b=a;
上面的代码完全可以通过编译
但是 char 不行
【题目样本 2.3】P1308 [NOIP 2011 普及组] 统计单词数
题目描述
https://www.luogu.com.cn/problem/P1308
给定一个单词,请你输出它在给定的文章中出现的次数和第一次出现的位置
注意:匹配单词时,不区分大小写,但要求完全匹配,即给定单词必须与文章中的某一独立单词在不区分大小写的情况下完全相同,如果给定单词仅是文章中某一单词的一部分则不算匹配
分析
s.find() 是一个好东西
请注意,若 $s$ 为 $\text{to be or not to be is a question}$,在搜索 $\text{tion}$ 时,是否会检索到包含单词 question?
因此,你可以搜索 tion ,全字匹配
如果你这样做,你可能会意识到这个问题,如果 tion 在文章的结尾怎么办?
我们可以将 $s$ 的前后加上空格,即 s=' '+s+' ',这样就可以方便地解决这个问题
你太牛逼了
至于统计次数,你可以记下 find() 每次的返回值(位置),然后将位置作为参数继续查找,直到找到了 string::npos 就可以完成,这就是找到了多少次
getline:整行读入
为了方便地读取整行字符串,不用被 cin 的傻逼特性干扰,我们可以使用 getline() 函数,它的作用是将完整的一行的输入数据读入(到字符串中),一般地,它的用法是 getline(cin,<string_name>),<string_name> 指 string 字符串的名字
string:其他
下面的这一个代码,体现了 string 具有强大的扩展性
// string 转字符数组
char arr[10];
string s = "LUOGU";
int len = s.copy(arr, 9); // 最多允许复制 9 个字符,否则就越界了
arr[len] = '\0'; // 在末尾增加结束标记

// 或者
char arr[10];
string s = "LUOGU";
strcpy(arr, s.c_str()); // strncpy(arr, s.c_str(), 10);

// 字符数组转 string 就更简单了
char arr[10];
strcpy(arr, "LUOGU");
string s;
s = arr;
在这里表示对 DeepSeek 的尊敬!
3 freopen 文件操作
废话
直到现在为止,绝大部分的输入输出方式都是 标准输入输出,即 stdin 与 stdout
但在很多程序设计竞赛中,例如万恶的 CCF,它们要求使用文件输入输出,这种输入输出的方式,可以将硬盘上的文件读入到程序,将程序中的输出写入到硬盘,Linux 中的 < 和 > 重定向符号和这个是一个道理,如果你没有在竞赛中使用文件读写,你会获得一个最小的自然数的分数
题目样本
题目描述
https://www.tropical-fish.cn/usr/uploads/2026/08/1163827895.pdf
分析
这是 $\text{2024 CCF 非专业级软件能力认证 CSP-J/S 2024 第二轮认证}$ 的真题,请看试题卷 题目 A poker
这道题是一道非常简单的模拟题,参考代码如下
#include <bits/stdc++.h>
using namespace std;
int T,ans;
string s;
map <string,int> f;
int main(){
    cin>>T;
    while(T--){
        cin>>s;
        if(!f[s]) ans++,f[s]=1;
    }
    cout<<52-ans;
}
但是,如果读者直接将这个代码作为你的程序提交,你会获得 0 分的好成绩,请看试题卷第一页,它给出了 英文题目与子目录名、提交源程序文件名、可执行文件名、输入文件名、输出文件名,我们必须按照这个要求使用,虽然其他信息也相对重要,但是就文章标题而言,没那么重要
根据要求,我们应当将文件保存为 /<英文题目与子目录名>/<提交源程序文件名>,也就是 /poker/poker.cpp,然后,我们需要学会使用 freopen,下面是一个比较基础的用法
freopen("<read_file_name>","r",stdin);
freopen("<write_file_name>","w",stdout);
一般它会放在 main 函数的下面
也就是说,这题的代码需要改成:
#include <bits/stdc++.h>
using namespace std;
int T,ans;
string s;
map <string,int> f;
int main(){
    freopen("poker.in","r",stdin);
    freopen("poker.out","w",stdout);
    cin>>T;
    while(T--){
        cin>>s;
        if(!f[s]) ans++,f[s]=1;
    }
    cout<<52-ans;
}
本地运行后,发现程序一闪而过,啥也没有,反倒程序文件目录出现了一个 poker.out
既然它有读入文件,我们就应当给程序指定输入文件 poker.in,可以将题目的输入样例填写进去,运行,就发现 poker.out 有了答案
特别的,当程序读到 EOF 时,就会停止输入(相当于 ^Z)
如果是在一般的 Online Judge 提交上面的代码,会判为 WA,如果 OJ 没有要求指定输入输出文件名(一般没写就是没有),所以,我们应当删除 freopen 或者设为注释行
重要:文件名等信息必须与题目要求的一模一样!复制粘贴是一个好东西
Better
如果你为了在撰写代码时的快速,你可以只注释 输出文件 的 freopen,这样,在 输入文件 填写好测试数据之后,运行即可看到结果,相对于下面的方法快多了
- 都不注释,你需要每次看 输出文件,很烦
- 都注释,你需要每次粘贴样例,而且对于多组测试数据的试题更加繁琐
4 总结
$Thanks \space for \space reading.$