分类 编程 下的文章

字符串及文件读写

-1 检查浏览器渲染数学公式情况

因为笔者发布文章当天,本博客仍然存在 Latex 可能无法渲染的情况,下面是一个 Latex 示范:

$x$

  • 如果正常显示为衡水体 x,则代表读者的浏览器已经成功渲染了 Latex
  • 如果显示为 带有美元符号的 x 即 $x$(已除去换行符),则代表读者的浏览器没有成功渲染 Latex,读者可能需要刷新重试,如果刷新多次仍然无法渲染,请尝试换一个浏览器/网络环境

0 框架

你好,这里是 https://www.tropical-fish.cn/,本专题主要讲解 字符串及文件读写,感谢 深入浅出程序设计竞赛(基础篇) 提供的重要支持

这是 C++ 语法基础 的重要补充部分,包括了在 CCF 及其他系列比赛 获得 $\text{非}0$ 分数的方法,注意,这不是危言耸听

$$ \begin{aligned} &\textbf{字符串} \begin{cases} &\text{char}\\ &\text{string}\\ &\text{freopen} \end{cases} \end{aligned} $$

如上面的框架,笔者会介绍

  • 字符串的存储
  • 字符串的处理方法
  • STL 字符串
  • 文件输入输出

不废话了,现在开始!

1 char 字符数组

字符数组的 ASCII 本质与常用字符表

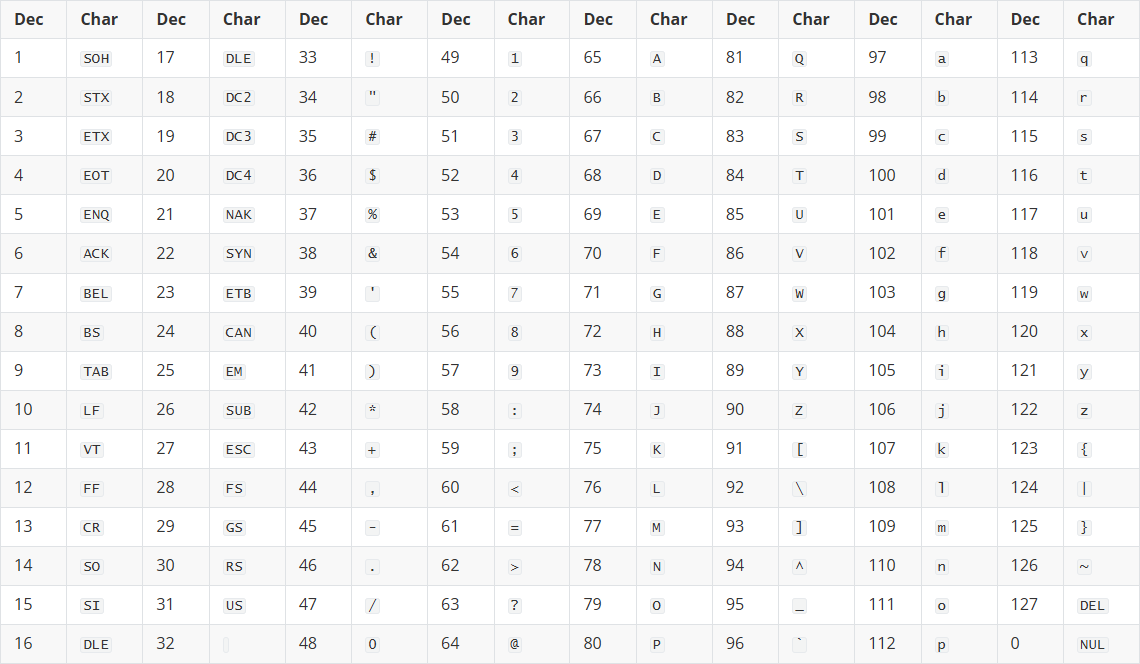
字符数组本质上和整数数组并没什么太大的区别,整数数字每一个下标存的是数字,字符数字存的是 字符(其实是 ASCII 码对应的数字),将这些字符存到数组里,便成为了一串字符,即 字符串,下面这张表是 ASCII 表,它们分别将 数字 对应了 字符,读者并不需要记忆全部的内容,仅需要记忆关键的键值,例如 0、A、a、 (空格),它们相对重要

DecCharDecCharDecCharDecCharDecCharDecCharDecCharDecChar
1SOH17DLE33!49165A81Q97a113q
2STX18DC234"50266B82R98b114r
3ETX19DC335#51367C83S99c115s
4EOT20DC436$52468D84T100d116t
5ENQ21NAK37%53569E85U101e117u
6ACK22SYN38&54670F86V102f118v
7BEL23ETB39'55771G87W103g119w
8BS24CAN40(56872H88X104h120x
9TAB25EM41)57973I89Y105i121y
10LF26SUB42*58:74J90Z106j122z
11VT27ESC43+59;75K91[107k123{
12FF28FS44,60<76L92\108l124``
13CR29GS45-61=77M93]109m125}
14SO30RS46.62>78N94^110n126~
15SI31US47/63?79O95_111o127DEL
16DLE32 48064@80P96 ` 112p0NUL

图片

其中的第 $0 \sim 31 \& 127$ 号字符是控制字符,第 $32$ 号字符是空格

在 OI 的场景下,一般只有第 $32 \sim 126$ 号元素起到了相对关键的作用

【题目样本 1.1】P5733 自动修正

题目描述

https://www.luogu.com.cn/problem/P5733

大家都知道,一些办公软件有自动将小写字母转换为大写的功能

输入一个长度不超过 $100$ 且不包括空格的字符串。要求将该字符串中的所有小写字母转换成大写字母并输出

例如输入 Luogu4!, 输出 LUOGU4!

做法 1

分析

既然单个字符可以使用 char 类型存储,那么存储一串字符就可以使用数组,我们可以定义一个数组 $s[]$,其中每一个下标都是字符类型,即 char s[100];,这样的 字符数组 就叫 字符串

读入字符串的办法大同小异

  1. 使用 scanf("%s",s);读入一个字符串,其中 %s 代表数据类型,即字符串,s 是定义的字符数组的名字
    至于为什么不需要取地址符 &,因为 s 是一个数组,这里的 s 在大多数表达式中会 自动转换为指向数组首元素的指针,即 &s[0],类型是 char*,仅此而已
  2. 使用 cin>>s;

请 特别注意 这一点,这两种读入方法只能读到空格、换行符、EOF(文章后面会有讲解),至于输入想要包含空格、换行符又想读入到同一个字符数组中,需要使用其他办法,文章后面同样会有讲解

参考代码

这段代码摘取至 深入浅出

#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    char s[110];
    scanf("%s", s); // 读入这个字符串,还可以使用 cin>>s; 语句
    for (int i = 0; s[i] != '\0'; i++) // s[i] != '\0' 也有别的方法获取,具体会在文章后面提到
        if ('a' <= s[i] && s[i] <= 'z') /* 如果这个字符在'a'到'z'中间,说明是小写字母 */
            s[i] -= 'a' - 'A'; // 把这个字母转换成对应的大写字母,减去偏移量
    printf("%s\n", s); // 输出这个字符串,还可以使用 cout<<s<<endl; 语句
    return 0;
}
ASCII 码偏移量

这本身并不是一个特有名词,反倒是一个通俗的用语,它的意思由 Deepseek V4 Pro 提供:利用 ASCII 码表中字母的连续编码,通过加减一个固定值(偏移量)来实现大小写转换或字符映射

至于能否听懂,那就因人而异了,下面是一段解释:

如果你认真看了上面的 ASCII 表,你应该会发现 小写字母的顺序和大写字母的顺序分别是按照字母表的顺序排列的,a-A 是小写字母和对应大写字母的 ASCII,这被通俗地认为为 偏移量,这在其他的场景中也有体现,为了缩短篇幅,这里不再阐释,请 特别注意,小写字母的 ASCII 码相对于大写字母大

那么就很好说了,上面的代码利用 if ('a' <= s[i] && s[i] <= 'z') 判断是否是小写字母,如果是,减去偏移量,这样得到的字母就是大写字母了

字符串存储与 \0 结束标记

这段字符串在字符数组中的存储方式如下图

s[0]s[1]s[2]s[3]s[4]s[5]s[6]s[7]
76 'L'117 'u'111 'o'103 'g'117 'u'52 '4'33 '!'0 '\0'

$s[]$ 中的每一个元素,都存储了一个不超过 $127$ 的整数,它们分别对应了 ASCII 编码中的字符

最开始的字符存在 $s[0]$,这个字符串虽然有且仅有 $7$ 个字符,但它却占用了 $8$ 个下标,即 $s[0] \sim s[7]$,字符串的末尾,存了一个特殊的字符 结束标记字符,它是 \0 ,也可能会有 \n 换行符,划掉的原因是因为笔者暂时没有找到任何明确的证据,这个结束标记被用于提示一个字符串的结束位置,它会在修改字符串的时候自动调整,一个例子,我们在用 cout<<s 的时候,结束标记就会告诉 cout 字符串已经没了,提一嘴,类似这样的 “特殊字符”,还有好几个,例如 \n(ASCII 表中可能被表示为 10,划掉的原因同上)

[collapse status="true" title="如何表示 \?"]

#include <bits/stdc++.h>
using namespace std;
int main(){
    cout<<"\\";
}

cout 内的第一个 \ 是转义符,转义后面的字符,因为第二个 \ 转义了 ",为了避免第二个 \ 被转义,所以只好用第一个 \ 转义第二个 \,这样第二个 \ 就不会转义 " 了

控制台输出:

PS D:\Users\Lenovo\Downloads\output> & .\'test.exe'
\

[/collapse]

做法 2

分析

当然,也不用一次直接读入整个字符串,可以每次只读入一个字符,判断是否需要处理,(处理后)输出这个字符即可

这里可以使用 getchar() 函数获取输入中的一个字符,如果你具有好奇心,你可以打开下面的折叠框

[collapse status="true" title="getchar() 的返回类型"]
getchar() 被定义于 cstdio 头文件,因此你需要在使用的时候导入这个头文件

答案:getchar() 返回 int 类型

至于为什么不返回 char,这是因为它要正确处理文件结尾标识符 EOF,后面你就能看见了,马上

因此,尽管你定义了一个 char 类型的变量,调用 getchar() 的时候他会自动根据 ASCII 表转换成 char 类型

这是一个例子:

#include <bits/stdc++.h>
using namespace std;
int main(){
    char s;
    cout<<"请键入一个字符:";
    s=getchar();
    cout<<"您键入的字符是:"<<s;
}
PS D:\Users\Lenovo\Downloads\output> & .\'test.exe'
请键入一个字符:s
您键入的字符是:s

[/collapse]

相应的,putchar() 用于输出一个字符

参考代码
#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    char s;
    while (1) {
        s = getchar(); // 每次调用 getchar() 函数,读入一个字符
        if (s == EOF)
            break;
        if ('a' <= s && s <= 'z') // 如果这个字符是小写字母
            s += 'A' - 'a'; // 把它转换成大写字母,这样写和上面是一样的
        putchar(s); // 调用 putchar() 函数,输出一个字符
    }
    return 0;
}
输入结束和 EOF

运行程序,结果发现无论输入什么,程序都没有反应,这是因为程序不认为输入已经结束了,继续在等待输入

遇到这种情况,输入完字符串后,按一下 Ctrl+Z 组合键,再按一次回车,就可以完成读入了

程序中读入一个字符都会判断是否读完了整个文件,如果文件被读完了,那么 getchar() 函数会返回 EOF(一个特殊的常量),即 End of File,这标志着读入已经结束了

在控制台中可以使用 Ctrl+Z 组合键(Windows 下)或者 Ctrl+D 组合键(Linux 下)来输入 EOF 标记提示程序输入已经完毕

至于一些教材使用的 gets() 函数将字符串读入字符数组,由于存在字符数组越界的风险, 已经不再建议使用,新的 C++11 标准更是删除了这个函数

而输出一个字符串还可以使用 puts() 方法,同时会自动输出换行,这倒是还能使用

如果您了解 HUSTOJ,您应该会遇到 #define gets(S) fgets(S,sizeof(S),stdin),仅仅提一嘴

【题目样本 1.2】P1914 凯撒密码

题目描述

https://www.luogu.com.cn/problem/P1914

凯撒密码是由原文字符串(由不超过 $50$ 个小写字母组成)中每个字母向后移动 $n$ 位形成的

z 的下一个字母是 a,如此循环

给出 $n$ 和移动前的原文字符串,请求出密码

分析

你可以导入这个字符串,一个一个处理,然后输出

你需要注意,你不能直接给每一位加上 $n$ 然后输出,因为可能会溢出,举一个例子,一个字符串是 $\text{z}$,$n=5$,如果直接加上答案就是 $\text{DEL}$($127$),如果不清楚这是什么,请翻阅前面的 ASCII 表,很明显答案是错的

所以,我们应该使用 s[i]-'a' 来计算和 $\text{a}$ 的偏移量,然后加上 $n$,得到目标字母的位置,一个例子,$\text{b}$ 这个字母移动 $4$ 位,就是第 $1$ 个字母($\text{a}$ 是第 $0$ 个字母)向右移动 $4$ 位,是第五个字母,即 $\text{f}$

为了要求这个位置始终在 $0 \sim 25$ 之间,我们应当把上一段计算除的结果对 $26$ 取模,后面还需要再加上 $\text{a}$,以还原为字母,记 s[i]-'a' 为 $t$,则计算的答案为 $(t \bmod 26)+\text{a}$

警告:读者应当理解 $a$ 与 $\text{a}$ 的区别,第一个指的是字母,第二个指的是值

参考代码

#include <iostream>
#include <cstdio>
using namespace std;
int main() {
    int n;
    char s[60];
    scanf("%d %s", &n, s);    // 读入字符串
    for (int i = 0; s[i] != '\0'; i++)
    putchar((s[i] - 'a' + n) % 26 + 'a');    // 计算偏移量并还原
    return 0;
}

【题目样本 1.3】P1125 [NOIP 2008 提高组] 笨小猴

题目描述

给出一个单词(由不超过 $100$ 个小写字母组成),假设 $maxn$ 是单词中出现次数最多的字母的出现次数,$minn$ 是单词中出现次数最少的字母的出现次数,如果 $maxn-minn$ 是一个质数,那么笨小猴就认为这是个 $\text{Lucky Word}$,输出 Lucky Word,然后在第二行输出 maxn-minn 的值;否则输出 No Answer,第二行输出 0

分析

考虑 计数排序思想,读入一个字母,用 $f[]$ 数组记录 $a \sim z$ 字母出现的数量,可以转换成 $0 \sim 25$ 的数字但是直接存更方便,$f[]$ 数组的大小为 $129$,这是 ASCII 表 非拓展字符的值域,随后使用 打擂台 思想寻找出现 次数最多的字母 和 非 $0$ 的最少,判断差是否为质数

bool isPrime(int n) { // 判断质数
    // 小于2的数不是质数
    if (n < 2) {
        return false;
    }
    
    // 从2到n-1逐个试除
    for (int i = 2; i < n; i++) {
        if (n % i == 0) {
            return false;  // 能被整除,是合数
        }
    }
    
    return true;  // 都不能整除,是质数
}

[collapse status="false" title="判断质数极限方法"]

inline uint64_t isqrt_u64(uint64_t n) { // 判断质数:小数字用试除(快),大数字用 Miller-Rabin(更快)
    if (n < 2) return n;
    uint64_t x = n;
    uint64_t y = (x + 1) >> 1;
    while (y < x) {
        x = y;
        y = (x + n / x) >> 1;
    }
    return x;
}

inline uint64_t mod_mul(uint64_t a, uint64_t b, uint64_t mod) {
    return (__uint128_t)a * b % mod;
}

inline uint64_t mod_pow(uint64_t a, uint64_t d, uint64_t mod) {
    uint64_t res = 1;
    while (d) {
        if (d & 1) res = mod_mul(res, a, mod);
        a = mod_mul(a, a, mod);
        d >>= 1;
    }
    return res;
}

bool isPrime(uint64_t n) {
    if (n < 2) return false;
    if (n == 2 || n == 3 || n == 5 || n == 7) return true;
    if ((n & 1) == 0 || n % 3 == 0 || n % 5 == 0 || n % 7 == 0) return false;
    
    // 小数字用试除(更快)
    if (n < 1000000000ULL) {
        uint64_t limit = isqrt_u64(n);
        for (uint64_t i = 11; i <= limit; ) {
            if (n % i == 0) return false;
            if (n % (i + 2) == 0) return false;
            if (n % (i + 6) == 0) return false;
            if (n % (i + 8) == 0) return false;
            if (n % (i + 12) == 0) return false;
            if (n % (i + 18) == 0) return false;
            if (n % (i + 20) == 0) return false;
            if (n % (i + 26) == 0) return false;
            i += 30;
        }
        return true;
    }
    
    // 大数字用 Miller-Rabin
    uint64_t d = n - 1;
    int s = 0;
    while ((d & 1) == 0) {
        d >>= 1;
        s++;
    }
    
    static const uint64_t bases[] = {2, 3, 5, 7, 11, 13, 17, 19, 23, 29, 31, 37};
    for (uint64_t a : bases) {
        if (a >= n) continue;
        uint64_t x = mod_pow(a, d, n);
        if (x == 1 || x == n - 1) continue;
        bool composite = true;
        for (int r = 1; r < s; r++) {
            x = mod_mul(x, x, n);
            if (x == n - 1) {
                composite = false;
                break;
            }
        }
        if (composite) return false;
    }
    return true;
}

具体内容不解释,自行搜索

上述内容取自 Deepseek V4 Pro
[/collapse]

如果有需要,可以封装成 namespace

参考代码

同样取自 深入浅出

#include <stdio.h>
#include <iostream.h>
#include <string.h>
using namespace std;

int main() {
    char a[110];
    int ans[26] = {0};              // ans[0] 到 ans[25] 分别代表 'a' 到 'z' 出现的次数,注意要初始化
    int l, mmax, mmin, delta;       // 字符长度,出现次数最多的字母出现次数和出现次数最少的字母出现次数,以及差值

    scanf("%s", a);
    l = strlen(a);

    for (int i = 0; i < l; i++) {
        ans[a[i] - 'a']++;          // 统计增加某个字母的数量
    }

    mmax = 0;
    mmin = 10000;                   // 最大最小值初始化

    for (int i = 0; i < 26; i++) {  // 寻找每个字母的最大值和最小值
        if (ans[i] > mmax) {
            mmax = ans[i];          // 如果超过最大值
        }
        if (ans[i] != 0 && ans[i] < mmin) {
            mmin = ans[i];          // 如果小于最小值,但是不能为 0
        }
    }

    delta = mmax - mmin;

    if (delta == 0 || delta == 1) { // 质数特判
        printf("No Answer\n0\n");
        return 0;
    }

    for (int h = 2; h * h <= delta; h++) {  // 枚举质数
        if (delta % h == 0) {
            printf("No Answer\n0\n");       // 直接输出答案并退出程序
            return 0;
        }
    }

    printf("Lucky Word\n%d\n", mmax - mmin);
    return 0;
}

string 头文件

这是一个前所未有的新头文件,它包含了一些新的头文件

这里有一些新的用法,供读者参考:

  • size_t strlen(const char *s); 求 char 数组的长度,将要求长度的数组放进 () 之中,在大部分情况下被 typedef 定义为 unsigned int,这也是为什么你在用 for(int i=0;i<strlen(s);i++) 会报 Warn 的原因,类型不同
  • char *strcpy(char *dest, const char *src); 将 *str 复制到 *dest,即复制字符串,返回值一般无用
  • int strcmp(const char *s1, const char *s2); 判断两个字符数组是否相同,下面是返回值及意义

    • $=0$ 是 $s1$ 和 $s2$ 完全相同
    • $\lt 0$ 是 $s1$ 小于 $s2$
    • $\gt 0$ 是 $s1$ 大于 $s2$

字符数组不能直接复制一个字符串,因为字符数组中的数组名也只是一个数组名,上面提供的函数可能会有作用

但是 char a[100]="TropicalFish"; 是合法的

【题目样本 1.4】P1957 口算练习题

题目描述

https://www.luogu.com.cn/problem/P1957

王老师收集了 $i(i \leq 50)$ 道学生经常做错的口算题,并且想整理编写成一份练习

王老师希望尽量减少输入的工作量,比如 $5+8$ 的算式最好只输入 5 和 8,输出的结果要尽量详细以方便后期排版使用

对于上述输入进行处理后,输出 5+8=13 以及该算式的总长度 6

输入数据第 $1$ 行是 $i$,接着的 $i$ 行是需要输入的算式,每行可能有 $3$ 个数据或两个数据

  • 若该行是 $3$ 个数据,则第一个数据表示运算类型,a 表示加法运算,b 表示减法运算,c 表示乘法运算,接着的两个数据表示参加运算的运算数
  • 若该行是两个数据,则表示本题的运算类型与上一题的运算类型相同,而这两个数据为运算数

分析

笔者写到这里的时候,就比较随意了,因为本题没有多大的实际意义,一般地,它只是作为一道相对复杂的应用题/模拟题

在本题中 switch-case 相对于 if-else 更加方便

sscanf 与 sprintf

他们的作用都是从字符串中读入/写出

请区别 scanf 与 printf

参考代码

#include <iostream>
#include <cstdio>
#include <cstring>
using namespace std;
int main() {
    int n, a, b, c;
    char last, s[20], ans[20];
    scanf("%d\n", &n);
    while (n--) {
        fgets(s, sizeof(s), stdin); // 读入一行
        if (s[0] == 'a' || s[0] == 'b' || s[0] == 'c')
            last = s[0], s[0] = ' '; // 获取计算符号,并替换为空格
        sscanf(s, "%d %d", &a, &b); // 从这个字符串里面读入两个数 a 和 b 
        switch (last) {
            case'a': c = a + b; sprintf(ans, "%d+%d=%d", a, b, c); break; // +
            case'b': c = a - b; sprintf(ans, "%d-%d=%d", a, b, c); break; // -
            case'c': c = a * b; sprintf(ans, "%d*%d=%d", a, b, c); break; // ×
        }
        printf("%s\n%d\n", ans, strlen(ans)); // 输出
    }
    return 0;
}

上面的代码同样改编于 深入浅出

2 string 字符串

从 C 风格字符串到 C++ STL 的 string 类型

$$ \left\{ \begin{array}{l} \textbf{C++ 标准库} \\ \left\{ \begin{array}{l} \textbf{STL(标准模板库)} \\ \left\{ \begin{array}{l} \text{容器} \left\{ \begin{array}{l} \text{vector} \\ \text{list} \\ \text{map} \\ \boxed{\text{string}} \quad \text{(核心问题)} \end{array} \right. \\ \text{迭代器} \\ \text{算法} \\ \text{适配器} \\ \text{分配器} \\ \text{函数对象} \end{array} \right. \\ \text{其他组件} \left\{ \begin{array}{l} \text{I/O 流} \\ \text{异常处理} \\ \text{内存管理} \end{array} \right. \end{array} \right. \end{array} \right. $$

上面的思维导图由 Deepseek V4 Pro 生成,它体现了 string 与 STL 的主要关系

很明显的,使用 C 语言的字符数字有很多不便(char 是属于 C 语言的),比如 不能:

  • 弹性变化长度
  • 直接赋值
  • 直接复制
  • 有数组越界的风险(gets)

好消息是,C++ 中提出了 STL 这一概念,即 标准模板库,将很多有用的功能进行了封装,直接就可以用,不需要重新开发这些功能,我们为 2017 年的 OI 选手默哀,已经封装的功能包括但不限于:

  • 栈(stack)
  • 队列(queue)
  • 排序(sort)

总的来说,封装了容器、算法、其他功能,现在,我们会使用 string 解决字符串问题

【题目样本 2.1】P5015 [NOIP 2018 普及组] 标题统计

题目描述

https://www.luogu.com.cn/problem/P5015

凯凯刚写了一篇美妙的作文,请统计这篇作文的标题中有多少个字符

注意:标题中可能包含大、小写英文字母、数字字符、空格和换行符,且字符串中的字符和空格数总和不超过 $5$

统计标题字符数时,空格和换行符不计算在内

分析

因为使用 cin 读入字符串时会忽略空格,并且读到 空格 或者 换行符 就停止了,所以可以将读入写进 while() 中,每次读入一个字符串,把长度加入答案即可

至于读入整行,会在 【题目样本 2.3】 中给出方法

参考代码

#include <iostream>
#include <string>
using namespace std;

int main() {
    string s;
    int ans = 0;
    while (cin >> s)
        ans += s.length();
    cout << ans << endl;
    return 0;
}

深入浅出

string:字符串的加强版数据类型

这里没使用 char,而是使用了一种新的数据类型 string,一个 string 类型的变量可以用来存储一个字符串,还可以把这个字符串当成一个整体的处理,string 的功能包括但不限于:

  • 赋值
  • 拼接
  • 裁剪

char 毕竟是个数组,能做到这些就很烦了

输人时使用 cin 语句,不断读入字符串

当发现读入文件读完后(遇到 EOF,可以按 Ctrl+Z 组合键),cin>>s 本身就会返回 $0$,中断 while 语句,结束读入

这里的 $s$ 变量可以被认为是一个“加强版“的字符数组,可以使用 s.length()(s.size()) 来直接查询字符串 $s$ 的长度,也可以和字符数组一样使用 $s[0]$ 来查询这个字符串最开头的字符是什么

更厉害的是,string 类型的字符串可以直接拿来赋值、拼接操作,比如 s=s+s 就是将两个字符串 $s$ 拼接在一起,其结果赋值回 $s$ 的意思,请注意,这里提到的代码操作的时间复杂度是 $O(n)$,建议写 s+=s(s.append(s) 会在 【题目样本 2.2】 提到)

上述描述操作的便利性可不是字符数组可以比较的

【题目样本 2.2】P5734 文字处理软件

题目描述

https://www.luogu.com.cn/problem/P5734

现在需要开发一款文字处理软件

最开始时输入一个字符串(不超过 $100$ 个字符)作为初始文档

可以认为文档开头是第 $0$ 个字符,需要支持以下操作

  1. 1 str: 后接插入,在文档后面插入字符串 $\text{str}$,并输出文档的字符串
  2. 2 a b: 截取文档部分,只保留文档中从第 $a$ 个字符起 $b$ 个字符,并输出文档的字符串
  3. 3 a str: 插入片段,在文档中第 $a$ 个字符前面插入字符串 $\text{str}$,并输出文档的字符串
  4. 4 str: 查找子串,查找字符串 $\text{str}$ 在文档中最先出现的位置并输出;如果找不到输出 -1

为了简化问题,规定初始的文档和每次操作中的 $\text{str}$ 都不含有空格或换行

最多会有 $q (q \leq 100)$ 次操作

例如输入数据是:

4
ILove
1 Luogu
2 5 5
3 3 guGugu
4 gu

那么输出数据是:

ILoveLuogu
Luogu
LuoguGuuguugu
3

保证每次操作输入的字符串长度不超过 $100$ 且输入合法(($2$) 和 ($3$) 操作不会越界)

分析

string 需要头文件 string,方法包括但不限于:

  1. string s: 定义一个名字为 $s$ 的字符串变量
  2. s += str 或 s.append(str): 在字符串 $s$ 后面拼接字符串 $\text{str}$
  3. s < str: 比较字符串 $s$ 的字典序是否在字符串 $\text{str}$ 的字典序之前
  4. s.size() 或 s.length(): 得到字符串 $s$ 的长度
  5. s.substr(pos, len): 截取字符串 $s$,从第 $pos$ 个位置开始 $len$ 个字符,并返回这个字符串
  6. s.insert(pos, str): 在字符串 $s$ 的第 $pos$ 个字符之前,插入字符串 $\text{str}$,并返回这个字符串
  7. s.find(str, [pos]): 在字符串 $s$ 中从第 $pos$ 个字符开始寻找 $\text{str}$,并返回位置,如果找不到返回 $-1$,$pos$ 可以省略,默认值是 $0$

灵活地运用上面的这些办法,可以使笔者更好地玩此题目

额外需要注意:s.find() 在 无法找到 时,会返回 string::npos,因此,你可以利用 s.find("bqiu")!=string::npos 判断 $s$ 中是否包含 $\text{bqiu}$,如果包含,返回 $1$,反之 $0$

string 的赋值

string a, b;
a="bqiu";
b=a;

上面的代码完全可以通过编译

但是 char 不行

【题目样本 2.3】P1308 [NOIP 2011 普及组] 统计单词数

题目描述

https://www.luogu.com.cn/problem/P1308

给定一个单词,请你输出它在给定的文章中出现的次数和第一次出现的位置

注意:匹配单词时,不区分大小写,但要求完全匹配,即给定单词必须与文章中的某一独立单词在不区分大小写的情况下完全相同,如果给定单词仅是文章中某一单词的一部分则不算匹配

分析

s.find() 是一个好东西

请注意,若 $s$ 为 $\text{to be or not to be is a question}$,在搜索 $\text{tion}$ 时,是否会检索到包含单词 question?

因此,你可以搜索 tion ,全字匹配

如果你这样做,你可能会意识到这个问题,如果 tion 在文章的结尾怎么办?

我们可以将 $s$ 的前后加上空格,即 s=' '+s+' ',这样就可以方便地解决这个问题

你太牛逼了

至于统计次数,你可以记下 find() 每次的返回值(位置),然后将位置作为参数继续查找,直到找到了 string::npos 就可以完成,这就是找到了多少次

getline:整行读入

为了方便地读取整行字符串,不用被 cin 的傻逼特性干扰,我们可以使用 getline() 函数,它的作用是将完整的一行的输入数据读入(到字符串中),一般地,它的用法是 getline(cin,<string_name>),<string_name> 指 string 字符串的名字

string:其他

下面的这一个代码,体现了 string 具有强大的扩展性

// string 转字符数组
char arr[10];
string s = "LUOGU";
int len = s.copy(arr, 9); // 最多允许复制 9 个字符,否则就越界了
arr[len] = '\0'; // 在末尾增加结束标记

// 或者
char arr[10];
string s = "LUOGU";
strcpy(arr, s.c_str()); // strncpy(arr, s.c_str(), 10);

// 字符数组转 string 就更简单了
char arr[10];
strcpy(arr, "LUOGU");
string s;
s = arr;

在这里表示对 DeepSeek 的尊敬!

3 freopen 文件操作

废话

直到现在为止,绝大部分的输入输出方式都是 标准输入输出,即 stdin 与 stdout

但在很多程序设计竞赛中,例如万恶的 CCF,它们要求使用文件输入输出,这种输入输出的方式,可以将硬盘上的文件读入到程序,将程序中的输出写入到硬盘,Linux 中的 < 和 > 重定向符号和这个是一个道理,如果你没有在竞赛中使用文件读写,你会获得一个最小的自然数的分数

题目样本

题目描述

https://www.tropical-fish.cn/usr/uploads/2026/08/1163827895.pdf

分析

这是 $\text{2024 CCF 非专业级软件能力认证 CSP-J/S 2024 第二轮认证}$ 的真题,请看试题卷 题目 A poker

这道题是一道非常简单的模拟题,参考代码如下

#include <bits/stdc++.h>
using namespace std;
int T,ans;
string s;
map <string,int> f;
int main(){
    cin>>T;
    while(T--){
        cin>>s;
        if(!f[s]) ans++,f[s]=1;
    }
    cout<<52-ans;
}

但是,如果读者直接将这个代码作为你的程序提交,你会获得 0 分的好成绩,请看试题卷第一页,它给出了 英文题目与子目录名、提交源程序文件名、可执行文件名、输入文件名、输出文件名,我们必须按照这个要求使用,虽然其他信息也相对重要,但是就文章标题而言,没那么重要

根据要求,我们应当将文件保存为 /<英文题目与子目录名>/<提交源程序文件名>,也就是 /poker/poker.cpp,然后,我们需要学会使用 freopen,下面是一个比较基础的用法

freopen("<read_file_name>","r",stdin);
freopen("<write_file_name>","w",stdout);

一般它会放在 main 函数的下面

也就是说,这题的代码需要改成:

#include <bits/stdc++.h>
using namespace std;
int T,ans;
string s;
map <string,int> f;
int main(){
    freopen("poker.in","r",stdin);
    freopen("poker.out","w",stdout);
    cin>>T;
    while(T--){
        cin>>s;
        if(!f[s]) ans++,f[s]=1;
    }
    cout<<52-ans;
}

本地运行后,发现程序一闪而过,啥也没有,反倒程序文件目录出现了一个 poker.out

既然它有读入文件,我们就应当给程序指定输入文件 poker.in,可以将题目的输入样例填写进去,运行,就发现 poker.out 有了答案

特别的,当程序读到 EOF 时,就会停止输入(相当于 ^Z)

如果是在一般的 Online Judge 提交上面的代码,会判为 WA,如果 OJ 没有要求指定输入输出文件名(一般没写就是没有),所以,我们应当删除 freopen 或者设为注释行

重要:文件名等信息必须与题目要求的一模一样!复制粘贴是一个好东西

Better

如果你为了在撰写代码时的快速,你可以只注释 输出文件 的 freopen,这样,在 输入文件 填写好测试数据之后,运行即可看到结果,相对于下面的方法快多了

  • 都不注释,你需要每次看 输出文件,很烦
  • 都注释,你需要每次粘贴样例,而且对于多组测试数据的试题更加繁琐

4 总结

$Thanks \space for \space reading.$
排序(Round 1)

-1 检查浏览器渲染数学公式情况

因为笔者发布文章当天,本博客仍然存在 Latex 可能无法渲染的情况,下面是一个 Latex 示范:

$x$

  • 如果正常显示为衡水体 x,则代表读者的浏览器已经成功渲染了 Latex
  • 如果显示为 带有美元符号的 x 即 $x$(已除去换行符),则代表读者的浏览器没有成功渲染 Latex,读者可能需要刷新重试,如果刷新多次仍然无法渲染,请尝试换一个浏览器/网络环境

0 框架

在本文中,我将重点介绍 排序,感谢 深入浅出程序设计竞赛(基础篇) 提供重要支持,本文有一部分的内容是基于本书修改

排序 是在 OI 算法中重要的一部分,虽然大部分场景下都可以用 sort 解决(限于 bits/stdc++.h),但是掌握具体的内容还是必不可少的,相对于初赛而言

$$ \begin{aligned} &\textbf{排序(Round 1)} \begin{cases} &\text{计数排序}\\ &\text{选择排序、冒泡排序、插入排序}\\ &\text{快速排序}\\ &\text{排序算法的应用}\\ &\text{汇总}\\ \end{cases} \end{aligned} $$

1 计数排序

【题目样本 1.1】P1271【模板】排序

题目描述

https://www.luogu.com.cn/problem/P1271

学校正在选举学生会成员,有 $n(n \leq 999)$ 名候选人,每名候选人编号分别从 $1$ 到 $n$, 现在收集到了 $m(m \leq 200000)$ 张选票,每张选票都写了一个候选人编号

现在想把这些堆积如山的选票按照投票数字从小到大排序。输入 $n$ 和 $m$ 以及 $m$ 个选票上的数字,求出排序后的选票编号。例如,当有 $5$ 个候选人,$10$ 张选票分别是 $2、5、2、2、5、2、2、2、1、2$ 时,需要输出 1222222255

分析

这题本质有很多方法,但是由于是 计数排序,因此:

在投票区放上 $n$ 个投票箱,投票人支持谁就把票投入对应的投票箱中,投票后只须统计每个投票箱有几张选票,直接按照候选人编号取出来就可以完成排序操作

也不需要排序了

参考代码

#include <bits/stdc++.h>
using namespace std;
int n,m,i,j,x,f[100005];
int main(){
    cin>>n>>m;
    for(i=1;i<=m;i++) cin>>x,f[x]++;
    for(i=1;i<=n;i++) for(j=1;j<=f[i];j++) cout<<i<<" ";
}

这里倡导数组从 $1$ 开始存

只需要开一个大小不小于 $n$ 的数组作为票箱,依次读入选票,然后将选票号数加到对应的票箱中,最后按照每个票箱的数量输出候选人编号即可

在这个过程中,甚至不需要存储下每一张选票

在完成输入并计算时,$f[]$ 状态如下

$f$12345
17002

计数排序

这种排序方法被称为 计数排序

读入选票并统计的时间复杂度是 $O(m)$,输出选票的时间复杂度是 $O(m+n)$(第一层循环做 $n$ 次,$f[i]$ 至多为 $m$),空间复杂度是 $O(n)$(因为 $f[]$)

所以计数排序只能用于排序编号范围不是很大的数字,如果需要排序的数字要到 $10^9$,别说运行时间了,内存都无法存得下这么大的范围的数组

此外,如果希望将一些浮点数或者字符串进行排序,就没办法去建造合适的 投票箱,所以就不能使用这种算法了(把下标存成 $\text{浮点数} \times 10^\text{浮点数位数}$ 也是一个不错的选择)

也有改进方法,即 桶排序&基数排序,思路类似,但是复杂

无论是上段和计数,这些排序都是基于分类,并非比较

2 选择排序、冒泡排序、插入排序

【题目样本 2.1】数列排序

题目描述

输入 $n(n \leq 1000)$ 个数字 $a_i(a_i \leq 10^9)$, 将其从小到大排序后输出

分析

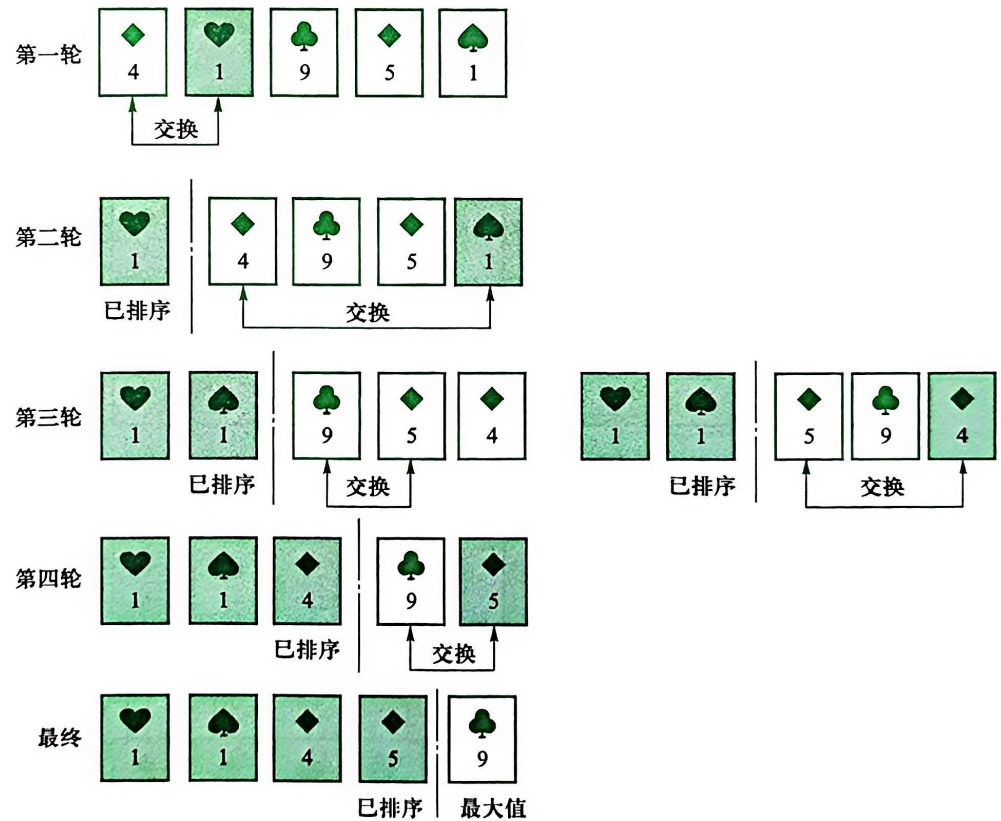
设有 $5$ 张纸牌,他们是 $4,1,9,5,1$,打牌时如何排序?

解法 1:选择排序

分析

求最大值:max()

求最小值:min()

求一序列最值:for(int i=1;i<n;i++) ma=max(ma,a[i]);,a[] 为序列,$n$ 为数量,$ma$ 存放最大值

核心思想:打擂台

如何联想到本题?

[collapse status="false" title="答案"]
从第一张牌到最后一张牌中找到最小的一张,放在最前面的位置;然后从第二张牌到最后一张牌中继续找到最小的一张,放到第二位……如此反复,就可以得到从小到大的序列
[/collapse]

这里有一张不错的图,来自 深入浅出,因此贴在这

若遇到大小相等的牌,continue

参考代码片段
for (int i = 0; i < n - 1; i++) {
    for (int j = i + 1; j < n; j++)
        if (a[j] < a[i]) {
            int p = a[i];
            a[i] = a[j];
            a[j] = p;
        }
}

解法 2:冒泡排序

分析

如果尝试把最大的一项放在后面,虽然可以倒过来使用选择排序,但是可以试试别的办法

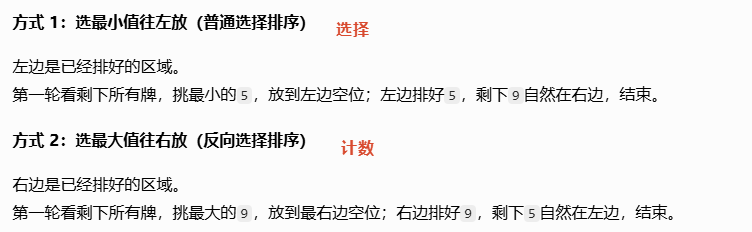
这里有一张图,来自 豆包,它打了一个类似于文章的比方,讲述了 选择排序 与 冒泡排序 的区别,前情提要是 现有扑克牌:9、5,要排成5、9

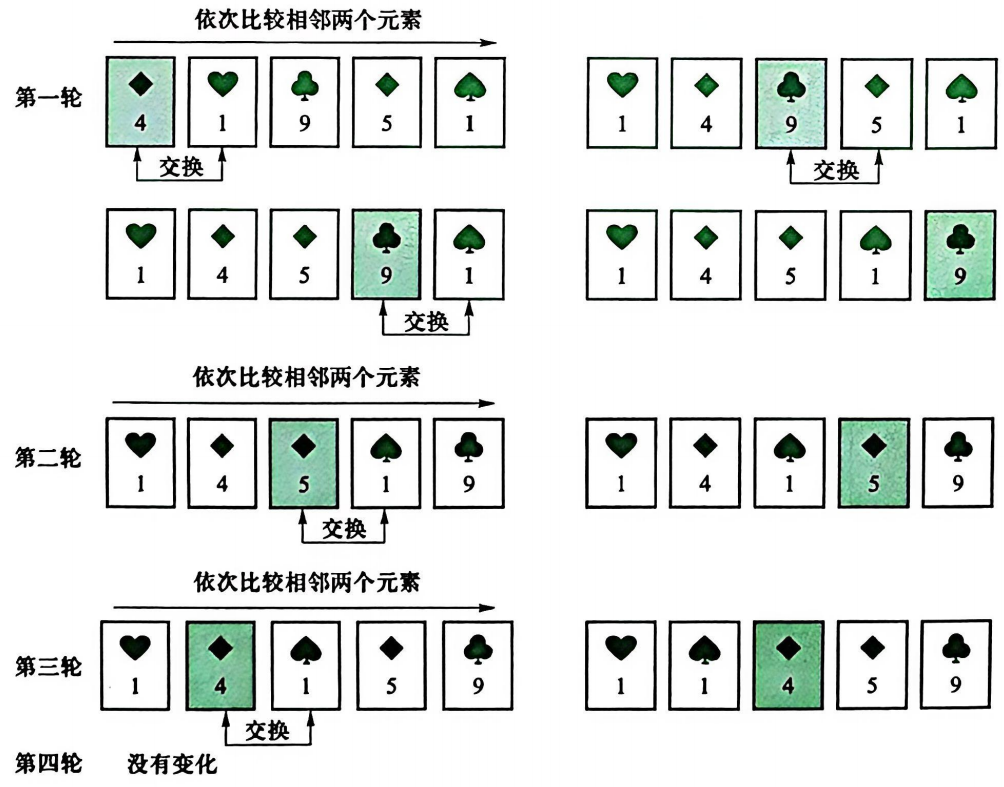
首先比较第 $1$ 张牌和第 $2$ 张牌,如果后面的牌比前面的牌小,那么就交换位置;然后比较第 $2$ 张牌和第 $3$ 张牌,同样保证第 $3$ 张牌要大于第 $2$ 张牌……依此类推, 直到比较最后一张牌和倒数第二张牌,这样就能保证最后面的一张牌是最大的一张了

继续进行新的一轮,利用上面一样的交换,但是需要注意的是,由于最后一张牌已经是手牌中最大的一张了,所以只需要比较到倒数第二张就行了

这一轮后结束后倒数第二张牌就是第二大的牌(当然,也有可能是并列最大)。经过 $n-1$ 轮排序后,就得到了有序的手牌

下图同样来自 深入浅出,用于理解

参考代码片段
for (int i = 0; i < n - 1; i++) {
    for (int j = 0; j < n - i - 1; j++)
        if (a[j] > a[j + 1]) {
            int p = a[j];
            a[j] = a[j + 1];
            a[j + 1] = p;
        }
}

[scode type="green"]
int p=a[j];a[j]=a[j+1];a[j+1]=p; 推荐用 swap(a[j],a[j+1]); 来取代,用于交换
[/scode]

解法 3:插入排序

分析

一种很形象的比喻

你在玩纸牌游戏的时候,从牌堆里面抽牌,抽到一张牌,放到你的手牌里,你是怎么保证手牌内的牌是有序的呢?

如果你能通过 Cloudflare 的人机验证,你应该会看看抓到牌的大小,再看看手牌,定位到合适的位置,插入

上面描述的过程,即 插入排序

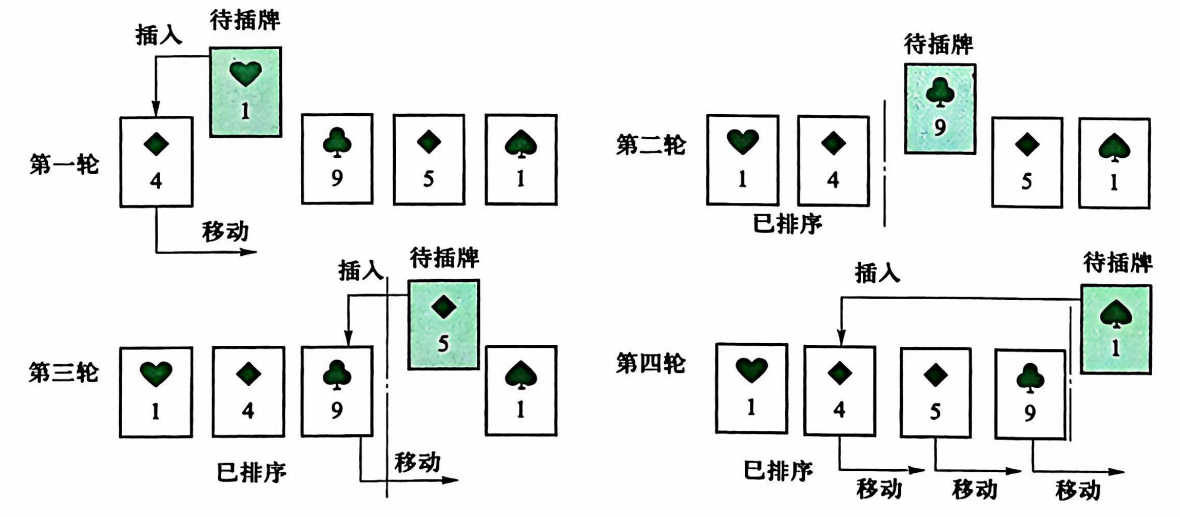
  1. 把手牌分为有序的和无序的两部分
  2. 最开始有序的就只有一张牌,也就是第一张
  3. 要把接下来的 无序区 中的一张牌(称为 待插牌 )插入到 有序区 中,就是从有序区的末尾开始往前比较,如果待插牌比正在比较的牌小,那么就把有序区的正在比较的牌往后面放一格,然后继续往前面进行比较,直到待插牌遇到不大于自己的牌或者成为第一个为止
  4. 这时,待插牌就可以填入留出来的缺口中。反复将无序区中的待插牌插入到有序区中,直到所有的牌都在有序区

同样的,这里有一张非常生动的图,供读者查阅

下面这是来自 深入浅出 的 插入排序 实现代码,进行了注释的补充

for(int i = 1; i < n; i++) {
    int now = a[i], j;          // 记录待插入元素,稍候会放进去
    for(j = i - 1; j >= 0; j--) // 一个很经典的模板:元素后移
        if(a[j] > now)
            a[j + 1] = a[j];    // 大于now的元素后移
        else
            break;
    a[j + 1] = now;             // 插入到正确位置
}

选择排序

为了加强读者的记忆,这里重新梳理一遍

解法 1 这种算法被称为 选择排序

从代码中可以看出有两重循环,读者可以自己计算一下已知 $n$ 的情况下一共需要比较的次数

选择排序的算法时间复杂度是 $O(n^2)$;由于只需要一个数组存下这些数字即可,空间复杂度是 $O(n)$

[collapse status="false" title="答案"]

$$ \frac{n(n-1)}{2} $$

[/collapse]

冒泡排序

解法 2 这种算法被称为 冒泡排序,在一轮中,最大的那张牌会一点一点地从左移动到右边,像冒泡泡一样

读者也可以计算一下排序的过程中需要进行几次比较

冒泡排序算法的时间复杂度也是 $O(n^2)$,空间复杂度也是 $O(n)$

冒泡排序相比于选择排序并没有实质性的改进

有一种冒泡排序的改良版叫作希尔排序,不是相邻位置的两个数字比较,而是比较距离更远的两个数字,虽然能略微优化一些复杂度,但依然不实用

猴子排序同样也是一种奇怪的办法

插入排序

这种算法叫作 插入排序

如果序列本来已经从小到大排序,那么每次无序区的待插牌都不会插进有序区中,而是紧贴在有序区后使有序区一直扩大,那么只需要 $n-1$ 次比较就可以完成算法流程

然而,如果序列是从大往小排序,那么每次插入都会将有序区中的所有牌往后面挪动一次,这样速度就非常慢了

讲时间复杂度一般会考虑最悲观的情况,所以插入排序的算法复杂度还是 $O(n^2)$,和选择排序、冒泡排序的复杂度一致,它们空间复杂度也是一样的

不过,如果能保证序列 基本有序 , 那么使用插入排序的效率可能会不错

不推荐在 Contest 中使用这些方法,耗时过久

笔者认为,学习这些是为了掌握原理,在第一轮比赛中获得较好的成绩,在历年的 OI 比赛中,有相当一部分的套题涉及了这个内容

3 快速排序

【题目样本 3.1】P1177 快速排序

题目描述

https://www.luogu.com.cn/problem/P1177

输入 $n(n \lt 10^5)$ 个数字 $a_i(a_i \lt 10^9)$,将其从小到大排序后输出

分析

这个数据量就很大了,插入排序、选择排序、冒泡排序都无法完成。这次将介绍在 OI 中最普遍使用的排序算法 快速排序,简称快排,顾名思义

快速排序说起来其实也挺简单的,但是需要读者能够理解递归

[collapse status="false" title="递归"]
递归就是函数调用自己。

你的快速排序就是递归:

void Qsort(int x, int y) {
    if (x >= y) return;          // 终止条件
    // ... 分区操作 ...
    Qsort(x, i);                 // 自己调用自己,排左边
    Qsort(i+2, y);               // 自己调用自己,排右边
}

执行过程:先把数组分成左右两部分,然后分别对两部分再调用同样的函数继续分,直到每部分只剩一个元素。

每次调用会占用栈内存,递归太深会栈溢出。你的代码最坏情况(已有序数据)递归深度达 $200000$,风险很大。

上述内容来自 Deepseek V4 Pro,请注意辨别
[/collapse]

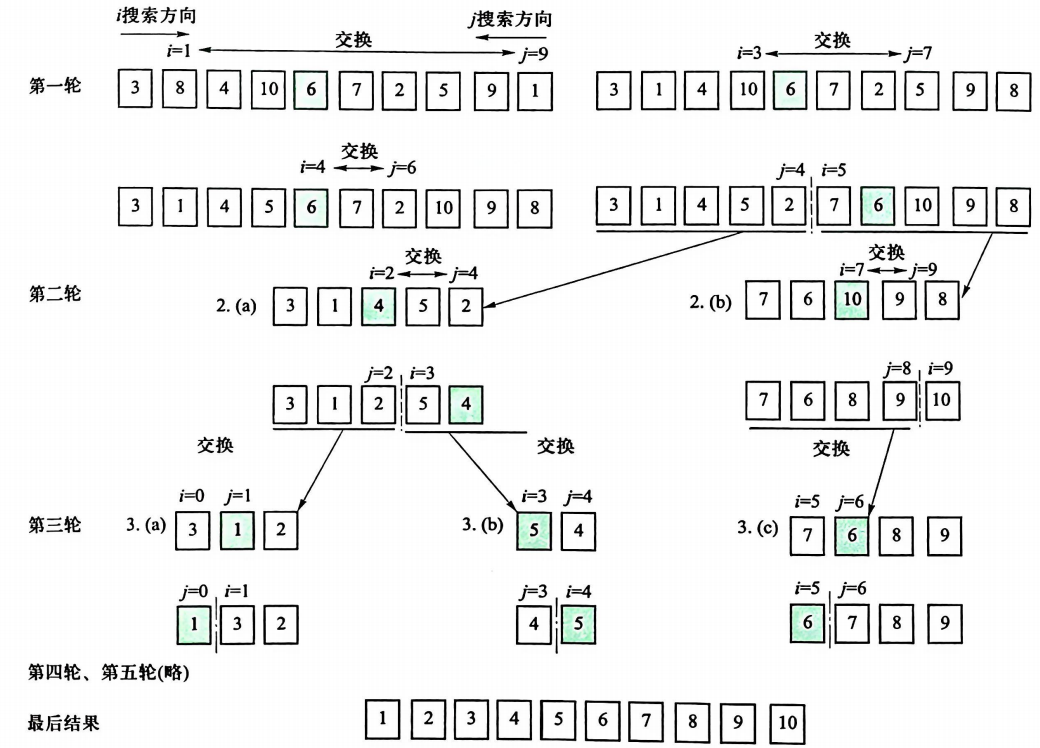
算法的大致过程是对于一个无序序列,找到一个 哨兵数 ,将序列中所有比哨兵数小的数字都在哨兵数的左边,所有比哨兵数大的数字都在哨兵数的右边;然后分别对哨兵数左边和右边再使用同样的方法找到新的哨兵数,并再次进行分类,直到集合不可分割为止

怎么选择哨兵呢?随便选,可以是第一个,可以是中间那个,也可以在序列中随机选择

选择好哨兵,然后从序列左端开始寻找第一个比哨兵大的数字,从右边选择第一个比哨兵小的数字,然后交换这两个数;接着继续从左边找到比哨兵大的数字,右边比哨兵小的数字并交换……直到将序列分为两组,左边序列都不大于哨兵,右边序列都不小于哨兵,就可以分别对左边和右边进行排序了

下面同样还有一张生动的图,建议配合代码食用

参考代码

有多种办法可以实现,这是一种实现办法,也基于书本内容进行了适当的补充更多的办法请前往 排序的应用 这一章节

void qsort(int a[], int l, int r) { // a[] 传递数组
    int i = l, j = r, flag = a[(l + r) / 2], tmp;  // flag是基准值(哨兵)
    do {
        while (a[i] < flag) i++;   // 左指针右移,跳过比基准小的
        while (a[j] > flag) j--;   // 右指针左移,跳过比基准大的
        if (i <= j) {              // 找到一对需要交换的数
            tmp = a[i]; a[i] = a[j]; a[j] = tmp;
            i++; j--;              // 继续移动指针
        }
    } while (i <= j);              // 两指针未交错就继续
    if (l < j) qsort(a, l, j);     // 递归排左半部分
    if (i < r) qsort(a, i, r);     // 递归排右半部分
}

快速排序

虽然在极端情况下(比如数列已经有序,且每次选择哨兵都会分出长度为 $1$ 的小段),快速排序的时间复杂度是 $O(n^2)$,但是如果随机选择哨兵,则很难出现这种情况

实际上,随机化快速排序的算法复杂度是 $O(n \log n)$,空间复杂度是 $O(n)$,而且不需要额外的辅助空间,所以是一种最为实用的排序算法

快速排序利用了 分治 思想,后面可能会出一篇 排序 这一专题的补充篇,介绍了更多的非基础排序

额外的,二分查找法 也利用了 分治思想,这个方法也可能会在未来单独出一篇专题进行讲解

【题目样本 3.2】 P1923 求第 $k$ 小的数

题目描述

https://www.luogu.com.cn/problem/P1923

输入 $n(n \lt 10^6 \text{ 且 } n \text{ 为奇数})$ 个数字 $a_i(a_i \lt 10^9)$,输出这些数字的第 $k$ 小的数,最小的数是第 $0$ 小

分析

如上 URL 中的 题目描述,如果你是真的要训练 快排,请 不要 使用 nth_element STL,当然我估计你也不知道

虽然可以直接排序,然后取数组中的第 $k$ 个作为答案进行输出,但是直接排序一遍的复杂度是 $O(n \log n)$,不适合这道头目,我们可以借鉴 快排 的 分治思想 把时间复杂度降至 $O(n)$

[collapse status="false" title="可以降低时间复杂度的原因"]

核心原因在于每次只需要递归处理一边,而不是两边

更多的:

  1. 快速排序的分治过程
    每次选一个基准(pivot),将数组分成三部分:

    • 左边:所有元素 ≤ pivot
    • 中间:pivot 本身
    • 右边:所有元素 > pivot

    然后递归地对左右两边分别排序,所以总复杂度是 (O(n \log n))。

  2. 求第 k 小数的优化
    在快速选择(Quick Select)中,不需要对两边都排序,只需要判断第 k 小的数在哪一边:

    • 如果 (k) 小于左边元素个数,就只在左边递归查找
    • 如果 (k) 等于左边元素个数 + 1,那么 pivot 就是答案
    • 否则,只在右边递归查找,并且调整 k 的值
  3. 复杂度分析

    • 每次递归处理的数组大小大约是上一次的一半(平均情况)
    • 总比较次数:

      $$ n + \frac{n}{2} + \frac{n}{4} + \cdots = 2n $$

    • 因此平均时间复杂度是 (O(n))

上述内容来源 Deepseek V4 Pro 修改而得
[/collapse]

和快速排序的方法一样,任意取一个哨兵,将序列分为两部分,左边部分的所有数字都不大于右边的数字

  • 如果 $k$ 在左边的范围,则递归求解左边的部分
  • 如果在右边,则递归求解右边的部分
  • 但是也有可能两边都不属于(比如说 $j=4$ 而 $i=6$ , 但刚好 $k=5$),那么直接就可以给出答案

参考代码

这个代码是 深入浅出 提供的,由 Deepseek V4 Pro 和 笔者 改写而得

int ans = 0, k; // 记录答案,以及求第 k 小
void findkth(int a[], int l, int r) { // 引入数组的地址
    if(l == r) {
        ans = a[l]; // 区间长度为 1 时,记录答案
        return;
    }

    int i = l, j = r, flag = a[(l + r) / 2], tmp;
    do {
        while (a[i] < flag) i++; // 从左找比哨兵大的数
        while (a[j] > flag) j--; // 从右找比哨兵小的数
        if (i <= j) { // 交换
            tmp = a[i]; a[i] = a[j]; a[j] = tmp;
            i++; j--;
        }
    } while (i <= j);

    if (k <= j) findkth(a, l, j); // 第 k 小的数字在左区间
    else if (i <= k) findkth(a, i, r); // 第 k 小的数字在右区间
    else findkth(a, j + 1, i - 1); // 第 k 小的数字既不在左区间,也不在右区间
}

尽管 此参考代码片段(快速选择) 相对于 快排(模板代码)类似,但是每次处理的区间长度期望下都会被减半,复杂度是线性的

快速排序 - 快速选择

这个概念是在书中没有的,是由 Deepseek V4 Pro 提出

它基于 快速排序 的分治思想,但并不是完整的排序算法,而是一种 选择算法 ——专门用来查找数组中第 $k$ 小(或第 $k$ 大)的元素

下面是一张表格,阐释了区别

快速排序快速选择
目的将整个数组排好序只找出第 $k$ 小的元素
递归方向同时递归左右两边只递归包含答案的那一边
时间复杂度(O(n \log n))平均 (O(n))
是否完全排序是否

所以,这种方法叫做 快速选择,也可以理解为"快速排序的简化版"或"基于快排分治的选择算法"

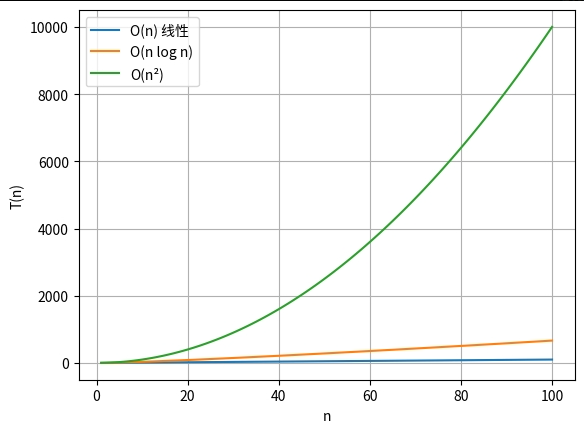
[collapse status="false" title="函数图像(可能有误)"]

这个部分由 Deepseek V4 Pro 与 豆包 提供,它们分别为这个部分 提供函数生成代码 和 提供函数图,在这里表示对他们最诚挚的感谢

但是目前看起来它们携手合作画出来的图有误,作为初二学生的笔者,无法验证这张图的真伪,所以这个问题抛给读者,抱歉

[/collapse]

4 排序的应用

这里提供了一些 排序 的拓展用法,在第二轮比赛时可能有用

【题目样本 4.1】P1059 [NOIP 2006 普及组] 明明的随机数

题目描述

https://www.luogu.com.cn/problem/P1059

给出 $N(N \lt 10^2)$ 个 $1 \sim 10^3$ 的数字,输出去重后剩余数字的个数以及去重排序后的序列

解法 1:计数排序

在拿到新的选票时发现投票箱中已经有这个选票了,就扔掉这张选票,保持每个票箱中最多只有一张票

最后将有票的票箱编号输出即可

这里要求先输出不同数字的个数,可以先枚举一遍票箱记录,输出剩余数字的个数,然后再枚举一遍票箱,输出序列

也可以创建一个新的数组,在枚举票箱的时候将有票的编号复制进新的数组中

解法 2:STL

当然也可以直接对这些数据进行排序,然后从小到大每个数字只输出一个

考虑数据规模,可以使用上面提到的所有排序方式

不过,这次介绍排序的 STL, 这样就不需要去亲自实现排序算法了

关于 STL,后面可能会出一个专门的专题,STL = Standard Template Library(标准模板库)

有了这个就不用自己手搓了

排序 STL 1:sort
分析

std::sort 被定义于 algorithm 头文件中,因此,你在使用前需要先导入这个头文件,为了方便笔者,笔者会尽可能地在后文省略较多的不影响理解的内容

sort 的基本用法如下

// 形式1:默认升序排序
sort(起始迭代器, 结束迭代器);

// 形式2:自定义比较规则
sort(起始迭代器, 结束迭代器, 比较函数/仿函数/Lambda); // 比较函数即 cmp 用的较多

一个例子,sort(a,a+n,cmp),对 $a[]$ 数组从 $a[0]$ 到 $a[n-1]$ 进行排序,cmp 是指自定义排序函数,如果是将数组 $a[]$ 从小到大排序,那么这一项可以省略

参考代码
#include <iostream>
#include <algorithm>
using namespace std;
int const MAXN = 1010;
int a[MAXN], ans[MAXN], n, cnt = 0, tmp = -1;
int main() {
    cin >> n;
    for (int i = 0; i < n; i++) cin >> a[i];
    sort(a, a + n);
    for (int i = 0; i < n; i++) {
    if (a[i] != tmp) ans[cnt++] = a[i]; /* 当前的和上一个不同才复制到新数组 */
    tmp = a[i];
    }
    cout << cnt << endl;
    for (int i = 0; i < cnt; i++) cout << ans[i] << ' ';
    return 0;
}
sort

这里,sort 的时间复杂度是 $O(n \log n)$

如果要对数组 $a[1]$ 到 $a[n]$ 排序,就要用 sort(a+1, a+n+1)

那么,如果要求从大到小排序,只需要定义一个名字是 cmp 的自定义比较函数即可,这个函数的输入是两个元素,如果第一个在第二个之前,则返回 true, 否则返回 false。代码如下:

bool cmp(int q,int h){ // q 前 h 后
    return q>h;
}
排序 STL 2:unique
分析

std::unqiue 同样被定义于 algorithm 头文件中

unique(a,a+n):对 $a[]$ 数组从 $a[0]$ 到 $a[n-1]$ 进行去重,要求 $a[]$ 数组已经有序,返回去重后最后一个元素对应的指针

如果使用 unique, 就可以不用 ans 新数组了,可以直接获得去重后的数组和最终元素个数

参考代码
sort(a,a+n);
cnt=unique(a,a+n)-a; // 剩下的数总数
cout<<cnt<<"\n";
for(int i=0;i<cnt;i++) cout<<a[i]<<" ";

【题目样本 4.2】P1093 [NOIP 2007 普及组] 奖学金

题目描述

https://www.luogu.com.cn/problem/P1093

有 $n$($n \le 300$)名学生的语文、数学、英语成绩,这些学生的学号依次是从 $1$ 到 $n$。需要对这些学生进行排序。如果总分相同,则语文分数高者名次靠前;如果语文成绩还相同,学号小者靠前。输出排名前 $5$ 的学生学号和总分

解法 1:STL

分析

定义一个 struct 结构体,命名为 student 存储学生各项信息,使用 sort 附带 cmp 比较函数进行排序,最后输出排序结果,下面是排序优先级

  1. 总分,高者优先
  2. 语文,高者优先
  3. 学好,小者优先
参考代码
#include <algorithm>
#include <iostream>
using namespace std;

int const MAXN = 310;
int n;

struct student {
    int id, chinese, total;
} a[MAXN];

int cmp(student a, student b) {
    if (a.total != b.total) return a.total > b.total;      // 总分先定胜负
    if (a.chinese != b.chinese) return a.chinese > b.chinese; // 然后比语文
    return a.id < b.id;                                    // 最后比学号
}

int main() {
    cin >> n;
    for (int i = 0; i < n; i++) {
        int math, english;
        cin >> a[i].chinese >> math >> english;
        a[i].total = a[i].chinese + math + english;
        a[i].id = i + 1;
    }

    sort(a, a + n, cmp);

    for (int i = 0; i < 5; i++) {
        cout << a[i].id << " " << a[i].total << endl;
    }

    return 0;
}

解法 2:选择排序

分析

时间复杂度 $O(kn)$,此题 $k=5$,即 $O(n)$

解法 3:插入排序

分析

维护排名前 $5$ 数组作为比较对象(手牌)

时间复杂度 $O(n)$,运行效率不高

【题目样本 4.3】P1781 宇宙总统

题目描述

https://www.luogu.com.cn/problem/P1781

共有 ( n )(( n \le 20 ))个非凡拔尖的人竞选总统,现在票数已经统计完毕,请算出谁能够当上总统。第一行输出候选人编号,第二行输出选票数量。票数可能很大,最大会有 100 位

解法 1:计数排序

分析

由于本题只需要求出最大的那一个数字,所以用“打擂台”法

但是数字很大,没办法直接存下来(long long 也存不下)

但是需要高精度,不考虑单开一个话题

解法 2:结构体

分析

存进字符串。不过不能直接对这些字符串进行大小比较,因为字符串比较是比较字典序(第一位小的在前面,如果相同则比较第二位,以此类推),例如 $10000$ 小于 $1200$ 小于 $200$

得手搓 cmp

参考代码

struct node {
    string x;    // 票数
    int num;     // 候选人编号
} s[MAXN];

bool cmp(node a, node b) {
    if (a.x.length() != b.x.length()) {
        return a.x.length() > b.x.length(); // a 比 b 位数多时 a 在前面
    }
    return a.x > b.x; // 位数相同,但 a 字典序排列比 b 大
}

5 汇总

练习

笔者为读者提供了一些洛谷上没有的题目,供练习

C++ 常用排序算法一览表

额外的,这里有一张特别大的表格,供读者查阅

排序算法平均时间复杂度最好时间复杂度最坏时间复杂度空间复杂度最坏空间复杂度稳定性特点
冒泡排序$O(n^2)$$O(n)$$O(n^2)$$O(1)$$O(1)$✅ 稳定相邻元素两两比较,大数后移;优化版可提前结束
选择排序$O(n^2)$$O(n^2)$$O(n^2)$$O(1)$$O(1)$❌ 不稳定每轮选最小放到前面;交换次数最少(n次)
插入排序$O(n^2)$$O(n)$$O(n^2)$$O(1)$$O(1)$✅ 稳定将元素插入已排序区;数据量小或基本有序时极快
希尔排序$O(n \log n) \sim O(n^2)$$O(n \log n)$$O(n^2)$$O(1)$$O(1)$❌ 不稳定分组插入排序;增量序列决定效率
归并排序$O(n \log n)$$O(n \log n)$$O(n \log n)$$O(n)$$O(n)$✅ 稳定分治+合并;适合链表和外部排序
快速排序$O(n \log n)$$O(n \log n)$$O(n^2)$$O(\log n)$$O(n)$❌ 不稳定分治+分区;实际最快,但最坏退化为 $O(n^2)$
堆排序$O(n \log n)$$O(n \log n)$$O(n \log n)$$O(1)$$O(1)$❌ 不稳定基于堆数据结构;适合求 Top K
计数排序$O(n + k)$$O(n + k)$$O(n + k)$$O(k)$$O(k)$✅ 稳定非比较排序;适用于整数且范围 $k$ 不大
桶排序$O(n + k)$$O(n + k)$$O(n^2)$$O(n + k)$$O(n + k)$✅ 稳定分桶+桶内排序;数据分布均匀时极快
基数排序$O(d \times (n + k))$$O(d \times (n + k))$$O(d \times (n + k))$$O(n + k)$$O(n + k)$✅ 稳定按位排序(LSD/MSD);适合整数或字符串

[collapse status="false" title="C++ 常用排序算法一览表(无特点)"]

排序算法平均时间复杂度最好时间复杂度最坏时间复杂度空间复杂度最坏空间复杂度稳定性
冒泡排序$O(n^2)$$O(n)$$O(n^2)$$O(1)$$O(1)$✅ 稳定
选择排序$O(n^2)$$O(n^2)$$O(n^2)$$O(1)$$O(1)$❌ 不稳定
插入排序$O(n^2)$$O(n)$$O(n^2)$$O(1)$$O(1)$✅ 稳定
希尔排序$O(n \log n) \sim O(n^2)$$O(n \log n)$$O(n^2)$$O(1)$$O(1)$❌ 不稳定
归并排序$O(n \log n)$$O(n \log n)$$O(n \log n)$$O(n)$$O(n)$✅ 稳定
快速排序$O(n \log n)$$O(n \log n)$$O(n^2)$$O(\log n)$$O(n)$❌ 不稳定
堆排序$O(n \log n)$$O(n \log n)$$O(n \log n)$$O(1)$$O(1)$❌ 不稳定
计数排序$O(n + k)$$O(n + k)$$O(n + k)$$O(k)$$O(k)$✅ 稳定
桶排序$O(n + k)$$O(n + k)$$O(n^2)$$O(n + k)$$O(n + k)$✅ 稳定
基数排序$O(d \times (n + k))$$O(d \times (n + k))$$O(d \times (n + k))$$O(n + k)$$O(n + k)$✅ 稳定

[/collapse]

C++ STL 中的排序一览表

同时,这里还有一张关于 STL 的表

函数时间复杂度空间复杂度最坏空间复杂度稳定性特点
std::sort$O(n \log n)$$O(\log n)$$O(\log n)$❌ 不稳定混合排序(快排+堆排+插入),最常用
std::stable_sort$O(n \log^2 n) \sim O(n \log n)$$O(n)$$O(n)$✅ 稳定保证相等元素顺序不变
std::partial_sort$O(n \log k)$$O(1)$$O(1)$❌ 不稳定取前 $k$ 个最小/最大
std::nth_element$O(n)$ 平均$O(1)$$O(1)$❌ 不稳定求第 $k$ 小/大,不完全排序

NOIP 信息学:搜索及其优化 完整知识点文档

https://www.tropical-fish.cn/usr/uploads/2026/07/3625185257.pptx

一、前言:搜索算法定位

  1. 算法解题优先级:优先数学推导、递推、贪心、DP;无高效数学解法时,使用搜索。
  2. 搜索特点:通用性强、适用范围广;纯暴力搜索效率极低,必须配合各类优化才能通过大数据。
  3. 基础搜索分类:穷举、深度优先搜索(DFS)、广度优先搜索(BFS)。

二、核心基础概念

2.1 状态

  • 定义:搜索的最小单元,决定搜索效率、思维难度、代码复杂度。
  • 设计要点:靠刷题积累经验,状态定义优劣直接决定代码能否过时限。

2.2 搜索树

所有搜索过程均可抽象为一棵搜索树:

  • DFS:纵向优先遍历整棵树,适合求全部可行解、构造方案;缺点是深度过大易栈溢出。
  • BFS:逐层横向遍历,天然适合求最短/最小代价最优解;自带分层,第一次到达目标即为最优。

三、基础搜索算法实现

3.1 深度优先搜索 DFS(回溯)

通用模板

void dfs(int dep, [其他状态参数])
{
    // 边界:到达目标状态
    if(当前为目标状态){
        记录答案/输出/计数;
        return;
    }
    // 枚举所有可拓展状态
    for(枚举所有下一步可能){
        保存现场(修改全局/局部状态);
        if(该拓展合法) dfs(dep + 1, 新参数);
        恢复现场(回溯,还原状态);
    }
}

特点

  1. 使用系统栈/手动栈,递归实现;
  2. 不自动保证最优,需手动记录最优值;
  3. 深度过大时栈溢出(如POJ3278裸DFS会爆栈)。

3.2 广度优先搜索 BFS(队列)

通用模板

初始状态入队;
while(队列不为空){
    取出队首元素,队首出队;
    if(当前是目标状态){输出答案; return;}
    // 拓展所有子状态
    for(所有拓展方向){
        if(状态未访问 && 拓展合法){
            标记已访问(判重);
            新状态入队;
        }
    }
}

特点

  1. 借助队列实现分层遍历;
  2. 第一次抵达终点一定是最小步数/最小代价,无需额外比较最优;
  3. 必须判重,否则重复入队无限循环。

四、经典入门例题:POJ3278 抓住那头牛

题目简述

农夫在数轴N,牛在K,三种移动方式,每次耗时1分钟:

  1. $X \to X-1$
  2. $X \to X+1$
  3. $X \to 2X$
    求到达牛位置的最少时间。样例输入5 17,输出4。

算法选择分析

  1. 裸DFS:搜索树深度极大,系统栈溢出,且无法保证最优;
  2. BFS最优:分层遍历,首次走到K即为最小步数,是本题标准解法。

五、NOIP真题案例详解

5.1 NOIP2017提高组Day2 T1 奶酪(连通性DFS)

题意

无限大奶酪,高度$h$,内部有等半径球形空洞;空洞相交/相切可互通;空洞接触下表面$z=0$可进入,接触上表面$z=h$可逃出。判断老鼠能否从底部走到顶部。

核心思路

  1. 模型转化:无向图连通性,每个空洞是节点;
  2. 连通条件:两球心距离 $\le 2r$;

    • 距离公式避免sqrt防止精度丢失:平方比较
      $$(x_1-x_2)^2+(y_1-y_2)^2+(z_1-z_2)^2 \le (2r)^2$$
    • 全部变量使用long long,防止大数溢出;
  3. 起点集合:$z \le r$ 的空洞(接触下表面);
  4. 终止条件:搜到任意满足 $z \ge h-r$ 的空洞(接触上表面);

核心代码框架

void dfs(int id){
    vis[id] = true;
    // 判断是否连通上表面
    if(hole[id].z + r >= h) flag = true;
    for(int i = 1; i <= n; i++){
        if(!vis[i] && 两球连通(id,i)) dfs(i);
    }
}

5.2 NOIP2014提高组Day2 T2 寻找道路(反向DFS+BFS最短路)

题意

有向图,边权均为1,求起点s到终点t的最短路径,约束:路径上每个点的所有出边指向的点,都能间接到达终点t。

分步解法

  1. 建两张图:正向图(原图)、反向图(所有边反转);
  2. 反向图DFS:从终点t出发,标记所有能到达t的点vis1[];
  3. 筛选合法点:一个点u合法当且仅当u所有出边指向的v都满足vis1[v]=true;
  4. 正向图BFS:仅走合法点,求s到t最短路;

数据注意

$n\le10^4,m\le2\times10^5$,稀疏图用vector邻接表;输入量大,禁用cin,改用scanf防超时。

5.3 NOIP2017普及组T3 棋盘(带状态记忆化DFS)

题意

$m\times m$棋盘,格子红/黄/无色;四向行走,异色花费1金币;可花2金币临时将无色格子染色,魔法不可连续释放。求左上角到右下角最小花费。

状态设计(三维记忆化)

f[x][y][can]:坐标$(x,y)$,can=0/1代表当前能否使用魔法,存储到达该状态最小金币;

状态转移

  1. 下一格有颜色:根据颜色是否相同累加金币,魔法重置为可用;
  2. 下一格无色:仅当魔法可用时,花费2金币,魔法置为不可用;

优化梯度

  • 裸DFS:40分;
  • 最优性剪枝:60分;
  • 记忆化剪枝(记录每个状态最小代价):100分。

5.4 NOIP2009提高组T4 靶形数独(DFS+搜索顺序优化)

题意

9×9数独,每个格子有分值,数字×格子分值总和最大化;无解输出-1。

优化梯度

  1. 暴力DFS顺序填格:40分;
  2. 预处理空白格、行/列/九宫格数字判重:75分;
  3. 最优优化(100分):搜索顺序优化
    每次优先选择可填数字最少的空白格填充,大幅剪枝无效分支;

    • 若某格无合法数字:可行性剪枝,直接回溯;
    • 若只剩1种数字:直接填充,减少循环。

六、DFS核心优化:剪枝

6.1 可行性剪枝

当前状态已经不满足题目约束,后续无论怎么走都无解,直接回溯。
例:数独格子无可用数字、数轴坐标超出0~100000范围。

6.2 最优性剪枝

全局记录当前已知最优解;若当前已消耗代价 ≥ 最优解,后续路径只会更差,直接返回。
例:抓牛DFS记录当前最小步数,当前步数超过最优则剪枝。

6.3 记忆化剪枝(全局最优剪枝)

记录每个状态到达时的最小代价;再次走到同一状态时,若当前花费 ≥ 记录值,直接剪枝;否则更新记录。
适用:棋盘、最短代价类搜索问题。

6.4 搜索顺序优化

人为调整拓展节点的先后顺序,优先搜索分支少、更容易出解的路径,提前触发剪枝。
代表例题:靶形数独(优先填可选数字最少的格子)。

七、高阶搜索优化算法

7.1 迭代加深搜索 IDDFS

  1. 思路:限制DFS最大深度,从小到大逐层放宽深度限制;
  2. 优势:兼具DFS空间小、BFS保证最优的特点;解决深搜栈溢出问题;
  3. 适用:求最小步数、深度不确定的最优解问题。

7.2 双向BFS

  1. 思路:起点BFS、终点BFS同时向外拓展,两边相遇即得到最优解;
  2. 优势:搜索范围指数级缩小,大幅降低时间复杂度;
  3. 适用:起点终点明确、状态空间巨大的最短路问题(抓牛、迷宫最短路径)。

7.3 BFS配套优化:哈希判重

状态复杂(字符串、多维数组)无法开数组标记访问时,用哈希表存储已走过状态,避免重复入队。

八、搜索算法选择总结

算法适用场景核心优势短板
DFS求全部方案、连通性、构造解代码简单、空间小无法保证最优、深度大易栈溢出
BFS最短步数、最小代价最优解天然最优、分层遍历队列占用空间大
DFS+剪枝最优值、代价最小类搜索灵活,多重剪枝提速需要手动维护最优答案
IDDFS深度未知、需要最优、怕栈溢出兼顾DFS与BFS优点重复浅层搜索,轻微冗余
双向BFS超大状态空间最短路搜索量指数级减少代码逻辑更复杂

九、易错点汇总

  1. 距离比较时禁用sqrt,平方后用long long避免精度、溢出问题;
  2. 大数据输入使用scanf/printf,cin关闭同步或直接淘汰;
  3. DFS回溯必须恢复现场,否则状态污染;
  4. BFS必须判重,否则死循环;
  5. 连通性问题分清有向图/无向图,按需建反向图;
  6. 记忆化数组初始化无穷大,到达同一状态代价更小时才更新;
  7. 递归DFS注意递归深度上限,深度极大改用迭代加深或BFS。

十、配套上机习题

  1. 奶酪:基础连通DFS
  2. 飞越原野:BFS+记忆判重
  3. 寻找道路:反向DFS+正向BFS综合
  4. 棋盘:DFS+记忆化最优剪枝
  5. 靶形数独:DFS+搜索顺序优化
  6. 小木棍:DFS多重可行性/最优性剪枝

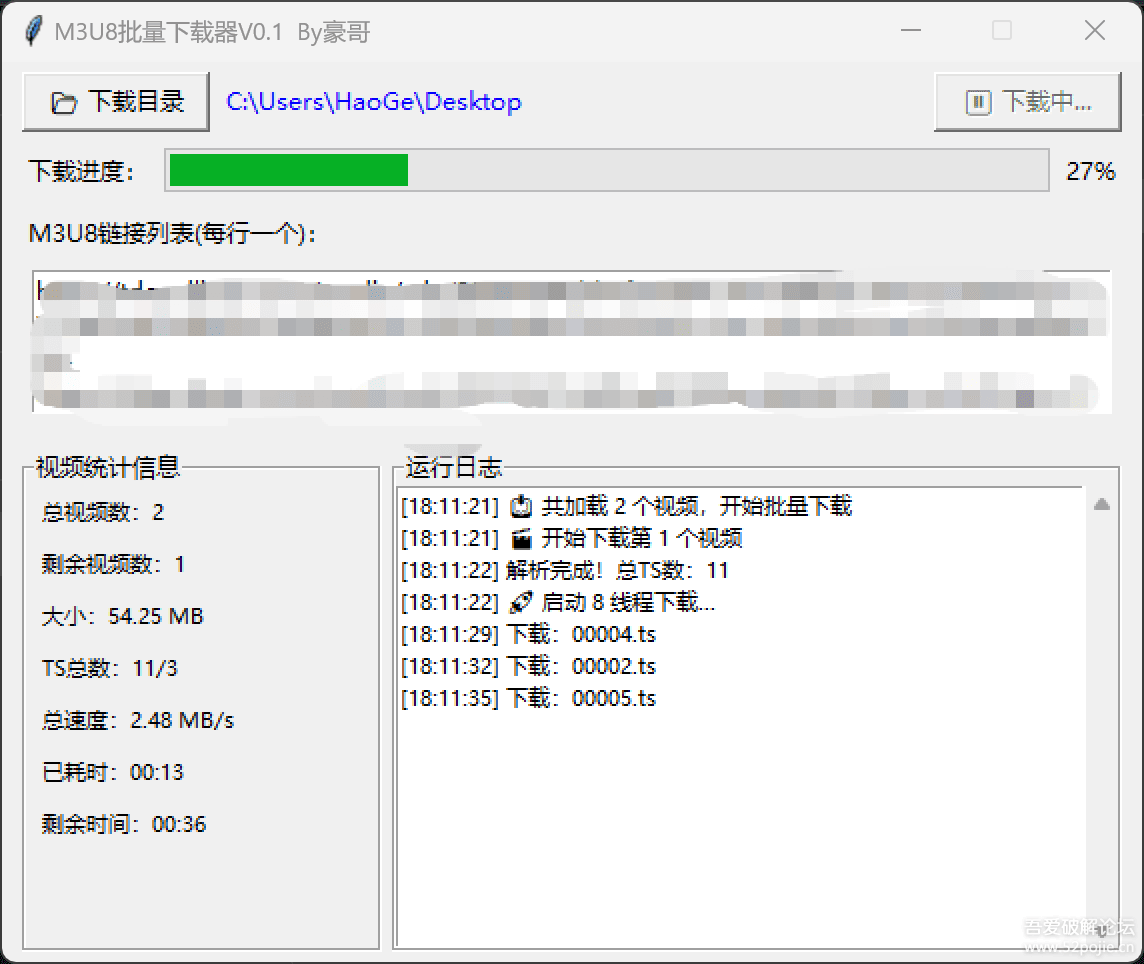
m3u8 下载器

简介

一款m3u8批量下载的软件,支持部分分分加密的m3u8文件,有些加密的应该是没办法搞定

当复制到链接的时候会自动粘贴进入,不需要自己手动点复制粘贴

其它信息如图,自己测试了还能用,不知道其他老铁们能不能正常用,有兴趣的可以源码查看修改.....

不喜勿喷

关于为什么要从吾爱复制这个东西,因为觉得这个东西是真的有用,然而有时又可能找不到

图片

mnvso78g.png

源代码

import tkinter as tk
from tkinter import ttk, filedialog, messagebox
import threading
import queue
import os
import time
import requests
import m3u8
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urljoin
from Crypto.Cipher import AES
from Crypto.Util.Padding import unpad
 
# -------------------------- 配置项 --------------------------
DEFAULT_THREAD_NUM = 8
TIMEOUT = 15
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows 10; Win64; x64) AppleWebKit/537.36"
}
DEFAULT_PATH = os.path.join(os.path.expanduser("~"), "Desktop")
 
 
# ------------------------------------------------------------
 
class M3U8Downloader(tk.Tk):
    def __init__(self):
        super().__init__()
        self.title("M3U8批量下载器V0.1  By豪哥")
        self.geometry("570x450")
        self.resizable(False, False)
 
        # 全局变量
        self.save_path = tk.StringVar(value=DEFAULT_PATH)
        self.total_ts = 0
        self.finish_ts = 0
        self.msg_queue = queue.Queue()
        self.is_downloading = False
        self.key = None
        self.iv = None
        self.last_clipboard = ""
        self.thread_num = tk.IntVar(value=DEFAULT_THREAD_NUM)
        self.last_link = ""
 
        # 下载计时&速度统计
        self.start_time = 0
        self.total_downloaded_bytes = 0
 
        # 批量下载变量
        self.video_list = []
        self.current_video_idx = 0
        self.total_videos = 0
        self.remaining_videos = 0  # 剩余视频数量
        self.video_size = 0.00
 
        self.init_ui()
        self.check_queue()
        self.watch_clipboard()
        self.link_text.bind("<<Modified>>", self.on_link_changed)
 
    def init_ui(self):
        """初始化界面"""
        # ====================== 顶部按钮区域 ======================
        top_frame = tk.Frame(self, pady=5)
        top_frame.pack(fill=tk.X, padx=10)
 
        self.btn_path = tk.Button(
            top_frame, text="&#128194; 下载目录", command=self.select_save_path,
            width=12, font=("微软雅黑", 9)
        )
        self.btn_path.pack(side=tk.LEFT)
 
        self.label_path = tk.Label(
            top_frame, textvariable=self.save_path, fg="blue", font=("微软雅黑", 9)
        )
        self.label_path.pack(side=tk.LEFT, padx=5)
 
        self.btn_start = tk.Button(
            top_frame, text="&#9654;&#65039; 开始下载", command=self.start_batch_download,
            width=12, font=("微软雅黑", 9)
        )
        self.btn_start.pack(side=tk.RIGHT)
 
        # ====================== 进度条+百分比 ======================
        progress_frame = tk.Frame(self, pady=3)
        progress_frame.pack(fill=tk.X, padx=10)
        tk.Label(progress_frame, text="下载进度:", font=("微软雅黑", 9)).pack(side=tk.LEFT)
 
        self.progress_bar = ttk.Progressbar(progress_frame, mode="determinate", length=380)
        self.progress_bar.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=5)
 
        self.progress_label = tk.Label(progress_frame, text="0%", font=("微软雅黑", 9))
        self.progress_label.pack(side=tk.LEFT)
 
        # ====================== M3U8链接列表 + 线程选择 ======================
        link_frame = tk.Frame(self, pady=5)
        link_frame.pack(fill=tk.X, padx=10)
        tk.Label(link_frame, text="M3U8链接列表(每行一个):", font=("微软雅黑", 9)).pack(anchor=tk.W)
 
        self.link_text = tk.Text(link_frame, height=4, font=("微软雅黑", 9))
        self.link_text.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=5)
        self.link_text.edit_modified(False)
 
        # 右侧:线程数选择
        thread_frame = tk.Frame(link_frame)
        thread_frame.pack(side=tk.RIGHT, padx=5)
 
        tk.Label(thread_frame, text="下载线程:", font=("微软雅黑", 9)).pack(anchor=tk.N)
        self.thread_combobox = ttk.Combobox(
            thread_frame, textvariable=self.thread_num,
            values=[1, 2, 4, 8, 16, 32], state="readonly", width=5
        )
        self.thread_combobox.current(3)
        self.thread_combobox.pack(anchor=tk.N)
 
        self.btn_clear = tk.Button(
            thread_frame, text="清空", command=self.clear_link,
            width=6, font=("微软雅黑", 9)
        )
        self.btn_clear.pack(anchor=tk.N, pady=5)
 
        # ====================== 左右分栏布局 ======================
        bottom_frame = tk.Frame(self, pady=5)
        bottom_frame.pack(fill=tk.BOTH, expand=True, padx=10)
 
        # 左侧:视频统计信息
        self.stats_frame = tk.LabelFrame(bottom_frame, text="视频统计信息", font=("微软雅黑", 9), width=180)
        self.stats_frame.pack(side=tk.LEFT, fill=tk.BOTH, padx=(0, 5))
        self.stats_frame.pack_propagate(False)
 
        # ========== 【总视频 + 剩余视频】 ==========
        self.label_total_videos = tk.Label(self.stats_frame, text=f"总视频数:0", font=("微软雅黑", 8))
        self.label_total_videos.pack(anchor=tk.W, padx=5, pady=2)
 
        self.label_remaining_videos = tk.Label(self.stats_frame, text=f"剩余视频数:0", font=("微软雅黑", 8))
        self.label_remaining_videos.pack(anchor=tk.W, padx=5, pady=2)
        # ==========================================
 
        # 视频大小
        self.label_size = tk.Label(self.stats_frame, text=f"大小:{self.video_size:.2f} MB", font=("微软雅黑", 8))
        self.label_size.pack(anchor=tk.W, padx=5, pady=2)
        # TS总数/已下载
        self.label_ts_info = tk.Label(self.stats_frame, text=f"TS总数:{self.total_ts}/{self.finish_ts}", font=("微软雅黑", 8))
        self.label_ts_info.pack(anchor=tk.W, padx=5, pady=2)
        # 总下载速度
        self.label_speed = tk.Label(self.stats_frame, text="总速度:0.00 MB/s", font=("微软雅黑", 8))
        self.label_speed.pack(anchor=tk.W, padx=5, pady=2)
        # 已耗时
        self.label_cost = tk.Label(self.stats_frame, text="已耗时:00:00", font=("微软雅黑", 8))
        self.label_cost.pack(anchor=tk.W, padx=5, pady=2)
        # 预估剩余时间
        self.label_remain = tk.Label(self.stats_frame, text="剩余时间:--:--", font=("微软雅黑", 8))
        self.label_remain.pack(anchor=tk.W, padx=5, pady=2)
 
        # 右侧:运行日志
        log_frame = tk.LabelFrame(bottom_frame, text="运行日志", font=("微软雅黑", 9))
        log_frame.pack(side=tk.RIGHT, fill=tk.BOTH, expand=True)
 
        log_scroll = tk.Scrollbar(log_frame)
        log_scroll.pack(side=tk.RIGHT, fill=tk.Y)
        self.log_text = tk.Text(
            log_frame, height=5, font=("微软雅黑", 8),
            yscrollcommand=log_scroll.set, state=tk.DISABLED
        )
        self.log_text.pack(side=tk.LEFT, fill=tk.BOTH, expand=True)
        log_scroll.config(command=self.log_text.yview)
 
    def time_format(self, seconds):
        """秒数转换为 分:秒 格式"""
        if seconds < 0:
            return "00:00"
        m = int(seconds // 60)
        s = int(seconds % 60)
        return f"{m:02d}:{s:02d}"
 
    def on_link_changed(self, event):
        """链接框内容变化 → 自动更新总视频数"""
        self.link_text.edit_modified(False)
        links = self.link_text.get(1.0, tk.END).strip().splitlines()
        valid_links = [l.strip() for l in links if l.strip().startswith("http")]
 
        # 自动统计视频数量
        self.total_videos = len(valid_links)
        self.remaining_videos = self.total_videos
        self.update_video_count_labels()
 
        if self.is_downloading:
            return
 
        first_link = next((l.strip() for l in valid_links), "")
        if first_link == self.last_link:
            return
        self.last_link = first_link
        if not first_link:
            self.reset_stats()
            return
        threading.Thread(target=self.pre_parse_m3u8_info, args=(first_link,), daemon=True).start()
 
    def update_video_count_labels(self):
        """更新总视频数 / 剩余视频数"""
        self.label_total_videos.config(text=f"总视频数:{self.total_videos}")
        self.label_remaining_videos.config(text=f"剩余视频数:{self.remaining_videos}")
 
    def pre_parse_m3u8_info(self, m3u8_url):
        """预解析M3U8信息"""
        try:
            m3u8_obj = m3u8.load(m3u8_url, headers=HEADERS, timeout=TIMEOUT)
            temp_size = 0.0
            if m3u8_obj.playlists:
                new_url = urljoin(m3u8_url, m3u8_obj.playlists[-1].uri)
                m3u8_obj = m3u8.load(new_url, headers=HEADERS, timeout=TIMEOUT)
            temp_total_ts = len(m3u8_obj.segments)
            for seg in m3u8_obj.segments:
                temp_size += seg.duration * 0.5
            self.video_size = temp_size
            self.total_ts = temp_total_ts
            self.finish_ts = 0
            self.update_stats()
        except Exception as e:
            self.reset_stats()
 
    def reset_stats(self):
        """重置统计信息"""
        self.video_size = 0.00
        self.total_ts = 0
        self.finish_ts = 0
        self.total_downloaded_bytes = 0
        self.start_time = 0
        self.update_stats()
 
    def watch_clipboard(self):
        """监听剪贴板,自动换行添加链接"""
        try:
            content = self.clipboard_get().strip()
            if content != self.last_clipboard and content.startswith("http") and ("m3u8" in content):
                self.last_clipboard = content
                self.link_text.insert(tk.END, content + "\n")
        except:
            pass
        self.after(1000, self.watch_clipboard)
 
    def select_save_path(self):
        path = filedialog.askdirectory(title="选择保存目录", initialdir=DEFAULT_PATH)
        if path:
            self.save_path.set(path)
 
    def clear_link(self):
        self.link_text.delete(1.0, tk.END)
        self.total_videos = 0
        self.remaining_videos = 0
        self.update_video_count_labels()
        self.reset_stats()
 
    def write_log(self, msg):
        self.msg_queue.put(("log", msg))
 
    def update_progress(self):
        self.msg_queue.put(("progress", None))
 
    def update_stats(self):
        self.msg_queue.put(("stats", None))
 
    def download_finish(self):
        self.msg_queue.put(("finish", None))
 
    def check_queue(self):
        """刷新GUI(线程安全)"""
        while not self.msg_queue.empty():
            task, data = self.msg_queue.get()
            if task == "log":
                self.log_text.config(state=tk.NORMAL)
                self.log_text.insert(tk.END, f"[{time.strftime('%H:%M:%S')}] {data}\n")
                self.log_text.config(state=tk.DISABLED)
                self.log_text.see(tk.END)
            elif task == "progress":
                percent = int(self.finish_ts / self.total_ts * 100) if self.total_ts > 0 else 0
                self.progress_bar["value"] = self.finish_ts
                self.progress_label.config(text=f"{percent}%")
                self.label_ts_info.config(text=f"TS总数:{self.total_ts}/{self.finish_ts}")
                if self.finish_ts > 0 and self.start_time > 0:
                    cost_time = time.time() - self.start_time
                    speed_mb = (self.total_downloaded_bytes / 1024 / 1024) / cost_time if cost_time > 0 else 0
                    remain_ts = self.total_ts - self.finish_ts
                    remain_time = (remain_ts * cost_time) / self.finish_ts if self.finish_ts > 0 else 0
                    self.label_speed.config(text=f"总速度:{speed_mb:.2f} MB/s")
                    self.label_cost.config(text=f"已耗时:{self.time_format(cost_time)}")
                    self.label_remain.config(text=f"剩余时间:{self.time_format(remain_time)}")
            elif task == "stats":
                self.label_size.config(text=f"大小:{self.video_size:.2f} MB")
                self.label_ts_info.config(text=f"TS总数:{self.total_ts}/{self.finish_ts}")
                self.label_speed.config(text="总速度:0.00 MB/s")
                self.label_cost.config(text="已耗时:00:00")
                self.label_remain.config(text="剩余时间:--:--")
            elif task == "finish":
                self.is_downloading = False
                self.btn_start.config(state=tk.NORMAL, text="&#9654;&#65039; 开始下载")
                self.progress_label.config(text="0%")
        self.after(50, self.check_queue)
 
    def get_decrypt_key(self, key_uri, base_url):
        try:
            key_url = urljoin(base_url, key_uri)
            res = requests.get(key_url, headers=HEADERS, timeout=TIMEOUT)
            res.raise_for_status()
            return res.content
        except:
            return None
 
    def decrypt_ts(self, ts_data):
        if self.key is None:
            return ts_data
        try:
            cipher = AES.new(self.key, AES.MODE_CBC, self.iv or self.key)
            return unpad(cipher.decrypt(ts_data), AES.block_size)
        except:
            return ts_data
 
    def download_ts(self, ts_url, save_dir, index):
        """下载单个TS分片"""
        ts_name = f"{index:05d}.ts"
        ts_path = os.path.join(save_dir, ts_name)
        try:
            with requests.get(ts_url, headers=HEADERS, timeout=TIMEOUT, stream=True) as r:
                r.raise_for_status()
                ts_data = self.decrypt_ts(r.content)
                self.total_downloaded_bytes += len(ts_data)
                with open(ts_path, "wb") as f:
                    f.write(ts_data)
            self.write_log(f"下载:{ts_name}")
            self.finish_ts += 1
            self.update_progress()
        except Exception as e:
            self.write_log(f"失败:{ts_name}")
 
    def merge_ts(self, ts_dir, save_path):
        video_name = time.strftime("%Y%m%d_%H%M%S") + ".mp4"
        video_path = os.path.join(save_path, video_name)
        ts_files = sorted([f for f in os.listdir(ts_dir) if f.endswith(".ts")])
        with open(video_path, "wb") as out:
            for ts in ts_files:
                with open(os.path.join(ts_dir, ts), "rb") as f:
                    out.write(f.read())
        for ts in ts_files:
            os.remove(os.path.join(ts_dir, ts))
        os.rmdir(ts_dir)
        self.write_log(f"&#9989; 下载完成!文件地址:{video_path}")
 
    def parse_m3u8(self, m3u8_url):
        m3u8_obj = m3u8.load(m3u8_url, headers=HEADERS, timeout=TIMEOUT)
        self.video_size = 0.0
        if m3u8_obj.playlists:
            new_url = urljoin(m3u8_url, m3u8_obj.playlists[-1].uri)
            return self.parse_m3u8(new_url)
        self.total_ts = len(m3u8_obj.segments)
        for seg in m3u8_obj.segments:
            self.video_size += seg.duration * 0.5
        self.key = None
        self.iv = None
        if m3u8_obj.keys and m3u8_obj.keys[0]:
            key_info = m3u8_obj.keys[0]
            self.key = self.get_decrypt_key(key_info.uri, m3u8_url)
            self.iv = bytes.fromhex(key_info.iv[2:]) if key_info.iv else None
        return m3u8_obj, m3u8_url.rsplit("/", 1)[0] + "/"
 
    def download_single_video(self, m3u8_url):
        """下载单个视频"""
        try:
            self.start_time = time.time()
            self.total_downloaded_bytes = 0
            self.write_log(f"&#127916; 开始下载第 {self.current_video_idx} 个视频")
            m3u8_obj, base_url = self.parse_m3u8(m3u8_url)
            self.update_stats()
            if not m3u8_obj.segments:
                self.write_log("&#10060; 未找到视频分片!")
                return
            self.finish_ts = 0
            self.progress_bar["maximum"] = self.total_ts
            self.progress_bar["value"] = 0
            self.write_log(f"解析完成!总TS数:{self.total_ts}")
            ts_dir = os.path.join(self.save_path.get(), "temp_ts")
            os.makedirs(ts_dir, exist_ok=True)
            thread_count = self.thread_num.get()
            self.write_log(f"&#128640; 启动 {thread_count} 线程下载...")
            with ThreadPoolExecutor(thread_count) as executor:
                for idx, url in enumerate([urljoin(base_url, seg.uri) for seg in m3u8_obj.segments]):
                    executor.submit(self.download_ts, url, ts_dir, idx)
            self.merge_ts(ts_dir, self.save_path.get())
        except Exception as e:
            self.write_log(f"&#128165; 下载异常:{str(e)}")
 
    def batch_download_worker(self):
        """批量下载主逻辑"""
        try:
            links = self.link_text.get(1.0, tk.END).strip().splitlines()
            self.video_list = [link.strip() for link in links if link.strip().startswith("http")]
            self.total_videos = len(self.video_list)
            self.remaining_videos = self.total_videos
            self.current_video_idx = 0
            self.update_video_count_labels()
 
            if self.total_videos == 0:
                messagebox.showerror("错误", "请输入有效的M3U8链接!")
                return
 
            self.write_log(f"&#128229; 共加载 {self.total_videos} 个视频,开始批量下载")
 
            for url in self.video_list:
                self.current_video_idx += 1
                # ========== 【核心修改:开始下载前就 -1】 ==========
                self.remaining_videos -= 1
                self.update_video_count_labels()
                # ================================================
                self.download_single_video(url)
 
            self.write_log("&#127881; 所有视频下载完成!")
            messagebox.showinfo("完成", "全部视频下载成功!")
            self.clear_link()
 
        except Exception as e:
            self.write_log(f"批量下载异常:{str(e)}")
        finally:
            self.download_finish()
 
    def start_batch_download(self):
        """启动批量下载"""
        if self.is_downloading:
            messagebox.showwarning("提示", "正在下载中!")
            return
        self.is_downloading = True
        self.btn_start.config(state=tk.DISABLED, text="&#9208; 下载中...")
        self.log_text.config(state=tk.NORMAL)
        self.log_text.delete(1.0, tk.END)
        self.log_text.config(state=tk.DISABLED)
        threading.Thread(target=self.batch_download_worker, daemon=True).start()
 
 
if __name__ == "__main__":
    app = M3U8Downloader()
    app.mainloop()

传送门

题目
更好的阅读体验

题目大意

读入一个字符串, 匹配括号字符串所表示的树,求根节点到所有叶节点的距离之和。

分析题目

  • 括号字符串中,每一个叶节点都是对应一个 ();
  • 字符串中的深度比实际深度大 $1$,需要减去 $1$ 再进行计算;
  • 扫描字符串,遇到 ( 深度 $+1$,否则深度 $-1$;
  • 当遇到 () 时,当前的深度 $-1$ 就是根节点到此处的距离;
  • 时间复杂度为 $O(n)$ 可以通过此题。

算法步骤

  1. 扫描字符串,记为 $s_i$;
  2. 对 $s_i$ 作判断,( 和 ) 需要分情况讨论;
  3. 如果遇到 (,深度 $+1$,并且,如果下一个字符是 ) 说明找到了叶节点,将 深度-1 记录到答案,需要注意下个字符是否为合法边界;
  4. 如果遇到 ),深度 $-1$;
  5. 输出答案。

代码

#include <bits/stdc++.h>  
#define int long long // 将所有的 int 替换成 long long,否则会爆 int  
using namespace std;  
string s;  
int ans,depth,i;  
signed main(){ // 因为 int 会被替换成 long long,但是返回值不允许 long long,所以使用 signed  
    cin>>s; // 对应步骤 1  
    for(i=0;i<s.length();i++) // 对应步骤 2  
        if(s[i]==\'(\'){ // 对应步骤 3 及下面两行  
            depth++;  
            if(i+1<s.length()&&s[i+1]==\')\') ans+=depth-1; // 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算  注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 
        }else depth--; // 对应步骤 4  
    cout<<ans; // 对应步骤 5  
}

将 typecho 的博客文章下载至本地

如题,这是本人的亲身经历

不废话了,直接开车

走人

正文

下载 typecho_contents 数据库为 SQL 文件

typecho_contents 主要包含一些文章内容、附件等等

所以我们需要下载他
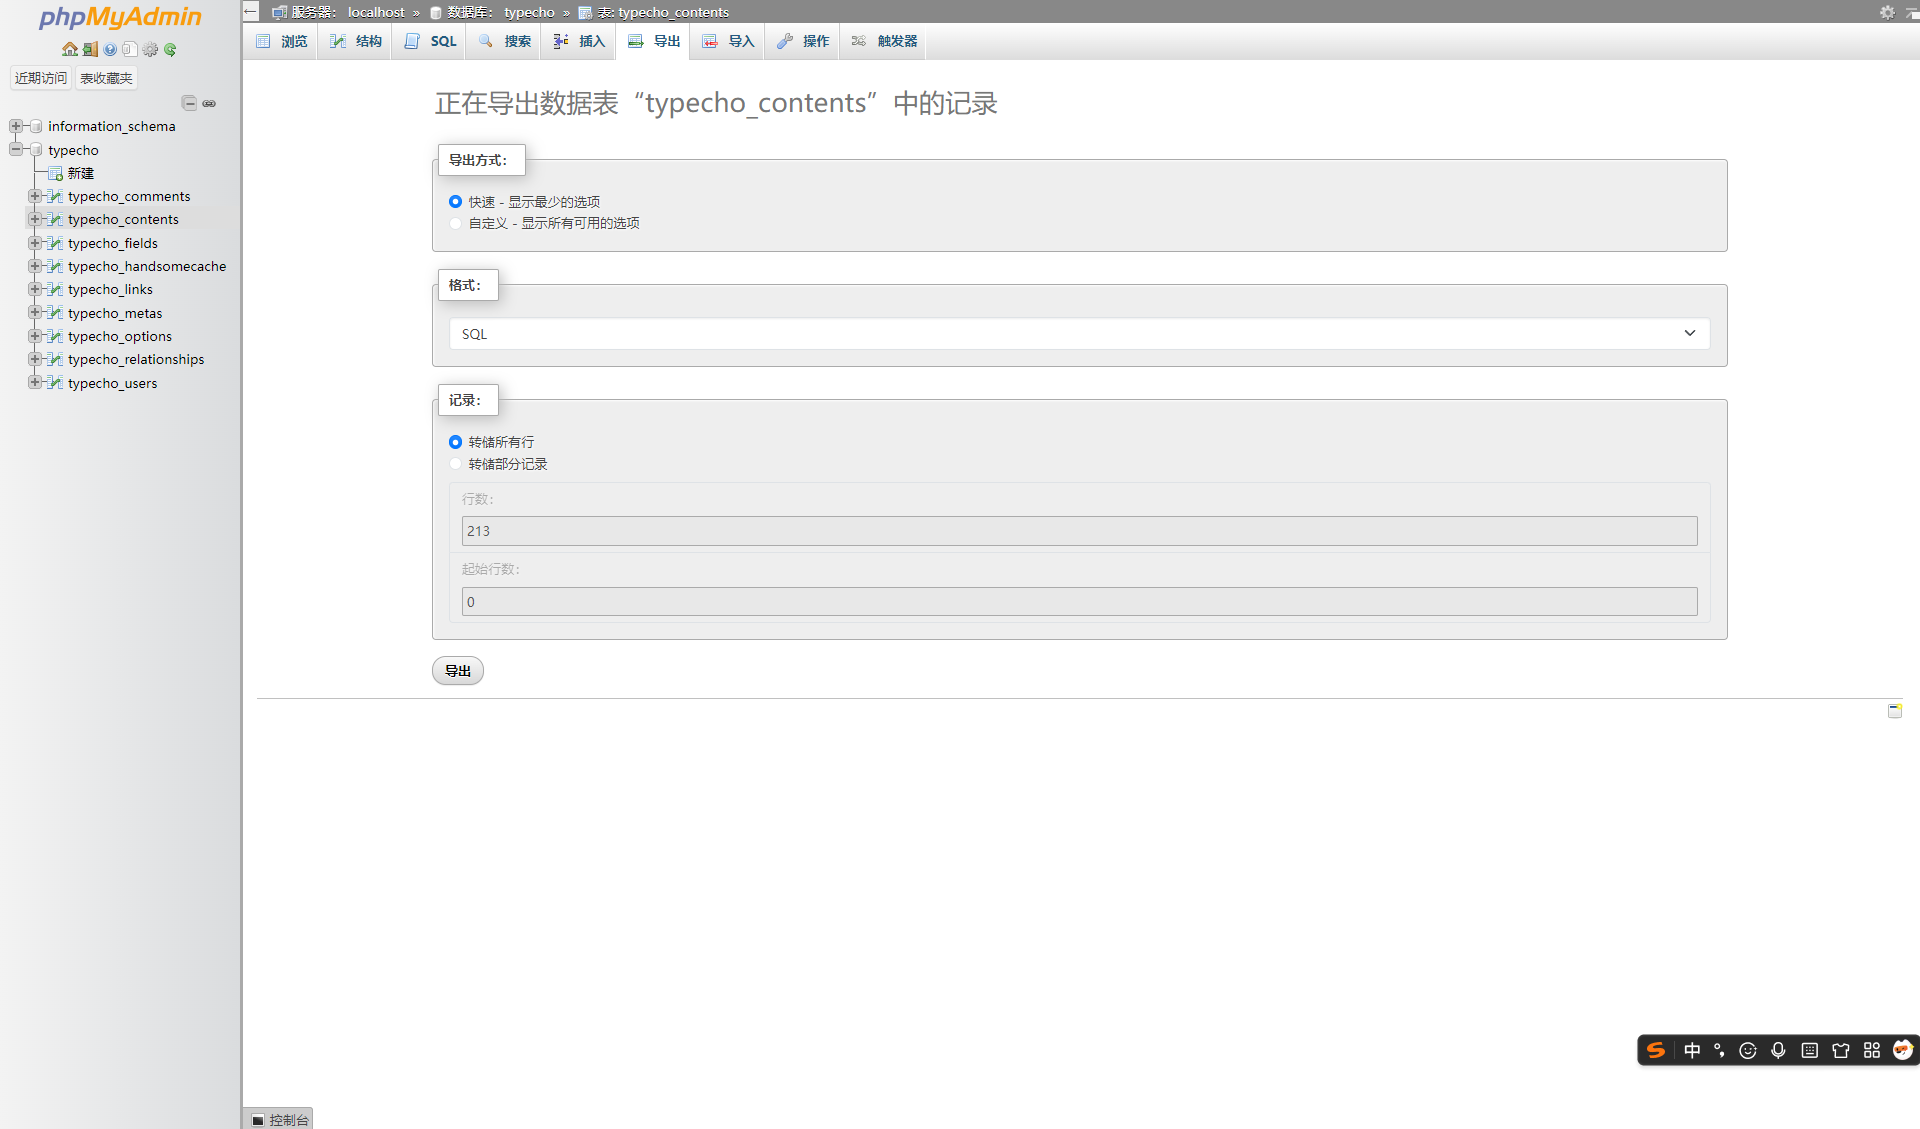
2026-01-21-23-33-11-image.png

如图是使用 phpmyadmin 来导出 typecho_contents 中的记录

导出后,你会得到一个 SQL 文件

你成功了

删除你的 SQL 文件没用的东西

首先,手动打开你的 SQL 文件,找到这个并把下面这部分的内容给复制出来

--
-- 转存表中的数据 `typecho_contents`
--
INSERT INTO `typecho_contents` (`cid`, `title`, `slug`, `created`, `modified`, `text`, `order`, `authorId`, `template`, `type`, `status`, `password`, `commentsNum`, `allowComment`, `allowPing`, `allowFeed`, `parent`, `views`, `stars`) VALUES

复制这里的东西

--
-- 转储表的索引
--

单独把他保存到一个 txt 文件中

然后打开 ./assets/0_clear_nottidy.py,介绍一下,清理 png jpg pdf jpeg 在第二字段所包含的行,其他保留

你需要手动填写两个内容:

  • input_file_path 设置为你的 txt 文件路径,注意一定要有 R,是用来转义的,要用双引号包裹路径
  • output_file_path 设置为你的导出后 txt 文件路径,就是处理后的文件路径,同上

然后使用 python 直接运行,即可完成操作

恭喜你,删除完成,你可以手动浏览一下

从 SQL 文件中分类保存文章至文件夹

打开 ./assets/1_download_md.py,还是简单介绍一下,读取文章名称和时间戳和文章内容,在你所指定的目录下,新建 YYYYMMDD - title 的文件夹,即时间戳对应的年月日加上对应的文章名称,然后在文件夹里面新建 title.md 作为文章的主内容

你需要手动填写:

  • INPUT_FILE:上一次导出的 txt 文件路径,同上

然后还是使用 python 直接运行,即可完成操作

警告:导出后的文件将被保存在 C:/Users/<USER_NAME>/ 下

你可以手动观察一下,你会发现导出的 md 特别变态,所以接下来,我们就要处理换行符的问题 + 图片资源

保存图像附件和处理换行

打开 ./assets/2_make_image_rn_to_n.py,还是简单介绍一下,从 md 里面读取 ![]() 的格式,将 () 下载保存到当前文件夹的 assets 目录里头,然后将 \\r\\n 替换为 \n(不理解这句话内容的自行上网搜索)

你需要手动填写:

  • TARGET_DIR:设置上一次导出文章目录的目录(?)
  • download_url:但是你只需要修改我的 http://www.tropical-fish.cn 部分,修改为你的下载域名,不要加斜杠!!!

然后,你懂的

然后,你就会发现,换行好了,图片资源也被正确保存在了对应的 assets 目录下

你好牛逼啊!!!

处理开头的小插曲

打开 ./assets/3_kill_markdown.py,还是简单减少一下,删除 <!--markdown--> ,没了

你需要手动填写:

  • TARGET_DIR:你上一次导出文章的的目录的目录(?)

然后,你懂的

然后,你完成了

处理完成

资源下载

20260211 - 将 typecho 的博客文章下载至本地 - assets.zip - huang1111网盘

推荐一个 Markdown 编辑器 —— $\text{MarkText}$

Marktext - 一个很牛逼的 Markdown 编辑器!

[题外话] Typora 的落幕

Typora,是一个很牛逼的 Markdown 编辑器,但是,它要钱...
需要 $89$ 元的人民币,虽然是 永久 的授权,但对于学生党来说还是一个不低的价格。
尤其是小学生、初中生、高中生、大学生...(生活费问题)。

转折

但是 Markdown 是一个应用很广泛的标记语言(例如 OI),所以必定有一些替代品。
在这一堆可选的替代品中,首选的就是 Marktext,很适合从 Typora 过渡,使用根本差不多。

那么,现在就开始搞...

正文

简介

Github 官网:marktext/marktext: 📝A simple and elegant markdown editor, available for Linux, macOS and Windows.。
当然,你可能进不去,因为 Github 服务器位于海外,所以你需要 Using the internet securely 或者 Using Watt Tookit 的合法加速器。

🔆 下一代 Markdown 编辑器 🌙
一款简单优雅的开源 markdown 编辑器,注重速度和可用性。
适用于 Linux、macOS 和 Windows。

更多内容请查看该项目的 readme.md 文件

警告

我们是中文用户,我们将会使用非官方汉化的版本。
即 topabomb/marktext-specialedition: marktext0.17.1分叉的中文特别版

下载 & 解压程序

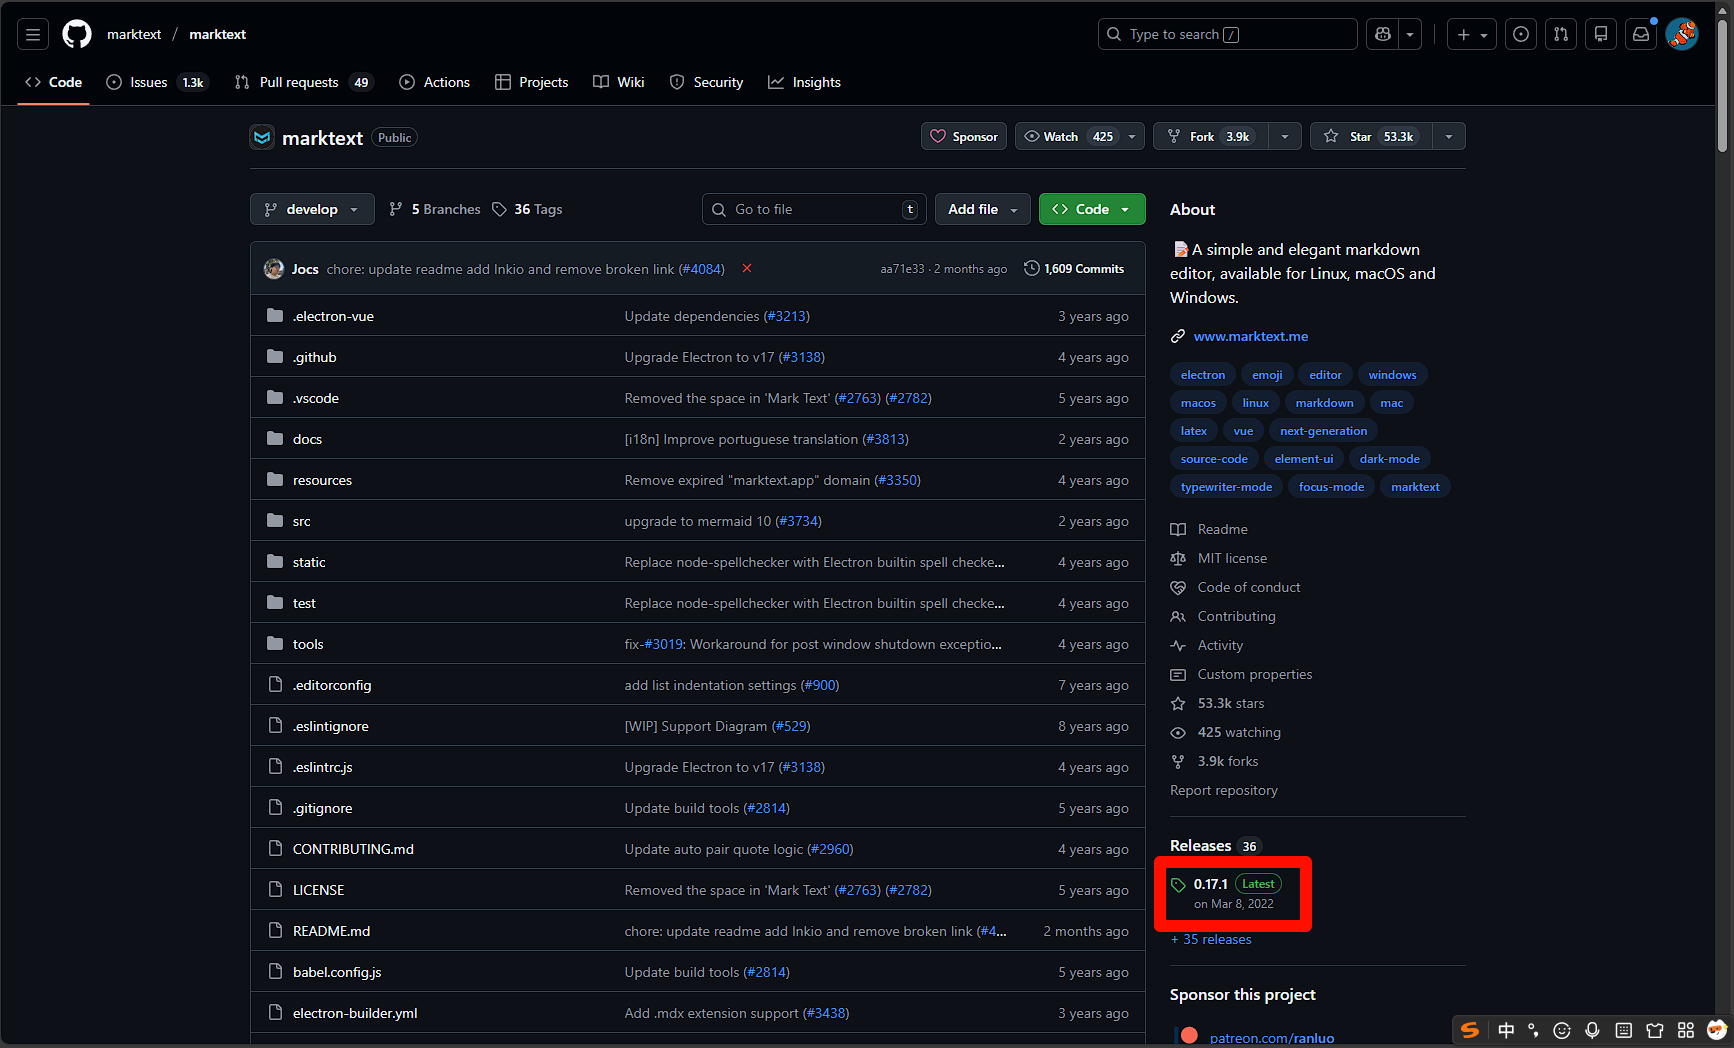
首先,进入到该软件的 Github 仓库页面(如上节)。

单击 Release 进入到该项目的软件发行页面,如 图1,版本号不一定为如图的版本.

图1

随后,找到 Assets 部分。

选择你需要的版本下载,例如 marktext-1.0beta-win64.zip,单击即可下载。

或者,你也可以直接单击 这个链接 进行下载。

注意,下载的文件格式为 zip。

然后,使用 Windows 自带的解压缩工具进行解压,或者使用你想要的解压工具解压,将其剪切到你的软件安装目录中,例如 C:\Program Files\Marktext。

首次运行程序

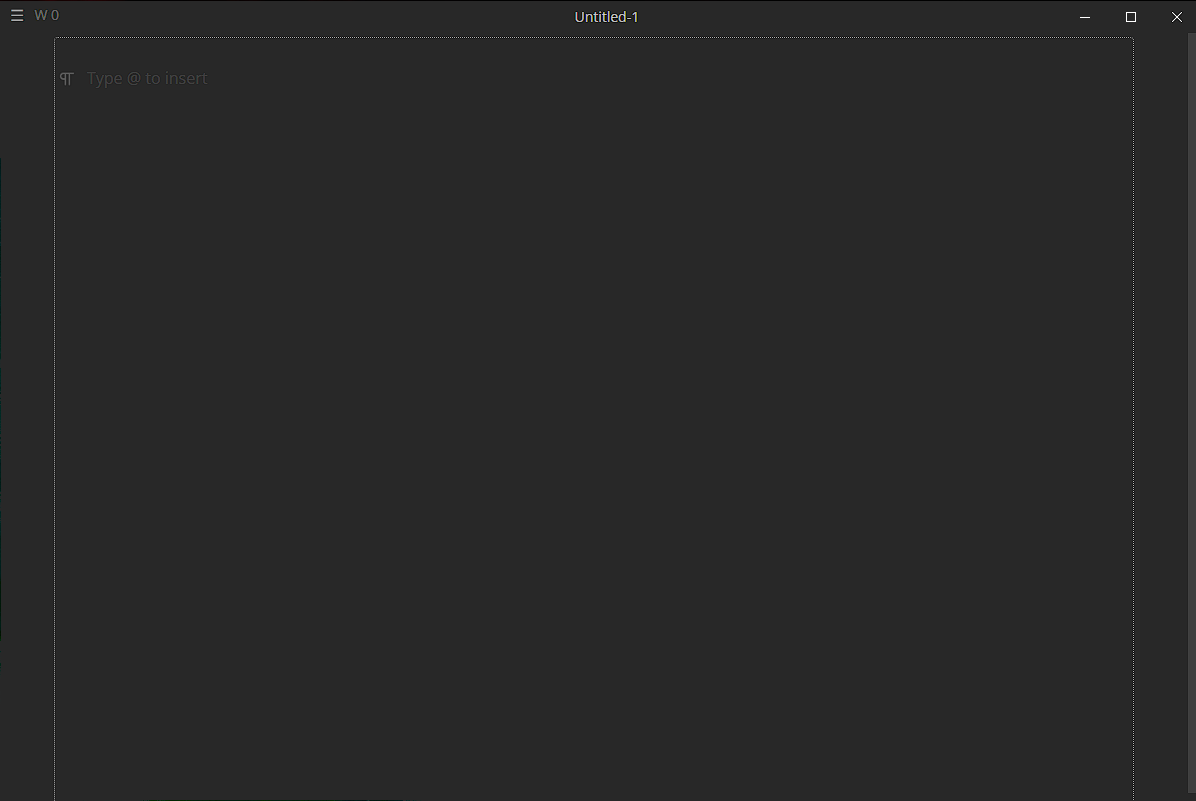
解压后,直接双击 MarkText.exe 即可打开主程序,界面如 图2。

图2

在这里,就可以直接键入 Markdown 字符了,所见即所得。

温馨提示:似乎只有这个界面有英文。

它会自动设置与你系统主题相同的主题。

与 Typora 不一样的地方

你需要按下 Ctrl 与 E 建才能开启源代码模式。

你不能在源代码模式下撤销更改。

默认开启 MathJax,即 Latex(Katex)。

你不能将 md 导出为 docx。

其他资源

如果你仍需要 Typora 破解版,这是一份可用的破解版:typora。

Thanks for reading.

[FBC-1] FMCRAFTOJ 2026 年 1 月月赛 - J 组 - Round 1

变革时段

在以后,我们将使用新的命名方式命名比赛名称。
例如,FC-M-2601 的意义是 FMCRAFT 竞赛 - 月赛 - 26 年 1 月 - J 组第 1 轮

正文

众所周知,每场比赛都需要一个头图
image.png


本场比赛为 [FC-M-2601-J1] FMCRAFTOJ 2026 年 1 月月赛 - J 组 - Round 1,简称 [FC-M-2601-J1],题目非常简单,欢迎来挑战!


本场比赛的时间安排:

比赛开始于: Hour:   Minute:

比赛结束于: Hour:   Minute:


本场比赛,共计 $4$ 题,为月末月赛,本比赛页面是 J 组第 $1$ 轮,难度略比 CSP-J 简单,但是题目难度跨越大,但是涉及算法不一定符合,难度按出题人主观升序排序。


本场比赛的工作人员:

  • 负责人:DHEnryMC
  • 组织者:DHEnryMC
  • 出题人:DHEnryMC
  • 验题人:DHEnryMC
  • 审核员:DHEnryMC

全特么 DHEnryMC,额但是,当下的。。。


赛时不得做出任何影响公平性的行为,包括 GenAI。
如果做了,你的成绩会被取消,赛后会对代码抽样检查。如果代码过少会全部检查。


| 题目编号 | 题目名称 | 内存限制 | 时间限制 |
| - | - | - | - |
| A | 字符统计 | 1024 M | 1 S |
| B ||||
| C ||||
| D ||||


奖金安排:

  • 第一名:5 人民币

参赛地址:

[比赛1001 - [FC-M-2601-J1] FMCRAFTOJ 2026 年 1 月月赛 - J 组 - Round 1 - FMCRAFT-OnlineJudge](https://oj.fmcraft.top/contest.php?cid=1001)

本场比赛不设立同步赛。

不需要报名,注册完成等比赛开始就可以直接做题


请支持我们的比赛,谢谢!

BoxIM For Windows V1.0 更新日志

更新

功能性

  • 内嵌网页
  • 支持一些小工具(可拖动)
  • 下载文件选择保存位置
  • 登录成功 Windows 通知

已知 BUG

  • 可能会闪退

未来会解决的问题

  • 消息通知
  • 窗口图标

截图

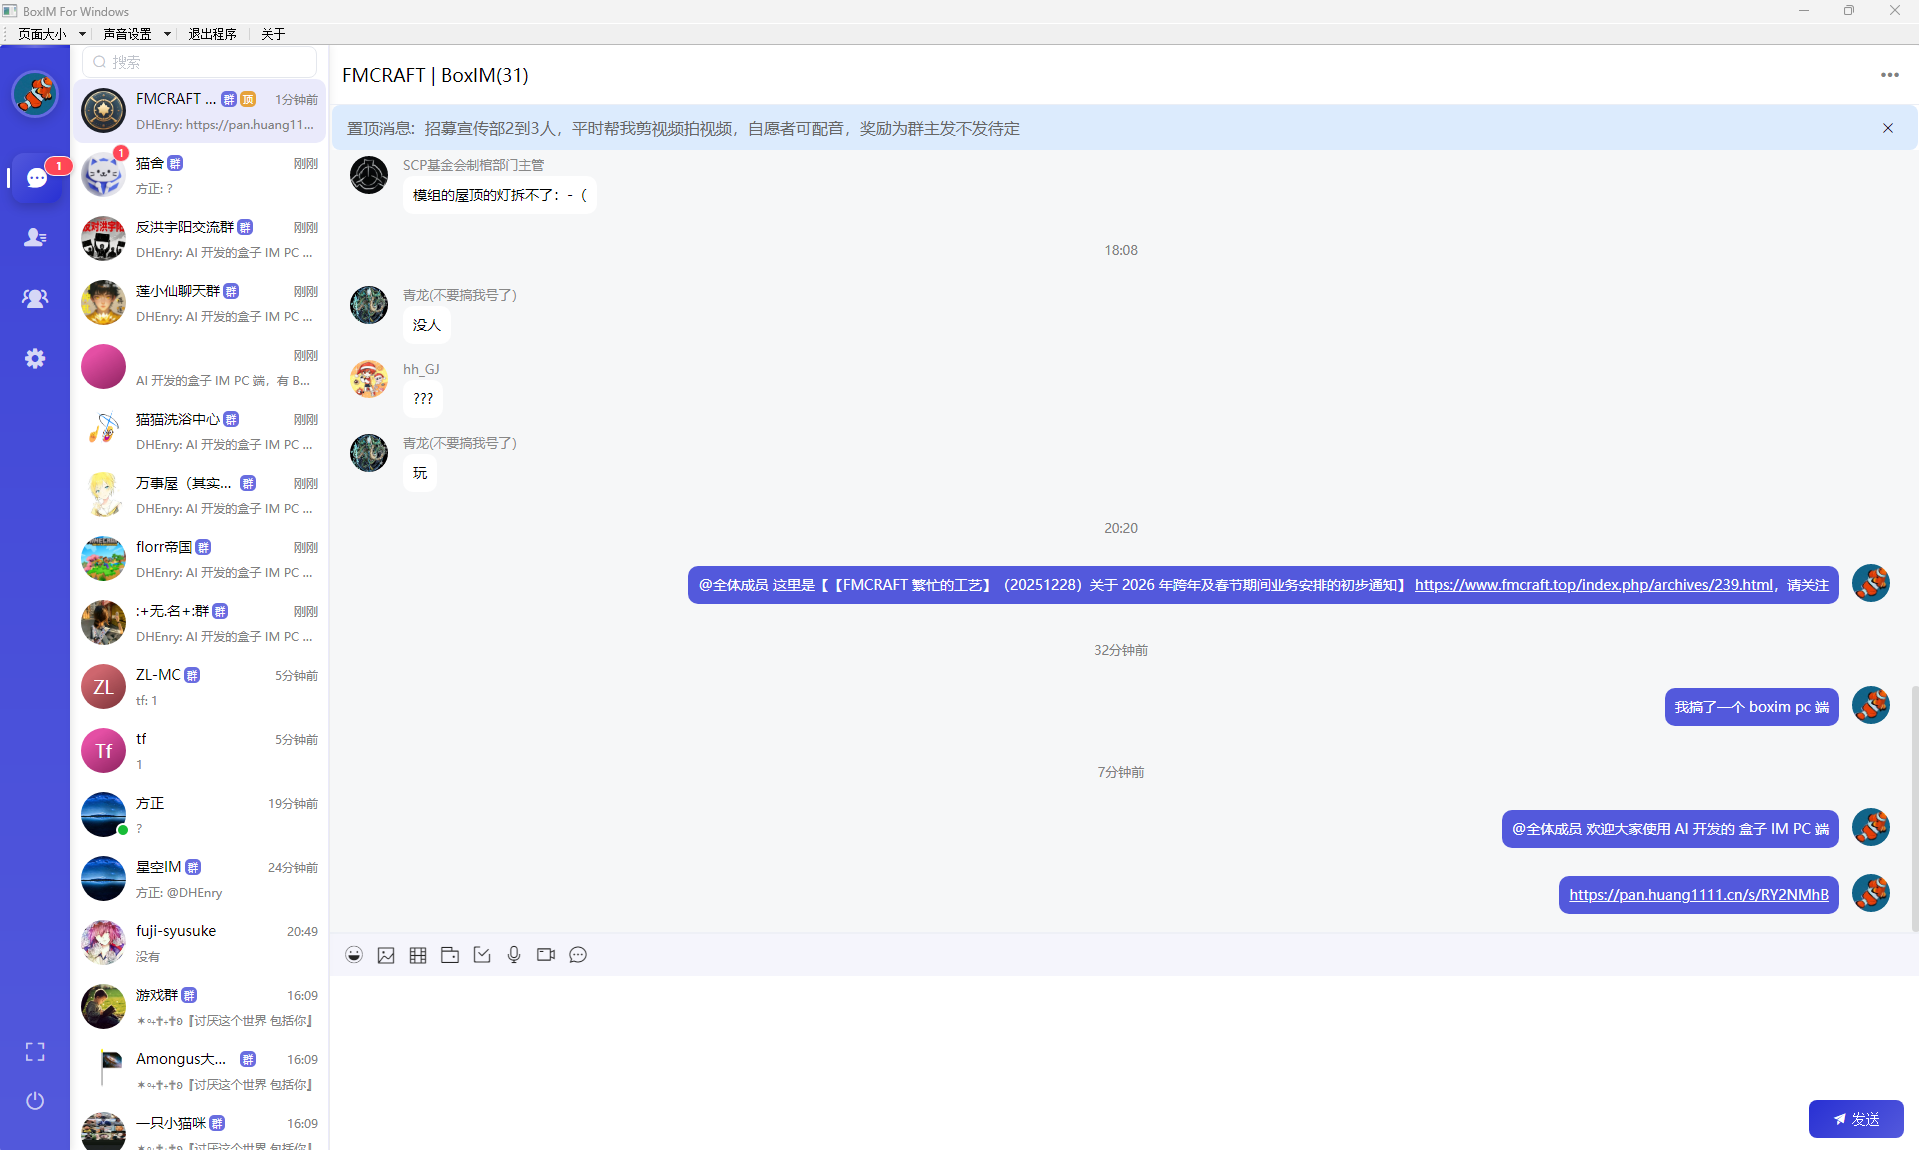
工具栏

主界面


警告

  • 初次版本,肯定有很多莫名其妙的 BUG
  • 该版本由 AI 主编
  • 该项目不是官方项目
  • 初测阶段,为了更方便的收集 BUG,展示命令行

下载

https://pan.huang1111.cn/s/RY2NMhB

永久性 URL

abc437

题面

A - 英尺

分值:100 分

题目描述

1 英尺等于 12 英寸。
请问 A 英尺 B 英寸换算成英寸是多少英寸?

约束条件

  1. $1 \leq A \leq 8$
  2. $0 \leq B \leq 11$
  3. 所有输入值均为整数

输入格式

输入通过标准输入按以下格式给出:

A B

输出格式

将答案输出在一行中。省略单位(英寸)进行输出。

输入样例 1

6 7

输出样例 1

79

6 英尺 7 英寸换算成英寸为 $6 \times 12 + 7 = 79$ 英寸。

输入样例 2

4 11

输出样例 2

59

4 英尺 11 英寸换算成英寸为 $4 \times 12 + 11 = 59$ 英寸。

输入样例 3

8 0

输出样例 3

96

8 英尺 0 英寸换算成英寸为 $8 \times 12 + 0 = 96$ 英寸。


B - 幸运抽奖

题目描述

有一个 $H$ 行 $W$ 列的网格。每个格子中写着一个整数,所有整数互不相同。从上到下第 $i$ 行、从左到右第 $j$ 列的格子中写有整数 $A_{i,j}$。

现在,主持人喊出了 $N$ 个互不相同的整数 $B_1, \dots, B_N$。

对于每一行,计算出主持人喊出的整数中,有多少个出现在该行中。这些数量的最大值是多少?

约束条件

$1 \leq H \leq 3$
$1 \leq W \leq 5$
$1 \leq N \leq 90$
$1 \leq A_{i,j} \leq 90$
$A_{i,j}$ 互不相同
$1 \leq B_i \leq 90$
$B_i$ 互不相同
所有输入值均为整数

输入格式

输入通过标准输入给出,格式如下:

H W N
A_{1,1} ... A_{1,W}
...
A_{H,1} ... A_{H,W}
B_1
...
B_N

输出格式

输出一行,包含答案。

输入样例 1

3 4 5
12 3 5 7
6 10 11 9
1 2 4 8
2
4
9
6
11

输出样例 1

3

输入样例 2

3 5 2
81 63 31 16 15
30 3 6 54 24
26 41 48 64 66
44
79

输出样例 2

0

输入样例 3

3 5 12
78 19 70 58 83
12 30 80 20 27
48 71 8 43 82
82
30
43
8
80
70
20
78
12
71
19
48

输出样例 3

5

C - 驯鹿与雪橇 2

题目描述

有 $N$ 头驯鹿和 1 架雪橇。第 $i$ 头驯鹿的体重为 $W_i$,力量为 $P_i$。

对于每头驯鹿,需要选择是让它“拉雪橇”还是“乘坐雪橇”。
但是,拉雪橇的驯鹿的力量总和必须大于等于乘坐雪橇的驯鹿的体重总和。
最多可以让多少头驯鹿乘坐雪橇?

给定 $T$ 个测试用例。请分别回答每个用例。

约束条件

$1 \leq T \leq 10^5$
$1 \leq N \leq 3 \times 10^5$
$1 \leq W_i, P_i \leq 10^9$
所有输入值均为整数。
单个输入文件中所有 $N$ 的总和不超过 $3 \times 10^5$。

输入格式

输入通过标准输入给出,格式如下:

T
case_1
case_2
⋮
case_T

每个测试用例的格式如下:

N
W_1 P_1
W_2 P_2
⋮
W_N P_N

输出格式

输出 $T$ 行。第 $i$ 行输出第 $i$ 个测试用例的答案。

输入样例 1

3
3
3 1
4 1
5 9
5
1000000000 1
1000000000 1
1000000000 1
1000000000 1
1000000000 1
10
133180711 458704923
531424946 225863856
141986070 637075158
500770732 289806469
502866767 408857335
559714289 569084545
287444582 992432993
559747907 753133304
432846188 949871298
727072164 756020367

输出样例 1

2
0
6

D - 差之和

题目描述

给定一个长度为 $N$ 的正整数序列 $A = (A_1, A_2, \dots, A_N)$ 和一个长度为 $M$ 的正整数序列 $B = (B_1, B_2, \dots, B_M)$。

求 $\displaystyle \sum_{i=1}^{N} \sum_{j=1}^{M} |A_i - B_j|$ 的值,并对 $998244353$ 取模。

约束条件

$1 \leq N, M \leq 3 \times 10^5$
$1 \leq A_i, B_j < 998244353$
所有输入值均为整数。

输入格式

输入通过标准输入给出,格式如下:

N M
A_1 A_2 ... A_N
B_1 B_2 ... B_M

输出格式

输出一行,包含答案。

输入样例 1

4 2
1 6 9 2
3 1

输出样例 1

26

输入样例 2

8 8
185991676 311812083 311812083 84357963 185991676 185991676 724020528 369175631
455049197 387671868 4361724 724020528 724020528 455049197 455049197 724020528

输出样例 2

529117255

E - 对数组排序

题目描述

有 $N+1$ 个序列 $A_0, A_1, \dots, A_N$。$A_i$ 定义如下:
. $A_0$ 是一个空序列。
. $A_i$ $(1 \le i \le N)$ 是在序列 $A_{x_i}$ $(0 \le x_i < i)$ 的末尾添加整数 $y_i$ 后得到的序列。

找出满足以下条件的排列 $P = (P_1, P_2, \dots, P_N)$(即 $(1, 2, \dots, N)$ 的一个排列):
. 对于 $i = 1, 2, \dots, N-1$,满足以下条件之一:
. $A_{P_i}$ 在字典序上小于 $A_{P_{i+1}}$。
. $A_{P_i} = A_{P_{i+1}}$ 且 $P_i < P_{i+1}$。
换句话说,当将 $A_1, A_2, \dots, A_N$ 按字典序排列(当有多个相同的序列时,索引较小的在前)时,$P$ 就是该排列中出现的索引序列。

约束条件

$1 \leq N \leq 3 \times 10^5$
$0 \leq x_i < i$
$1 \leq y_i \leq 10^9$
所有输入值均为整数。

输入格式

输入通过标准输入给出,格式如下:

N
x_1 y_1
x_2 y_2
⋮
x_N y_N

输出格式

在一行中输出 $P_1, P_2, \dots, P_N$,用空格分隔。

输入样例 1

4
0 2
0 1
2 2
0 1

输出样例 1

2 4 3 1

解释:
$A_1 = (2), A_2 = (1), A_3 = (1, 2), A_4 = (1)$,所以 $P = (2, 4, 3, 1)$。

输入样例 2

5
0 1
0 1
0 1
0 1
0 1

输出样例 2

1 2 3 4 5

输入样例 3

10
0 305186313
1 915059758
0 105282054
1 696409999
3 185928366
3 573289179
6 254538849
3 105282054
5 696409999
8 168629803

输出样例 3

3 8 10 5 9 6 7 1 4 2

F - 曼哈顿圣诞树 2

题目描述

在二维平面上有 $N$ 棵圣诞树。第 $i$ 棵($1 \leq i \leq N$)圣诞树位于坐标 $(X_i, Y_i)$。

给你 $Q$ 个查询。请按顺序处理这些查询。每个查询是以下两种类型之一:

类型 1:以 1 i x y 的形式给出。将第 $i$ 棵圣诞树的坐标改为 $(x, y)$。
类型 2:以 2 L R x y 的形式给出。输出从坐标 $(x, y)$ 到第 $L, L+1, \dots, R$ 棵圣诞树中最远的圣诞树的曼哈顿距离。

这里,坐标 $(x_1, y_1)$ 和 $(x_2, y_2)$ 之间的曼哈顿距离定义为 $|x_1 - x_2| + |y_1 - y_2|$。

约束条件

$1 \leq N, Q \leq 2 \times 10^5$
$-10^9 \leq X_i, Y_i \leq 10^9$
$1 \leq i \leq N$
$1 \leq L \leq R \leq N$
$-10^9 \leq x, y \leq 10^9$
所有输入值均为整数。

输入格式

输入通过标准输入给出,格式如下:

N Q
X_1 Y_1
X_2 Y_2
⋮
X_N Y_N
query_1
query_2
⋮
query_Q

其中,第 $i$ 个查询 query_i 以下列两种格式之一给出:

1 i x y
2 L R x y

输出格式

根据问题描述中的说明,输出查询的答案,每个答案占一行。

输入样例 1

3 4
-1 -1
1 2
-2 1
2 1 2 0 0
2 1 3 -1 2
1 1 0 1
2 1 3 -1 2

输出样例 1

3
3
2

解释:
最初,第 1、2、3 棵圣诞树分别位于坐标 $(-1, -1)$、$(1, 2)$、$(-2, 1)$。
处理每个查询:

  1. 从第 1、2 棵圣诞树到坐标 $(0, 0)$ 的曼哈顿距离分别为 $2$ 和 $3$。因此输出 $3$,即 $2, 3$ 中的最大值。
  2. 从第 1、2、3 棵圣诞树到坐标 $(-1, 2)$ 的曼哈顿距离分别为 $3$、$2$、$2$。因此输出 $3$,即 $3, 2, 2$ 中的最大值。
  3. 将第 1 棵圣诞树的坐标改为 $(0, 1)$。第 1、2、3 棵圣诞树的坐标变为 $(0, 1)$、$(1, 2)$、$(-2, 1)$。
  4. 从第 1、2、3 棵圣诞树到坐标 $(-1, 2)$ 的曼哈顿距离分别为 $2$、$2$、$2$。因此输出 $2$,即 $2, 2, 2$ 中的最大值。

输入样例 2

5 7
-9 5
-2 -9
10 -6
9 8
2 9
1 3 -9 -6
2 3 4 2 7
1 4 -2 -10
2 1 2 0 -10
2 3 4 10 -9
2 3 4 8 7
2 5 5 0 2

输出样例 2

24
24
22
30
9

G - 彩色圣诞树

题目描述

今年的圣诞节季节已经结束,终于到了新年的时刻。高桥正在忙着进行大扫除,要收起圣诞树。

有一棵用三种颜色(红色、蓝色、绿色)装饰的灯泡装饰的圣诞树。圣诞树上有 $N$ 个灯泡,它们由 $N-1$ 条丝带连接。将灯泡视为顶点,丝带视为边,这个图是一棵树。

灯泡编号从 $1$ 到 $N$,丝带编号从 $1$ 到 $N-1$。丝带 $i$ 连接灯泡 $u_i$ 和 $v_i$。灯泡 $i$ 初始亮着红色(如果 $c_i$ 是 R),绿色(如果 $c_i$ 是 G),或蓝色(如果 $c_i$ 是 B)。

高桥正在考虑执行以下操作 $N-1$ 次来移除所有丝带:

  1. 从尚未移除的丝带中选择一条,其两端的灯泡颜色不同,然后移除该丝带。
  2. 设 $u$ 和 $v$ 是被移除丝带两端的灯泡。对于每个灯泡 $u$ 和 $v$,根据以下规则改变它们亮的颜色:

    • 如果之前亮红色,则改为亮绿色。
    • 如果之前亮绿色,则改为亮蓝色。
    • 如果之前亮蓝色,则改为亮红色。

确定高桥是否可以通过重复此操作来移除所有丝带。如果可能,输出一种方法。

给定 $T$ 个测试用例。请解决每个测试用例。

约束条件

$1 \leq T \leq 20000$
$2 \leq N \leq 2000$
$c_i$ 是 R、G 或 B。
$1 \leq u_i, v_i \leq N$
将灯泡视为顶点,丝带视为边,给定的图是一棵树。
$T, N, u_i, v_i$ 是整数。
单个输入文件中所有 $N^2$ 的总和不超过 $2000^2$。

输入格式

输入通过标准输入给出,格式如下:

T
case_1
case_2
⋮
case_T

每个测试用例的格式如下:

N
c_1 c_2 ... c_N
u_1 v_1
u_2 v_2
⋮
u_{N-1} v_{N-1}

输出格式

按顺序输出 case_1, case_2, ..., case_T 的答案,格式如下:

如果无法移除所有丝带,输出 No。

如果可能,设 $e_i$ 为第 $i$ 次操作移除的丝带编号,输出:

Yes
e_1 e_2 ... e_{N-1}

其中 $(e_1, e_2, \dots, e_{N-1})$ 必须是 $(1, 2, \dots, N-1)$ 的一个排列。

如果有多个解,任意一个都将被视为正确。

输入样例 1

3
4
GBBR
1 2
1 3
1 4
3
RRR
1 2
2 3
5
RGBRG
1 2
2 3
3 4
3 5

输出样例 1

Yes
1 3 2
No
Yes
1 4 2 3

解释:
对于第一个测试用例,例如,可以通过以下操作移除所有丝带:

  1. 初始时,灯泡颜色依次(从灯泡 1 开始)为绿色、蓝色、蓝色、红色。
  2. 移除丝带 1。移除后,灯泡颜色依次为蓝色、红色、蓝色、红色。
  3. 移除丝带 3。移除后,灯泡颜色依次为红色、红色、蓝色、绿色。
  4. 移除丝带 2。移除后,灯泡颜色依次为绿色、红色、红色、绿色。
    满足条件的 $(e_1, e_2, e_3)$ 是 $(1, 3, 2)$ 和 $(2, 3, 1)$,任意一个都将被视为正确。

对于第二个测试用例,无论你如何操作,都无法移除所有丝带。

反思

A

本题是一道签到题
根据题意可知:

$$ \text{总英寸数} = A \times 12 + B $$

由于题目的数据范围过小,可直接使用顺序结构求解
以下是我赛场时的代码

#include <bits/stdc++.h>
using namespace std;
int a,b;
int main(){
    cin>>a>>b;
    cout<<a*12+b;
}

B

题目的意思就是:题目要求计算每一行中主持人喊出的整数出现的个数,并输出这些个数的最大值
由于数据范围过小,可直接使用数组存储,不需要使用任何数据优化方案
思路:

  1. 读入 $H,W,N$
  2. 用二维数组 $A$ 存储矩阵
  3. 用一个大小为 $91$ (∵ $1 \leq B_i \leq 90$)的布尔数组 isB 标记 $B$ 中的数
  4. 对每一行遍历,统计这一行中有多少个数在 isB 中被标记为 true
  5. 记录这些统计数的最大值并输出
    以下是我赛时的代码:
#include <bits/stdc++.h>
using namespace std;
int H,W,N,i,j,b,cnt,ma,a[5][6],fl[91];
int main(){
    cin>>H>>W>>N;
    for(i=0;i<H;i++) for(j=0;j<W;j++) cin>>a[i][j];
    for(i=0;i<N;i++){
        cin>>b;fl[b]=1;
    }
    for(i=0;i<H;i++){
        cnt=0;
        for(j=0;j<W;j++) if(fl[a[i][j]]) cnt++;
        if(cnt>ma) ma=cnt;
    }
    cout<<ma;
}

根据题目思路就可以得出代码,非常 Easy

C

这题我在赛时并没有得出正确程序
赛后,我邀请 deepseek 完成此题,我将对 deepseek 的内容进行阐述

算法:贪心
题目阐述:有 (N) 头驯鹿,每头驯鹿有体重 (W_i) 和力量 (P_i)。选择一部分驯鹿“乘坐雪橇”,剩下的“拉雪橇”。要求“拉雪橇”的驯鹿的力量总和 ≥ “乘坐雪橇”的驯鹿的体重总和。问最多可以让多少头驯鹿乘坐雪橇
问题转化为:在不超过总力量 (S) 的前提下,最多能选择多少头驯鹿,使得它们的 (W_i + P_i) 之和不超过 (S)。这是一个典型的贪心问题:按 (W_i + P_i) 从小到大选择,直到总和超过 (S)
对每个测试用例:

  1. 读入 (N) 和每头驯鹿的 (W_i, P_i)
  2. 计算总力量 (S = \sum P_i)
  3. 计算每头驯鹿的 (a_i = W_i + P_i),并排序
  4. 从小到大累加 (a_i),直到总和超过 (S),累加的个数即为答案
    时间复杂度:$O(N \operatorname{log} N)$

这是 deepseek 给出的代码:

#include<iostream>
#include<algorithm>
using namespace std;
int T,N,i,cnt;
long long totalP,sum,W,P;
long long a[100005];

int main(){
    cin>>T;
    while(T--){
        cin>>N;
        totalP=0;
        for(i=0;i<N;i++){
            cin>>W>>P;
            a[i]=W+P;
            totalP+=P;
        }
        sort(a,a+N);
        sum=0;
        cnt=0;
        for(i=0;i<N;i++){
            if(sum+a[i]<=totalP){
                sum+=a[i];
                cnt++;
            }else{
                break;
            }
        }
        cout<<cnt<<endl;
    }
    return 0;
}