分类 信息技术 下的文章

m3u8 下载器

简介

一款m3u8批量下载的软件,支持部分分分加密的m3u8文件,有些加密的应该是没办法搞定

当复制到链接的时候会自动粘贴进入,不需要自己手动点复制粘贴

其它信息如图,自己测试了还能用,不知道其他老铁们能不能正常用,有兴趣的可以源码查看修改.....

不喜勿喷

关于为什么要从吾爱复制这个东西,因为觉得这个东西是真的有用,然而有时又可能找不到

图片
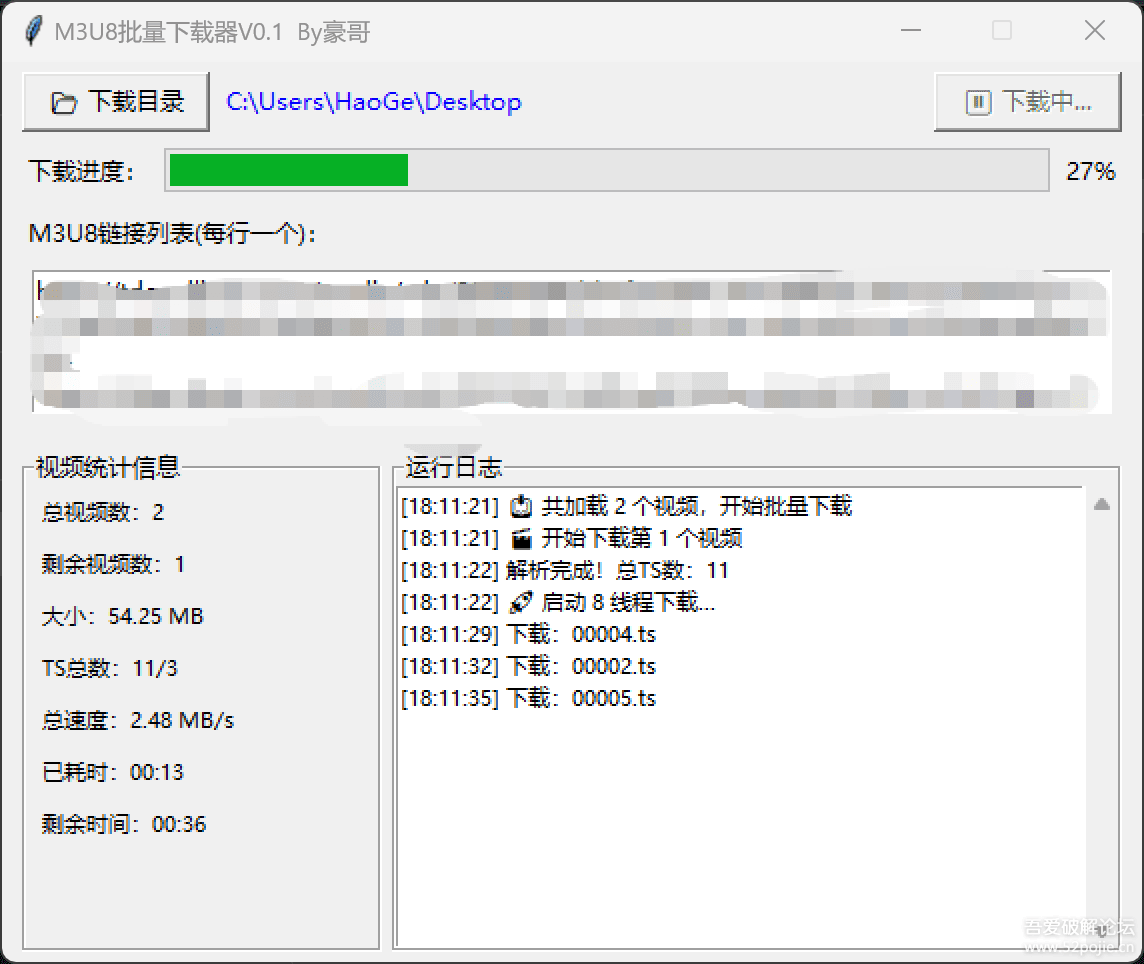
mnvso78g.png

源代码

import tkinter as tk
from tkinter import ttk, filedialog, messagebox
import threading
import queue
import os
import time
import requests
import m3u8
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import urljoin
from Crypto.Cipher import AES
from Crypto.Util.Padding import unpad
 
# -------------------------- 配置项 --------------------------
DEFAULT_THREAD_NUM = 8
TIMEOUT = 15
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows 10; Win64; x64) AppleWebKit/537.36"
}
DEFAULT_PATH = os.path.join(os.path.expanduser("~"), "Desktop")
 
 
# ------------------------------------------------------------
 
class M3U8Downloader(tk.Tk):
    def __init__(self):
        super().__init__()
        self.title("M3U8批量下载器V0.1  By豪哥")
        self.geometry("570x450")
        self.resizable(False, False)
 
        # 全局变量
        self.save_path = tk.StringVar(value=DEFAULT_PATH)
        self.total_ts = 0
        self.finish_ts = 0
        self.msg_queue = queue.Queue()
        self.is_downloading = False
        self.key = None
        self.iv = None
        self.last_clipboard = ""
        self.thread_num = tk.IntVar(value=DEFAULT_THREAD_NUM)
        self.last_link = ""
 
        # 下载计时&速度统计
        self.start_time = 0
        self.total_downloaded_bytes = 0
 
        # 批量下载变量
        self.video_list = []
        self.current_video_idx = 0
        self.total_videos = 0
        self.remaining_videos = 0  # 剩余视频数量
        self.video_size = 0.00
 
        self.init_ui()
        self.check_queue()
        self.watch_clipboard()
        self.link_text.bind("<<Modified>>", self.on_link_changed)
 
    def init_ui(self):
        """初始化界面"""
        # ====================== 顶部按钮区域 ======================
        top_frame = tk.Frame(self, pady=5)
        top_frame.pack(fill=tk.X, padx=10)
 
        self.btn_path = tk.Button(
            top_frame, text="&#128194; 下载目录", command=self.select_save_path,
            width=12, font=("微软雅黑", 9)
        )
        self.btn_path.pack(side=tk.LEFT)
 
        self.label_path = tk.Label(
            top_frame, textvariable=self.save_path, fg="blue", font=("微软雅黑", 9)
        )
        self.label_path.pack(side=tk.LEFT, padx=5)
 
        self.btn_start = tk.Button(
            top_frame, text="&#9654;&#65039; 开始下载", command=self.start_batch_download,
            width=12, font=("微软雅黑", 9)
        )
        self.btn_start.pack(side=tk.RIGHT)
 
        # ====================== 进度条+百分比 ======================
        progress_frame = tk.Frame(self, pady=3)
        progress_frame.pack(fill=tk.X, padx=10)
        tk.Label(progress_frame, text="下载进度:", font=("微软雅黑", 9)).pack(side=tk.LEFT)
 
        self.progress_bar = ttk.Progressbar(progress_frame, mode="determinate", length=380)
        self.progress_bar.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=5)
 
        self.progress_label = tk.Label(progress_frame, text="0%", font=("微软雅黑", 9))
        self.progress_label.pack(side=tk.LEFT)
 
        # ====================== M3U8链接列表 + 线程选择 ======================
        link_frame = tk.Frame(self, pady=5)
        link_frame.pack(fill=tk.X, padx=10)
        tk.Label(link_frame, text="M3U8链接列表(每行一个):", font=("微软雅黑", 9)).pack(anchor=tk.W)
 
        self.link_text = tk.Text(link_frame, height=4, font=("微软雅黑", 9))
        self.link_text.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=5)
        self.link_text.edit_modified(False)
 
        # 右侧:线程数选择
        thread_frame = tk.Frame(link_frame)
        thread_frame.pack(side=tk.RIGHT, padx=5)
 
        tk.Label(thread_frame, text="下载线程:", font=("微软雅黑", 9)).pack(anchor=tk.N)
        self.thread_combobox = ttk.Combobox(
            thread_frame, textvariable=self.thread_num,
            values=[1, 2, 4, 8, 16, 32], state="readonly", width=5
        )
        self.thread_combobox.current(3)
        self.thread_combobox.pack(anchor=tk.N)
 
        self.btn_clear = tk.Button(
            thread_frame, text="清空", command=self.clear_link,
            width=6, font=("微软雅黑", 9)
        )
        self.btn_clear.pack(anchor=tk.N, pady=5)
 
        # ====================== 左右分栏布局 ======================
        bottom_frame = tk.Frame(self, pady=5)
        bottom_frame.pack(fill=tk.BOTH, expand=True, padx=10)
 
        # 左侧:视频统计信息
        self.stats_frame = tk.LabelFrame(bottom_frame, text="视频统计信息", font=("微软雅黑", 9), width=180)
        self.stats_frame.pack(side=tk.LEFT, fill=tk.BOTH, padx=(0, 5))
        self.stats_frame.pack_propagate(False)
 
        # ========== 【总视频 + 剩余视频】 ==========
        self.label_total_videos = tk.Label(self.stats_frame, text=f"总视频数:0", font=("微软雅黑", 8))
        self.label_total_videos.pack(anchor=tk.W, padx=5, pady=2)
 
        self.label_remaining_videos = tk.Label(self.stats_frame, text=f"剩余视频数:0", font=("微软雅黑", 8))
        self.label_remaining_videos.pack(anchor=tk.W, padx=5, pady=2)
        # ==========================================
 
        # 视频大小
        self.label_size = tk.Label(self.stats_frame, text=f"大小:{self.video_size:.2f} MB", font=("微软雅黑", 8))
        self.label_size.pack(anchor=tk.W, padx=5, pady=2)
        # TS总数/已下载
        self.label_ts_info = tk.Label(self.stats_frame, text=f"TS总数:{self.total_ts}/{self.finish_ts}", font=("微软雅黑", 8))
        self.label_ts_info.pack(anchor=tk.W, padx=5, pady=2)
        # 总下载速度
        self.label_speed = tk.Label(self.stats_frame, text="总速度:0.00 MB/s", font=("微软雅黑", 8))
        self.label_speed.pack(anchor=tk.W, padx=5, pady=2)
        # 已耗时
        self.label_cost = tk.Label(self.stats_frame, text="已耗时:00:00", font=("微软雅黑", 8))
        self.label_cost.pack(anchor=tk.W, padx=5, pady=2)
        # 预估剩余时间
        self.label_remain = tk.Label(self.stats_frame, text="剩余时间:--:--", font=("微软雅黑", 8))
        self.label_remain.pack(anchor=tk.W, padx=5, pady=2)
 
        # 右侧:运行日志
        log_frame = tk.LabelFrame(bottom_frame, text="运行日志", font=("微软雅黑", 9))
        log_frame.pack(side=tk.RIGHT, fill=tk.BOTH, expand=True)
 
        log_scroll = tk.Scrollbar(log_frame)
        log_scroll.pack(side=tk.RIGHT, fill=tk.Y)
        self.log_text = tk.Text(
            log_frame, height=5, font=("微软雅黑", 8),
            yscrollcommand=log_scroll.set, state=tk.DISABLED
        )
        self.log_text.pack(side=tk.LEFT, fill=tk.BOTH, expand=True)
        log_scroll.config(command=self.log_text.yview)
 
    def time_format(self, seconds):
        """秒数转换为 分:秒 格式"""
        if seconds < 0:
            return "00:00"
        m = int(seconds // 60)
        s = int(seconds % 60)
        return f"{m:02d}:{s:02d}"
 
    def on_link_changed(self, event):
        """链接框内容变化 → 自动更新总视频数"""
        self.link_text.edit_modified(False)
        links = self.link_text.get(1.0, tk.END).strip().splitlines()
        valid_links = [l.strip() for l in links if l.strip().startswith("http")]
 
        # 自动统计视频数量
        self.total_videos = len(valid_links)
        self.remaining_videos = self.total_videos
        self.update_video_count_labels()
 
        if self.is_downloading:
            return
 
        first_link = next((l.strip() for l in valid_links), "")
        if first_link == self.last_link:
            return
        self.last_link = first_link
        if not first_link:
            self.reset_stats()
            return
        threading.Thread(target=self.pre_parse_m3u8_info, args=(first_link,), daemon=True).start()
 
    def update_video_count_labels(self):
        """更新总视频数 / 剩余视频数"""
        self.label_total_videos.config(text=f"总视频数:{self.total_videos}")
        self.label_remaining_videos.config(text=f"剩余视频数:{self.remaining_videos}")
 
    def pre_parse_m3u8_info(self, m3u8_url):
        """预解析M3U8信息"""
        try:
            m3u8_obj = m3u8.load(m3u8_url, headers=HEADERS, timeout=TIMEOUT)
            temp_size = 0.0
            if m3u8_obj.playlists:
                new_url = urljoin(m3u8_url, m3u8_obj.playlists[-1].uri)
                m3u8_obj = m3u8.load(new_url, headers=HEADERS, timeout=TIMEOUT)
            temp_total_ts = len(m3u8_obj.segments)
            for seg in m3u8_obj.segments:
                temp_size += seg.duration * 0.5
            self.video_size = temp_size
            self.total_ts = temp_total_ts
            self.finish_ts = 0
            self.update_stats()
        except Exception as e:
            self.reset_stats()
 
    def reset_stats(self):
        """重置统计信息"""
        self.video_size = 0.00
        self.total_ts = 0
        self.finish_ts = 0
        self.total_downloaded_bytes = 0
        self.start_time = 0
        self.update_stats()
 
    def watch_clipboard(self):
        """监听剪贴板,自动换行添加链接"""
        try:
            content = self.clipboard_get().strip()
            if content != self.last_clipboard and content.startswith("http") and ("m3u8" in content):
                self.last_clipboard = content
                self.link_text.insert(tk.END, content + "\n")
        except:
            pass
        self.after(1000, self.watch_clipboard)
 
    def select_save_path(self):
        path = filedialog.askdirectory(title="选择保存目录", initialdir=DEFAULT_PATH)
        if path:
            self.save_path.set(path)
 
    def clear_link(self):
        self.link_text.delete(1.0, tk.END)
        self.total_videos = 0
        self.remaining_videos = 0
        self.update_video_count_labels()
        self.reset_stats()
 
    def write_log(self, msg):
        self.msg_queue.put(("log", msg))
 
    def update_progress(self):
        self.msg_queue.put(("progress", None))
 
    def update_stats(self):
        self.msg_queue.put(("stats", None))
 
    def download_finish(self):
        self.msg_queue.put(("finish", None))
 
    def check_queue(self):
        """刷新GUI(线程安全)"""
        while not self.msg_queue.empty():
            task, data = self.msg_queue.get()
            if task == "log":
                self.log_text.config(state=tk.NORMAL)
                self.log_text.insert(tk.END, f"[{time.strftime('%H:%M:%S')}] {data}\n")
                self.log_text.config(state=tk.DISABLED)
                self.log_text.see(tk.END)
            elif task == "progress":
                percent = int(self.finish_ts / self.total_ts * 100) if self.total_ts > 0 else 0
                self.progress_bar["value"] = self.finish_ts
                self.progress_label.config(text=f"{percent}%")
                self.label_ts_info.config(text=f"TS总数:{self.total_ts}/{self.finish_ts}")
                if self.finish_ts > 0 and self.start_time > 0:
                    cost_time = time.time() - self.start_time
                    speed_mb = (self.total_downloaded_bytes / 1024 / 1024) / cost_time if cost_time > 0 else 0
                    remain_ts = self.total_ts - self.finish_ts
                    remain_time = (remain_ts * cost_time) / self.finish_ts if self.finish_ts > 0 else 0
                    self.label_speed.config(text=f"总速度:{speed_mb:.2f} MB/s")
                    self.label_cost.config(text=f"已耗时:{self.time_format(cost_time)}")
                    self.label_remain.config(text=f"剩余时间:{self.time_format(remain_time)}")
            elif task == "stats":
                self.label_size.config(text=f"大小:{self.video_size:.2f} MB")
                self.label_ts_info.config(text=f"TS总数:{self.total_ts}/{self.finish_ts}")
                self.label_speed.config(text="总速度:0.00 MB/s")
                self.label_cost.config(text="已耗时:00:00")
                self.label_remain.config(text="剩余时间:--:--")
            elif task == "finish":
                self.is_downloading = False
                self.btn_start.config(state=tk.NORMAL, text="&#9654;&#65039; 开始下载")
                self.progress_label.config(text="0%")
        self.after(50, self.check_queue)
 
    def get_decrypt_key(self, key_uri, base_url):
        try:
            key_url = urljoin(base_url, key_uri)
            res = requests.get(key_url, headers=HEADERS, timeout=TIMEOUT)
            res.raise_for_status()
            return res.content
        except:
            return None
 
    def decrypt_ts(self, ts_data):
        if self.key is None:
            return ts_data
        try:
            cipher = AES.new(self.key, AES.MODE_CBC, self.iv or self.key)
            return unpad(cipher.decrypt(ts_data), AES.block_size)
        except:
            return ts_data
 
    def download_ts(self, ts_url, save_dir, index):
        """下载单个TS分片"""
        ts_name = f"{index:05d}.ts"
        ts_path = os.path.join(save_dir, ts_name)
        try:
            with requests.get(ts_url, headers=HEADERS, timeout=TIMEOUT, stream=True) as r:
                r.raise_for_status()
                ts_data = self.decrypt_ts(r.content)
                self.total_downloaded_bytes += len(ts_data)
                with open(ts_path, "wb") as f:
                    f.write(ts_data)
            self.write_log(f"下载:{ts_name}")
            self.finish_ts += 1
            self.update_progress()
        except Exception as e:
            self.write_log(f"失败:{ts_name}")
 
    def merge_ts(self, ts_dir, save_path):
        video_name = time.strftime("%Y%m%d_%H%M%S") + ".mp4"
        video_path = os.path.join(save_path, video_name)
        ts_files = sorted([f for f in os.listdir(ts_dir) if f.endswith(".ts")])
        with open(video_path, "wb") as out:
            for ts in ts_files:
                with open(os.path.join(ts_dir, ts), "rb") as f:
                    out.write(f.read())
        for ts in ts_files:
            os.remove(os.path.join(ts_dir, ts))
        os.rmdir(ts_dir)
        self.write_log(f"&#9989; 下载完成!文件地址:{video_path}")
 
    def parse_m3u8(self, m3u8_url):
        m3u8_obj = m3u8.load(m3u8_url, headers=HEADERS, timeout=TIMEOUT)
        self.video_size = 0.0
        if m3u8_obj.playlists:
            new_url = urljoin(m3u8_url, m3u8_obj.playlists[-1].uri)
            return self.parse_m3u8(new_url)
        self.total_ts = len(m3u8_obj.segments)
        for seg in m3u8_obj.segments:
            self.video_size += seg.duration * 0.5
        self.key = None
        self.iv = None
        if m3u8_obj.keys and m3u8_obj.keys[0]:
            key_info = m3u8_obj.keys[0]
            self.key = self.get_decrypt_key(key_info.uri, m3u8_url)
            self.iv = bytes.fromhex(key_info.iv[2:]) if key_info.iv else None
        return m3u8_obj, m3u8_url.rsplit("/", 1)[0] + "/"
 
    def download_single_video(self, m3u8_url):
        """下载单个视频"""
        try:
            self.start_time = time.time()
            self.total_downloaded_bytes = 0
            self.write_log(f"&#127916; 开始下载第 {self.current_video_idx} 个视频")
            m3u8_obj, base_url = self.parse_m3u8(m3u8_url)
            self.update_stats()
            if not m3u8_obj.segments:
                self.write_log("&#10060; 未找到视频分片!")
                return
            self.finish_ts = 0
            self.progress_bar["maximum"] = self.total_ts
            self.progress_bar["value"] = 0
            self.write_log(f"解析完成!总TS数:{self.total_ts}")
            ts_dir = os.path.join(self.save_path.get(), "temp_ts")
            os.makedirs(ts_dir, exist_ok=True)
            thread_count = self.thread_num.get()
            self.write_log(f"&#128640; 启动 {thread_count} 线程下载...")
            with ThreadPoolExecutor(thread_count) as executor:
                for idx, url in enumerate([urljoin(base_url, seg.uri) for seg in m3u8_obj.segments]):
                    executor.submit(self.download_ts, url, ts_dir, idx)
            self.merge_ts(ts_dir, self.save_path.get())
        except Exception as e:
            self.write_log(f"&#128165; 下载异常:{str(e)}")
 
    def batch_download_worker(self):
        """批量下载主逻辑"""
        try:
            links = self.link_text.get(1.0, tk.END).strip().splitlines()
            self.video_list = [link.strip() for link in links if link.strip().startswith("http")]
            self.total_videos = len(self.video_list)
            self.remaining_videos = self.total_videos
            self.current_video_idx = 0
            self.update_video_count_labels()
 
            if self.total_videos == 0:
                messagebox.showerror("错误", "请输入有效的M3U8链接!")
                return
 
            self.write_log(f"&#128229; 共加载 {self.total_videos} 个视频,开始批量下载")
 
            for url in self.video_list:
                self.current_video_idx += 1
                # ========== 【核心修改:开始下载前就 -1】 ==========
                self.remaining_videos -= 1
                self.update_video_count_labels()
                # ================================================
                self.download_single_video(url)
 
            self.write_log("&#127881; 所有视频下载完成!")
            messagebox.showinfo("完成", "全部视频下载成功!")
            self.clear_link()
 
        except Exception as e:
            self.write_log(f"批量下载异常:{str(e)}")
        finally:
            self.download_finish()
 
    def start_batch_download(self):
        """启动批量下载"""
        if self.is_downloading:
            messagebox.showwarning("提示", "正在下载中!")
            return
        self.is_downloading = True
        self.btn_start.config(state=tk.DISABLED, text="&#9208; 下载中...")
        self.log_text.config(state=tk.NORMAL)
        self.log_text.delete(1.0, tk.END)
        self.log_text.config(state=tk.DISABLED)
        threading.Thread(target=self.batch_download_worker, daemon=True).start()
 
 
if __name__ == "__main__":
    app = M3U8Downloader()
    app.mainloop()
将 typecho 的博客文章下载至本地

如题,这是本人的亲身经历

不废话了,直接开车

走人

正文

下载 typecho_contents 数据库为 SQL 文件

typecho_contents 主要包含一些文章内容、附件等等

所以我们需要下载他
2026-01-21-23-33-11-image.png

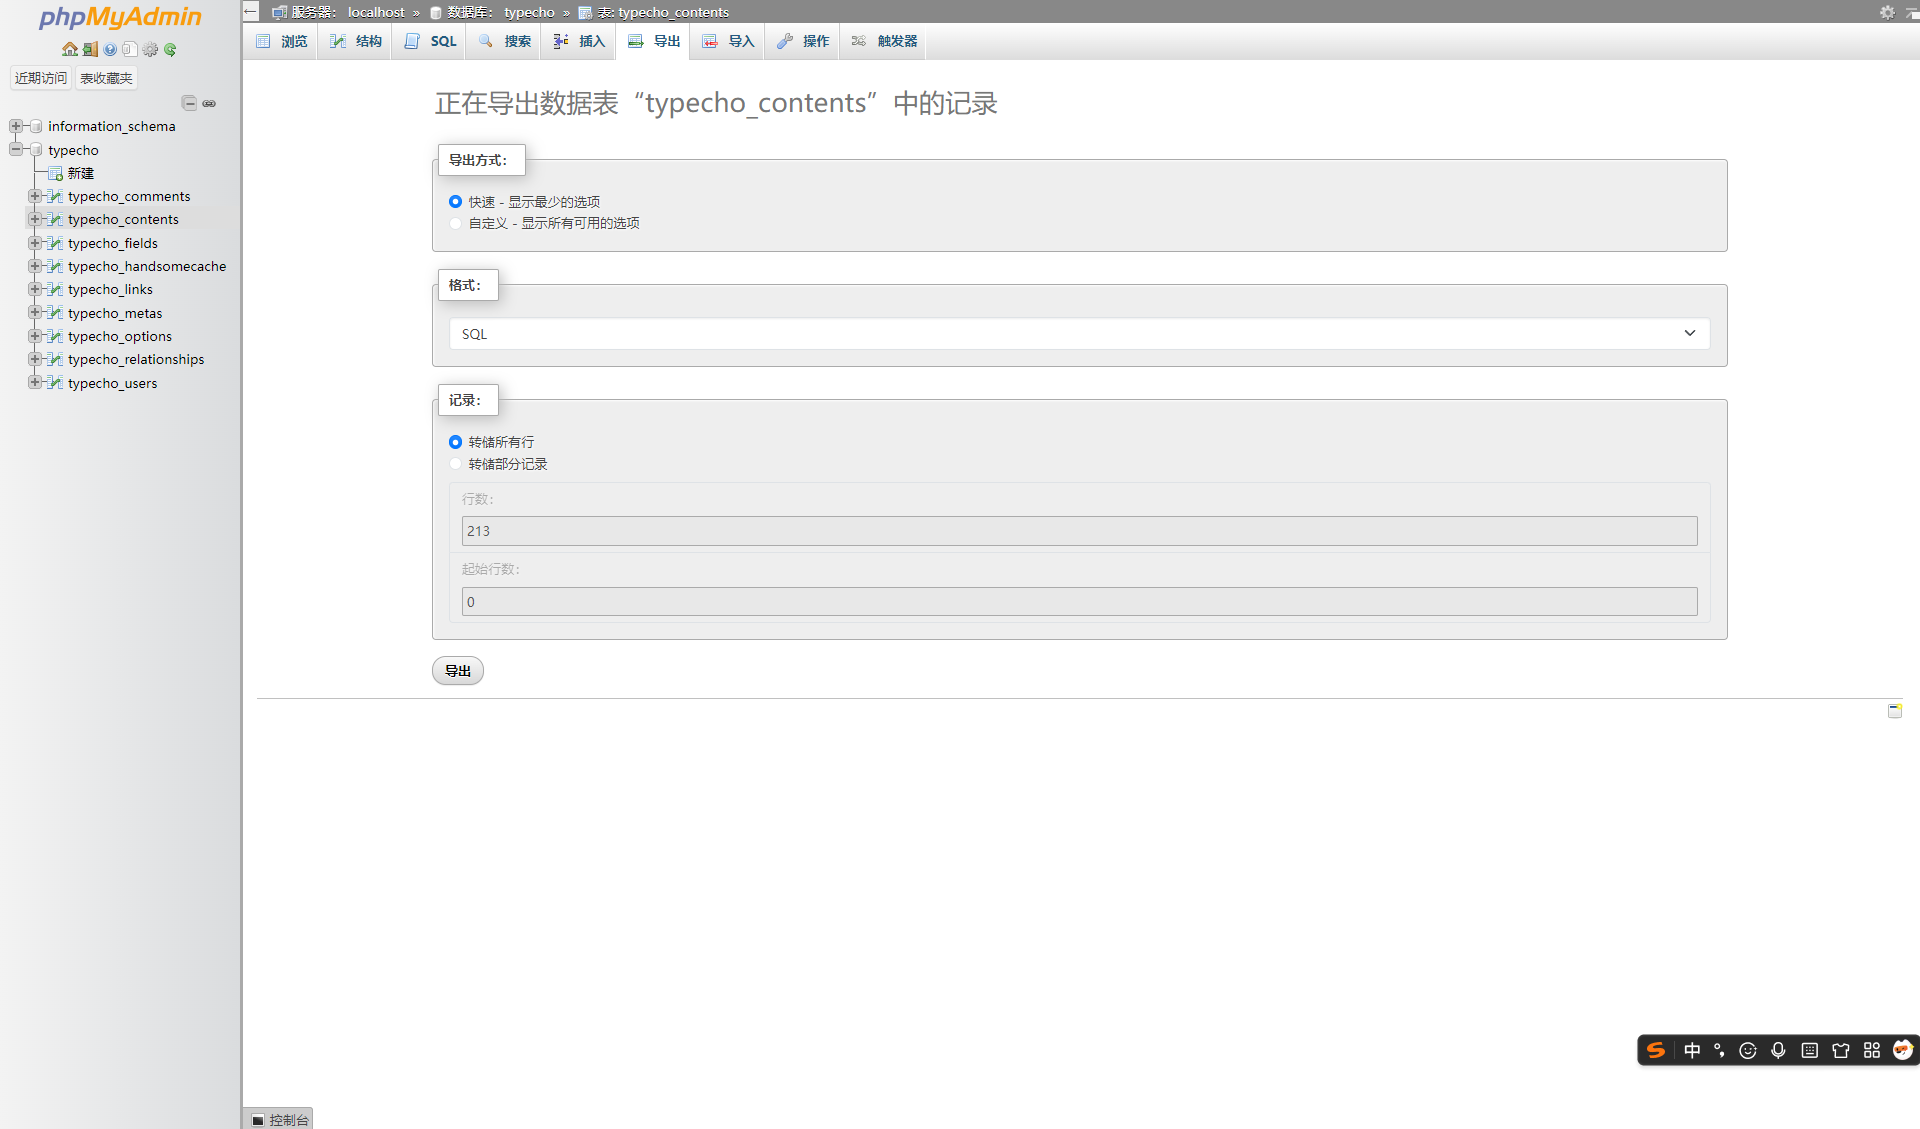
如图是使用 phpmyadmin 来导出 typecho_contents 中的记录

导出后,你会得到一个 SQL 文件

你成功了

删除你的 SQL 文件没用的东西

首先,手动打开你的 SQL 文件,找到这个并把下面这部分的内容给复制出来

--
-- 转存表中的数据 `typecho_contents`
--
INSERT INTO `typecho_contents` (`cid`, `title`, `slug`, `created`, `modified`, `text`, `order`, `authorId`, `template`, `type`, `status`, `password`, `commentsNum`, `allowComment`, `allowPing`, `allowFeed`, `parent`, `views`, `stars`) VALUES

复制这里的东西

--
-- 转储表的索引
--

单独把他保存到一个 txt 文件中

然后打开 ./assets/0_clear_nottidy.py,介绍一下,清理 png jpg pdf jpeg 在第二字段所包含的行,其他保留

你需要手动填写两个内容:

  • input_file_path 设置为你的 txt 文件路径,注意一定要有 R,是用来转义的,要用双引号包裹路径
  • output_file_path 设置为你的导出后 txt 文件路径,就是处理后的文件路径,同上

然后使用 python 直接运行,即可完成操作

恭喜你,删除完成,你可以手动浏览一下

从 SQL 文件中分类保存文章至文件夹

打开 ./assets/1_download_md.py,还是简单介绍一下,读取文章名称和时间戳和文章内容,在你所指定的目录下,新建 YYYYMMDD - title 的文件夹,即时间戳对应的年月日加上对应的文章名称,然后在文件夹里面新建 title.md 作为文章的主内容

你需要手动填写:

  • INPUT_FILE:上一次导出的 txt 文件路径,同上

然后还是使用 python 直接运行,即可完成操作

警告:导出后的文件将被保存在 C:/Users/<USER_NAME>/ 下

你可以手动观察一下,你会发现导出的 md 特别变态,所以接下来,我们就要处理换行符的问题 + 图片资源

保存图像附件和处理换行

打开 ./assets/2_make_image_rn_to_n.py,还是简单介绍一下,从 md 里面读取 ![]() 的格式,将 () 下载保存到当前文件夹的 assets 目录里头,然后将 \\r\\n 替换为 \n(不理解这句话内容的自行上网搜索)

你需要手动填写:

  • TARGET_DIR:设置上一次导出文章目录的目录(?)
  • download_url:但是你只需要修改我的 http://www.tropical-fish.cn 部分,修改为你的下载域名,不要加斜杠!!!

然后,你懂的

然后,你就会发现,换行好了,图片资源也被正确保存在了对应的 assets 目录下

你好牛逼啊!!!

处理开头的小插曲

打开 ./assets/3_kill_markdown.py,还是简单减少一下,删除 <!--markdown--> ,没了

你需要手动填写:

  • TARGET_DIR:你上一次导出文章的的目录的目录(?)

然后,你懂的

然后,你完成了

处理完成

资源下载

20260211 - 将 typecho 的博客文章下载至本地 - assets.zip - huang1111网盘

推荐一个 Markdown 编辑器 —— $\text{MarkText}$

Marktext - 一个很牛逼的 Markdown 编辑器!

[题外话] Typora 的落幕

Typora,是一个很牛逼的 Markdown 编辑器,但是,它要钱...
需要 $89$ 元的人民币,虽然是 永久 的授权,但对于学生党来说还是一个不低的价格。
尤其是小学生、初中生、高中生、大学生...(生活费问题)。

转折

但是 Markdown 是一个应用很广泛的标记语言(例如 OI),所以必定有一些替代品。
在这一堆可选的替代品中,首选的就是 Marktext,很适合从 Typora 过渡,使用根本差不多。

那么,现在就开始搞...

正文

简介

Github 官网:marktext/marktext: 📝A simple and elegant markdown editor, available for Linux, macOS and Windows.。
当然,你可能进不去,因为 Github 服务器位于海外,所以你需要 Using the internet securely 或者 Using Watt Tookit 的合法加速器。

🔆 下一代 Markdown 编辑器 🌙
一款简单优雅的开源 markdown 编辑器,注重速度和可用性。
适用于 Linux、macOS 和 Windows。

更多内容请查看该项目的 readme.md 文件

警告

我们是中文用户,我们将会使用非官方汉化的版本。
即 topabomb/marktext-specialedition: marktext0.17.1分叉的中文特别版

下载 & 解压程序

首先,进入到该软件的 Github 仓库页面(如上节)。

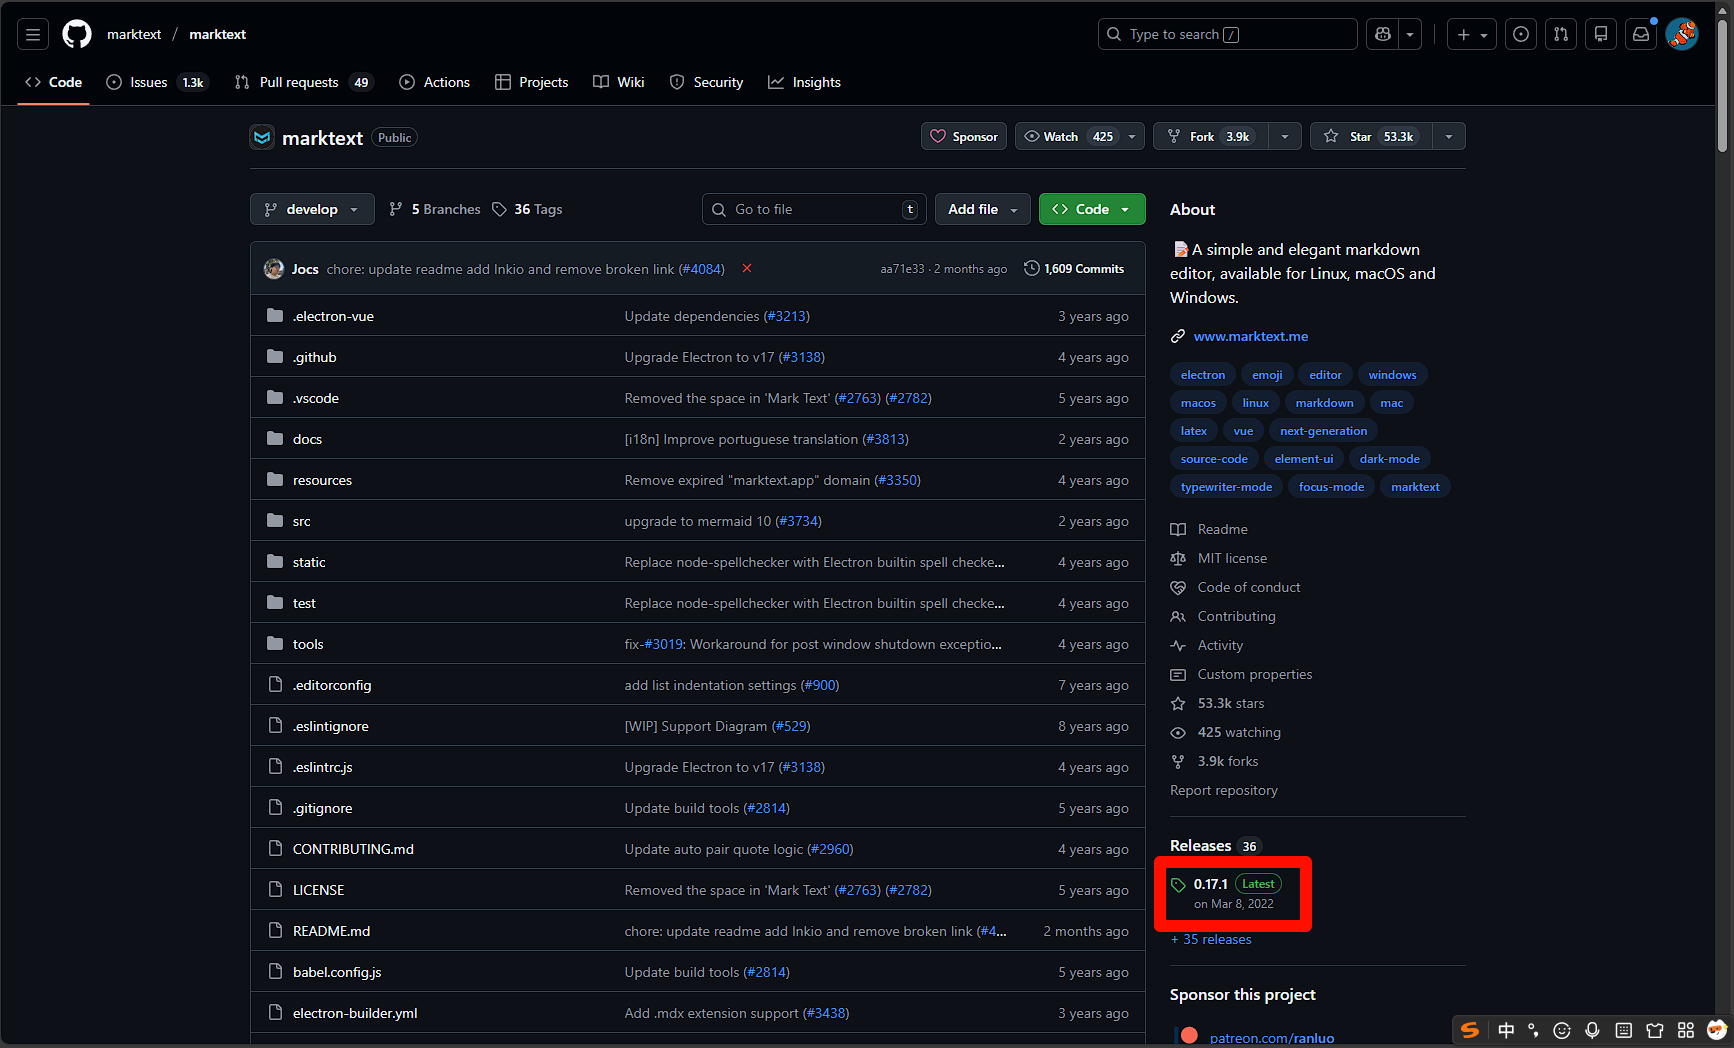
单击 Release 进入到该项目的软件发行页面,如 图1,版本号不一定为如图的版本.

图1

随后,找到 Assets 部分。

选择你需要的版本下载,例如 marktext-1.0beta-win64.zip,单击即可下载。

或者,你也可以直接单击 这个链接 进行下载。

注意,下载的文件格式为 zip。

然后,使用 Windows 自带的解压缩工具进行解压,或者使用你想要的解压工具解压,将其剪切到你的软件安装目录中,例如 C:\Program Files\Marktext。

首次运行程序

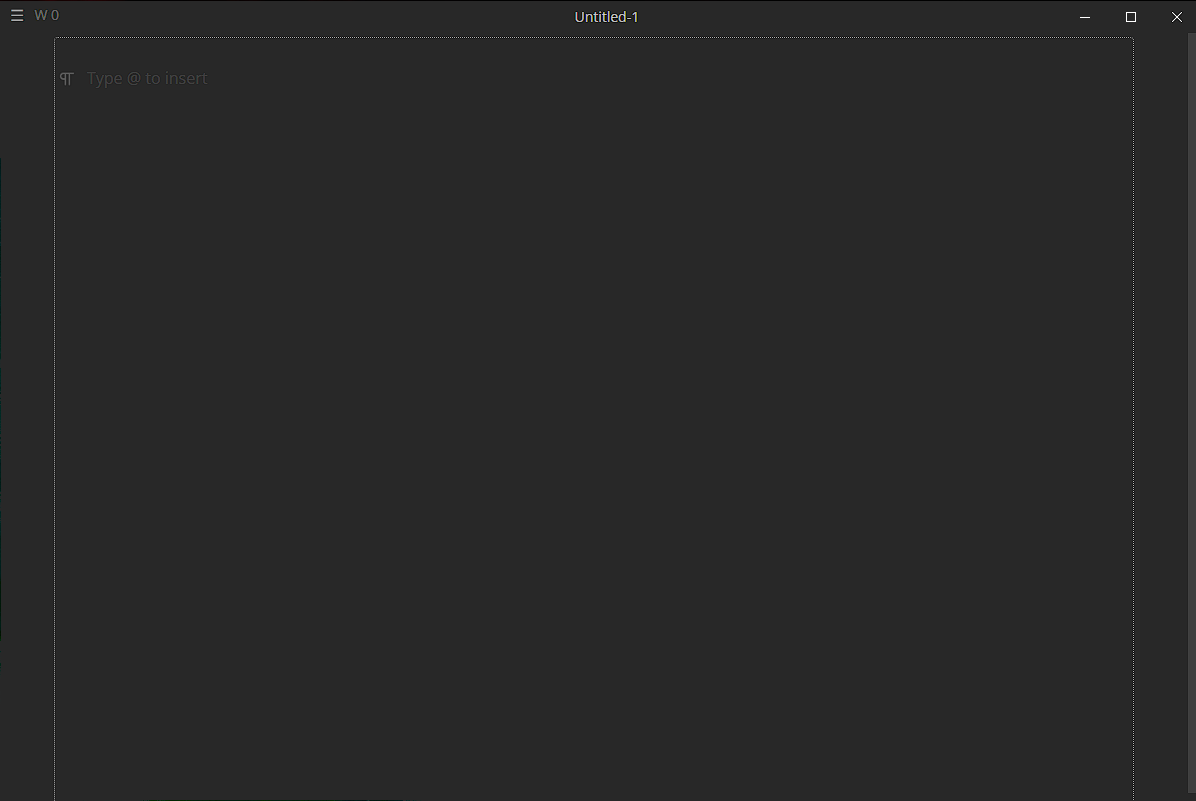
解压后,直接双击 MarkText.exe 即可打开主程序,界面如 图2。

图2

在这里,就可以直接键入 Markdown 字符了,所见即所得。

温馨提示:似乎只有这个界面有英文。

它会自动设置与你系统主题相同的主题。

与 Typora 不一样的地方

你需要按下 Ctrl 与 E 建才能开启源代码模式。

你不能在源代码模式下撤销更改。

默认开启 MathJax,即 Latex(Katex)。

你不能将 md 导出为 docx。

其他资源

如果你仍需要 Typora 破解版,这是一份可用的破解版:typora。

Thanks for reading.

众所周知

在某个奇怪的版本更新后,openlist(alist)不再支持设置用户为管理员,但是,不代表我们不能设置管理员

正文

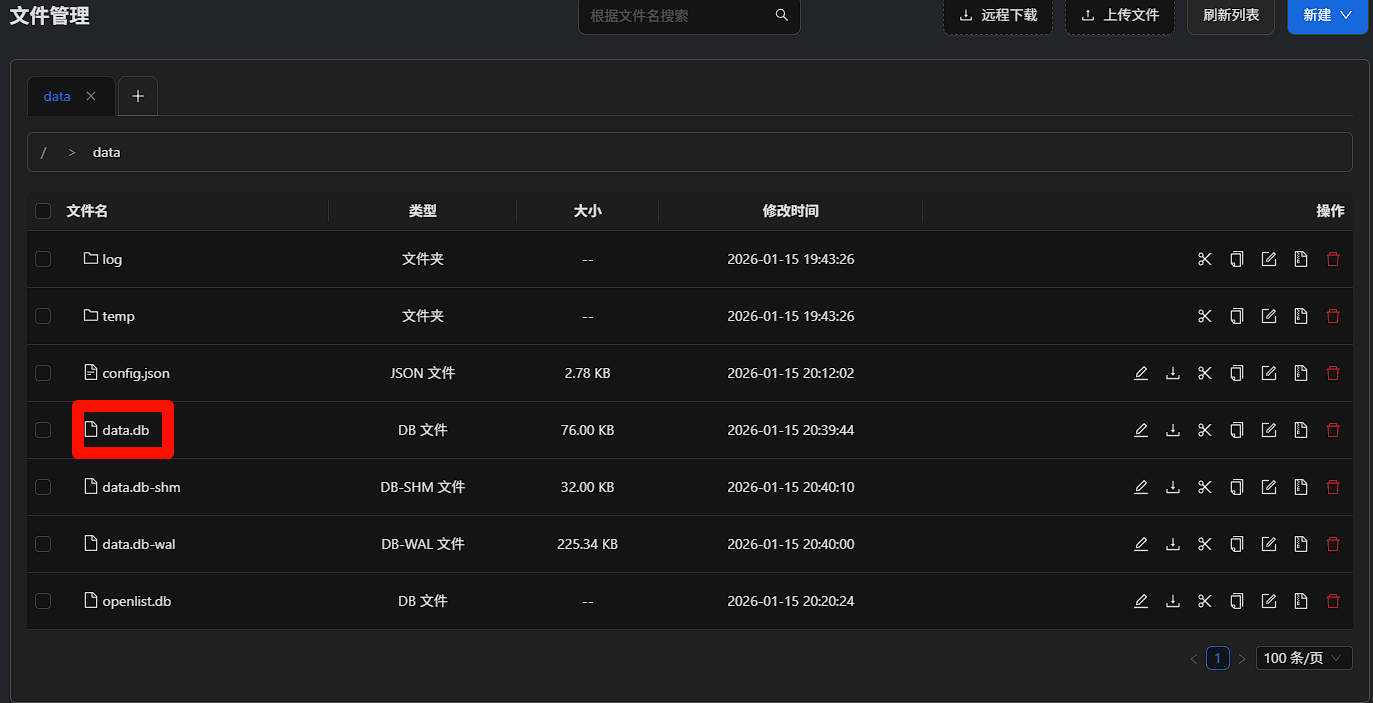
偶然之间,我翻 openlist 文件的时候,发现了一个文件
image.png
那么,我们是不是可以通过这个数据库来修改一个用户为管理员捏?

开始操作

警告:Windows 需要先安装 Python,Linux 需要使用 apt install python3 && apt install pip 来安装 Python

进入终端

然后 cd 到 data 文件夹的位置(如果 Windows 不在当前盘符需要先键入盘符,前面不需要加任何内容,进入这个盘符,才能 cd 进入这个盘符的目录)

然后进入 python ,使用 python 或 python3

然后,依次键入以下命令

import sqlite3
conn = sqlite3.connect('data.db')
cur = conn.cursor()

恭喜你,已经成功连接数据库

然后,开始设置管理员

cur.execute("UPDATE x\_users SET role = 2 WHERE username = 'DHEnry';")
conn.commit()

将 DHEnry 设置为需要设置管理员的用户名(不是用户 ID)

然后,你就修改成功了

别执行头图的命令

引

[scode type="yellow"]

更好的阅读体验

[/scode]

[collapse title="扯淡内容 点我展开" status="false"]
使用 rm 可以快速清理

[/collapse]

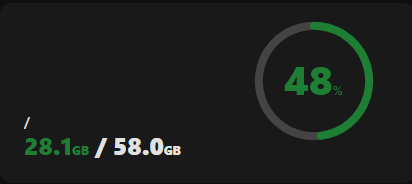
相信大家在用久服务器后肯定会发现自己的服务器系统盘非常容易膨胀

image.png

虽然你可能只是有恐惧症罢了

这该如何解决?

[collapse title="一种非常好用的解决方案" status="true"]花钱扩容硬盘,但是你既然都看到了这篇文章你应该不会使用这个方法吧[/collapse]

如果你要阅读这篇文章,你需要掌握的

  • 正确连接到 ssh 服务器,在客户端使用 ssh root@<server_ip>
  • 正确使用 cd <d> 来进入一个文件夹
  • 正确使用 ls 列出服务器文件
  • 正确使用 rm [] <d/f> 删除文件及重要参数例如 r 和 f

实践

Warn & Info

一般的 web 服务器,有 nginx、php、mysql、docker、pma,我们清理 Linux 系统就从这些方面入手,假设你使用的是 Ubuntu 22.04 ,其他系统不一定能用,但是应该是通用的,只不过包含 apt 的命令是执行不了的

[scode type="red"]一定要先备份文件!!!避免重要文件被误删!!![/scode]

笼统的办法

这个办法非常通用,但是清理的效果不一定明显

日志文件

网站日志

日志文件应该没有什么人没看到他,这里一般包含 nginx 的访问日志,包括站点的访问日志,如果你的操作系统中,安装了宝塔,日志文件一般在 /www/wwwlogs 这个文件中,所以我们可以使用以下命令删除

cd /www # 进入 /www 目录
rm -rf /www/wwwlogs # 强制递归删除 /www/wwwlogs
mkdir wwwlogs # 再建立 wwwlogs 文件夹

系统日志

然后再入手系统日志,就是包括维护信息啥的,他在 /var/log ,同样删除

cd /var # 同上
rm -rf /var/log
mkdir log

systemctl 日志

然后删除 systemctl 的日志,但是这里使用 journalctl ,使用以下命令删除

journalctl --vacuum-time=7d # 清理 7 天前的 systemctl 日志

apt-get 日志

然后再清理 apt-get 的日志

[collapse title="apt 与 apt-get 的区别" status="false"]
交互式用户推荐使用 apt

脚本或自动化使用 apt-get

[/collapse]

可使用以下命令删除

apt-get clean -y # -y 用于强制确认

缓存

Windows 中缓存位置位于 %temp% ,但是 linux 中是 /tmp/ 所以直接删除即可

rm -rf /tmp/* # 强制递归删除 /tmp/ 目录下的所有文件(夹)

不需要的软件包

使用 apt-get 清理不需要的软件包,也是可以的,但是有风险,这一般会删掉没有依赖或者废弃的软件包

apt-get autoremove --purge -y # -y 强制确认

更适用于自己的办法

这种方法就比较零散了,一般是人工/机械地产生大文件,需要你进行手动查找和删除,一般没什么作用

手动定位大文件

定位根目录下的大文件

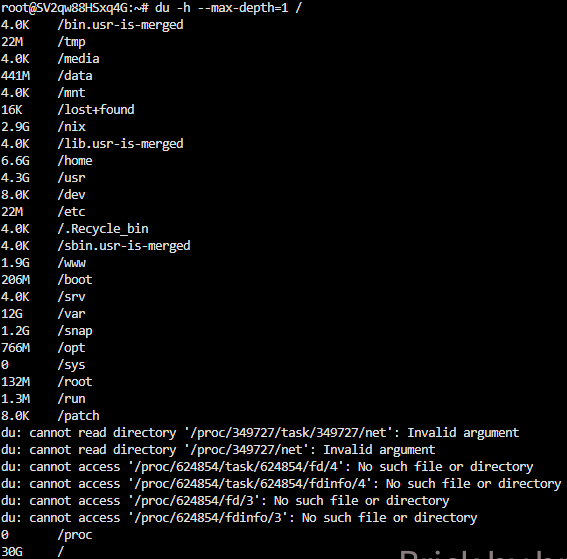
合理使用 df 定位大文件

du -h --max-depth=1 / # 最大文件深度为 1 ,查找根目录下的,推荐设置为 1 ,然后再进一步查找

image.png
我这边查找到了根目录的每一个文件夹的大小
我这边发现 /home 目录似乎占用了过多的硬盘空间,为了演示,在 /home 目录里面查找大文件

定位二级目录的大文件

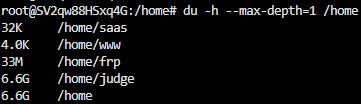
使用 cd 进入你怀疑有大文件的目录

然后再使用 df 查找,但是查找的目录要改成 rt

du -h --max-depth=1 /home # / 改成了 /home,即查找的目录

image.png
又列出了一些文件,再进入查找

定位三级目录的大文件

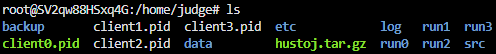
再次使用 cd

定位到三级的时候,一般需要使用 ls 查看了
image.png
这时候就要考研我们的 English 能力了,你但凡有小学六年级英语基础,你就应该发现 backup 是备份文件夹,里面肯定有一堆没用的文件

进入后,删掉没用的即可

rm -rf <d> # <d> 填文件夹的绝对路径,千万别填相对路径!!!可能会发生玄学事件

[collapse title="绝对路径是什么" status="false"]
例如,你在文件夹 /home/judge 下,该文件夹下有一个文件夹叫做 ry ,那么:

/home/judge/ry 是这个文件夹的绝对路径

/ry 是这个文件夹的相对路径

说人话,相对于当前文件夹的文件夹的路径叫做相对路径,相对于根目录的文件夹的路径叫做绝对路径 这不是长难句

[/collapse]

如果你还想定位,那你继续定位

查找指定特点的大文件

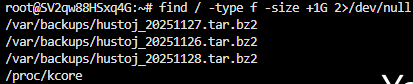
合理使用 find 命令

find / -type f -size +1G 2>/dev/null

/ 根目录
-type f 查找选项为 file 文件并非文件夹
-size +1G 查找大于 1G 的文件
2>/dev/null 把权限错误的文件的输出放到 /dev/null

image.png

查找到手动删除即可

感谢阅读

请前往 Linux 不小心挂载错磁盘导致无法启动系统咋办 - TropicalFish - 信息技术分享平台 以获得更好的阅读体验

阐述标题

你给你的服务器加了一块硬盘,你编辑 /etc/fstab 设置自动挂载,但是手滑打错了一个字符

这边假设你不是通过指定 uuid 而是设置 dev 设备路径

image.png

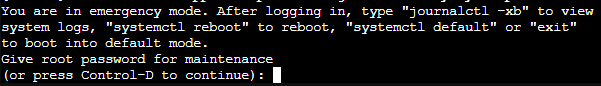
一不小心重启系统就 如图 了,也进不来系统
What should we do

正文

这种情况其实非常 easy (?)

先登录到维护模式

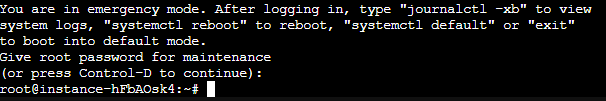
在此处直接键入服务器密码即可

image.png

此时你应该成功登录到终端

修改 /etc/fstab

按照往常那样,使用 vim 修改文件
vim /etc/fstab

建议取消除系统外其他挂载,等到进系统在重新编辑

先按 i 进入编辑模式,再按 insert 进入插入模式

LABEL=cloudimg-rootfs   /        ext4   discard,errors=remount-ro       0 1
LABEL=UEFI      /boot/efi       vfat    umask=0077      0 1
/dev/sdc1 /home ext4 defaults 0 1
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
~
"/etc/fstab" 3L, 135B                                         3,33          All

例如,此代码片段中,第一二行就是系统的挂载,第三行就是用户手动进行的挂载,我们应当注释你手动删除的行,或者直接删除也可

然后 :wq! 保存退出

重启系统

[scode type="red"]这时你使用云服的重启系统可能没有什么效果,你需要手动重启[/scode]

在终端使用下面这个命令重启系统

sudo shutdown -h now

然后,在云服控制面板点击【关机】

再点击【开机】

应该就可进入系统了


感谢阅读

阐述标题

刚打开这个文章的你,可能会对这个 title 有点懵逼,简单介绍一下:

当你访问一个地址的时候,这个站点会随机从服务器向你返回一张图片

你应该懂了吧

正文

按照标题,我们需要先购买一台服务器

购买服务器

这里推荐使用雨云进行搭建
有备案选国内,没备案选国外
1 核心 1G 也能运行起来!即使配置不够,后续也可升级
自行选择心仪的服务器
操作系统推荐选择 ubuntu 22.04

安装宝塔面板

如果在本章节出现不知道如何操作的,可以前往[教你快速搭建一个文件快递柜[filecodebox使用教程] - TropicalFish - 信息技术分享平台](https://www.tropical-fish.cn/index.php/archives/129.html)查看

宝塔面板(bt.cn) 简单好用的Linux/Windows服务器运维管理面板

购买服务器后,使用 SSH 工具连接到服务器,键入 bt.cn 上最新的安装宝塔面板的命令

为了防止你是迷惑用户,直接贴上URL:宝塔面板下载,免费全能的服务器运维软件

if [ -f /usr/bin/curl ];then curl -sSO https://download.bt.cn/install/install_panel.sh;else wget -O install_panel.sh https://download.bt.cn/install/install_panel.sh;fi;bash install_panel.sh ed8484bec

第一次需要按 Y 以确认安装
等待出现面板链接信息即代表安装成功

首次进入宝塔面板

如果在本章节出现不知道如何操作的,可以前往[教你快速搭建一个文件快递柜[filecodebox使用教程] - TropicalFish - 信息技术分享平台](https://www.tropical-fish.cn/index.php/archives/129.html)查看

根据 ssh 窗口中提供的连接信息,在浏览器中访问,请注意 https 与 http 的区别

第一次访问需要同意许可条款

可以不选择绑定账号

需要安装 LNMP 环境,如果不小心手滑点掉了,也可以通过重新进入面板来安装

安装进度可见左上角面板 ip 旁边的小数字

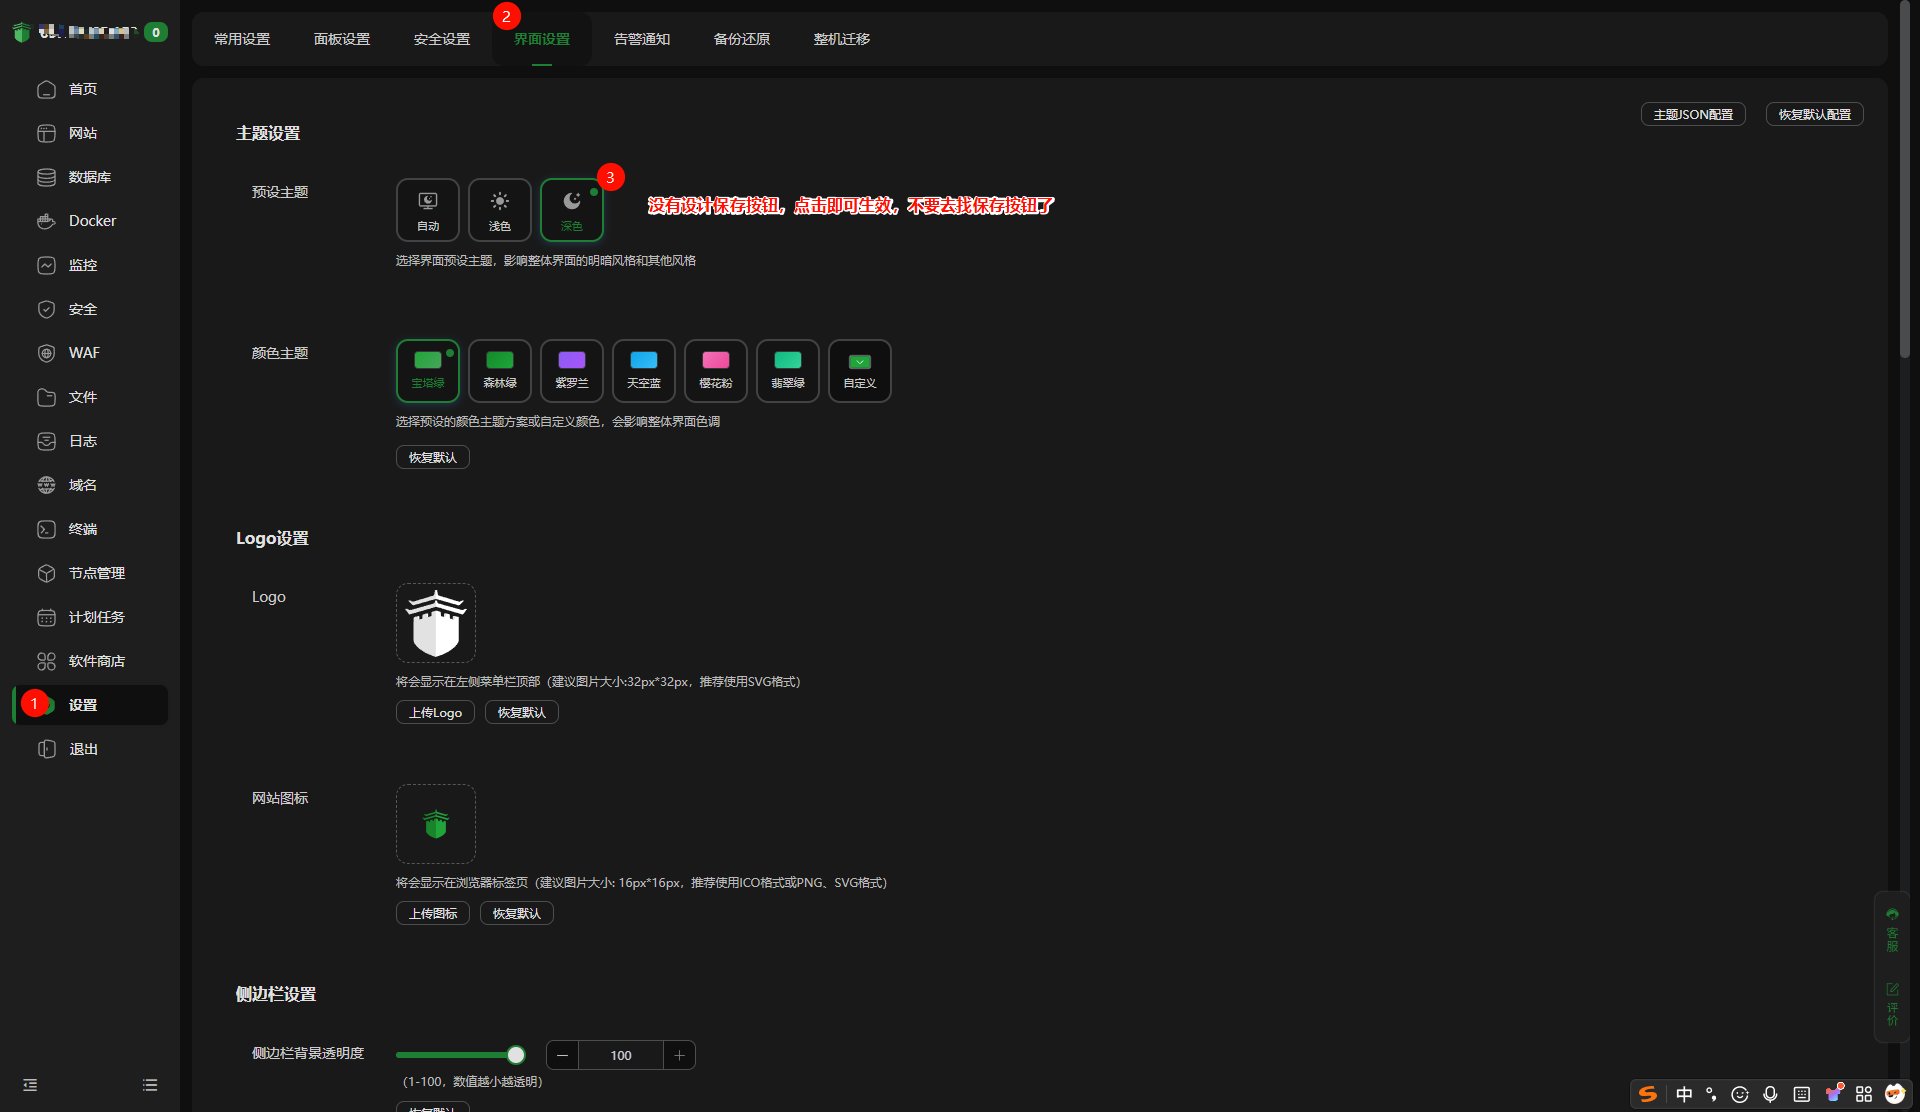
如果你是重度深色用户,可通过以下方式将 bt 设置为深色模式
image.png

创建、编写网站

创建网站

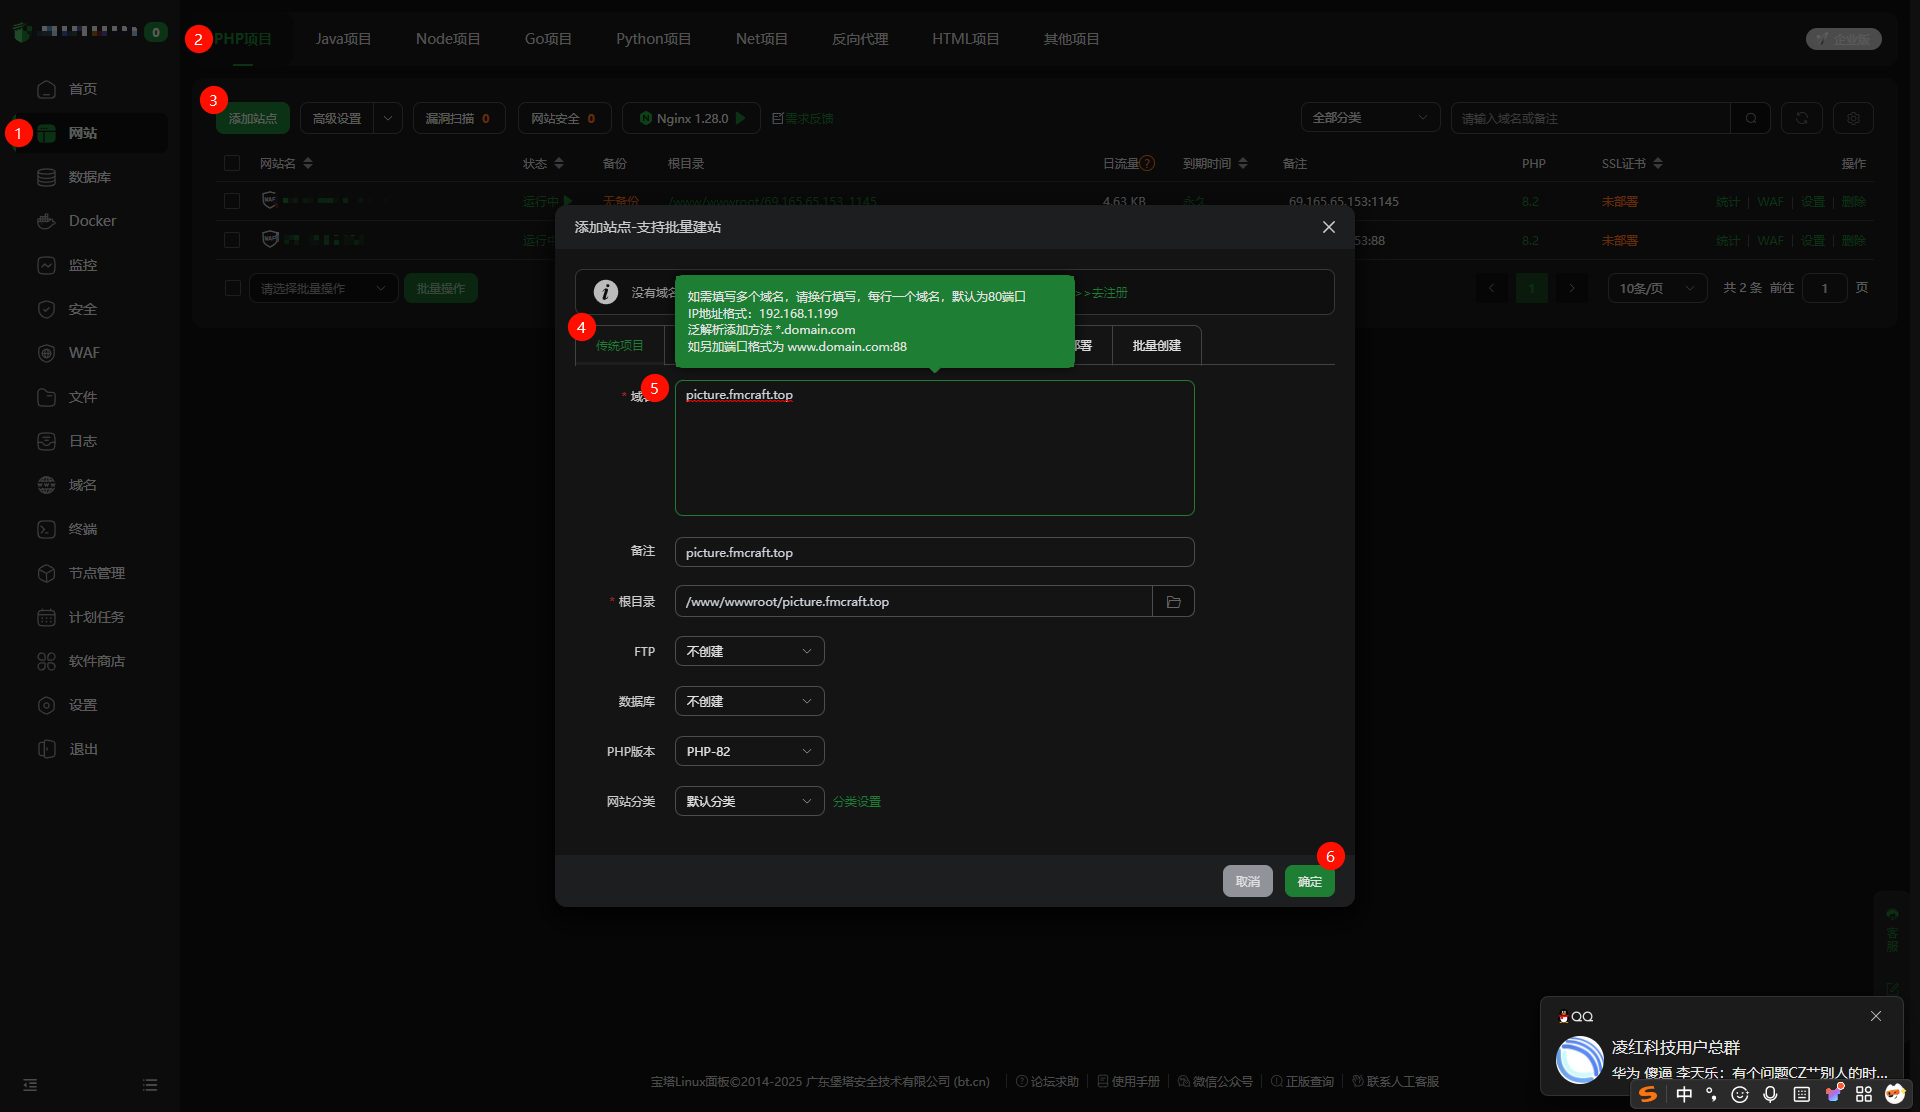
点击宝塔左侧网站,PHP 项目,添加站点
域名就写 {server_ip}:{port},即服务器 ip + 自定义端口,当然如果你有域名也可以填写你的域名,但是需要在域名提供商创建一个 A 解析指向服务器 ip
根目录可以不管
确定即可
image.png

编写网站

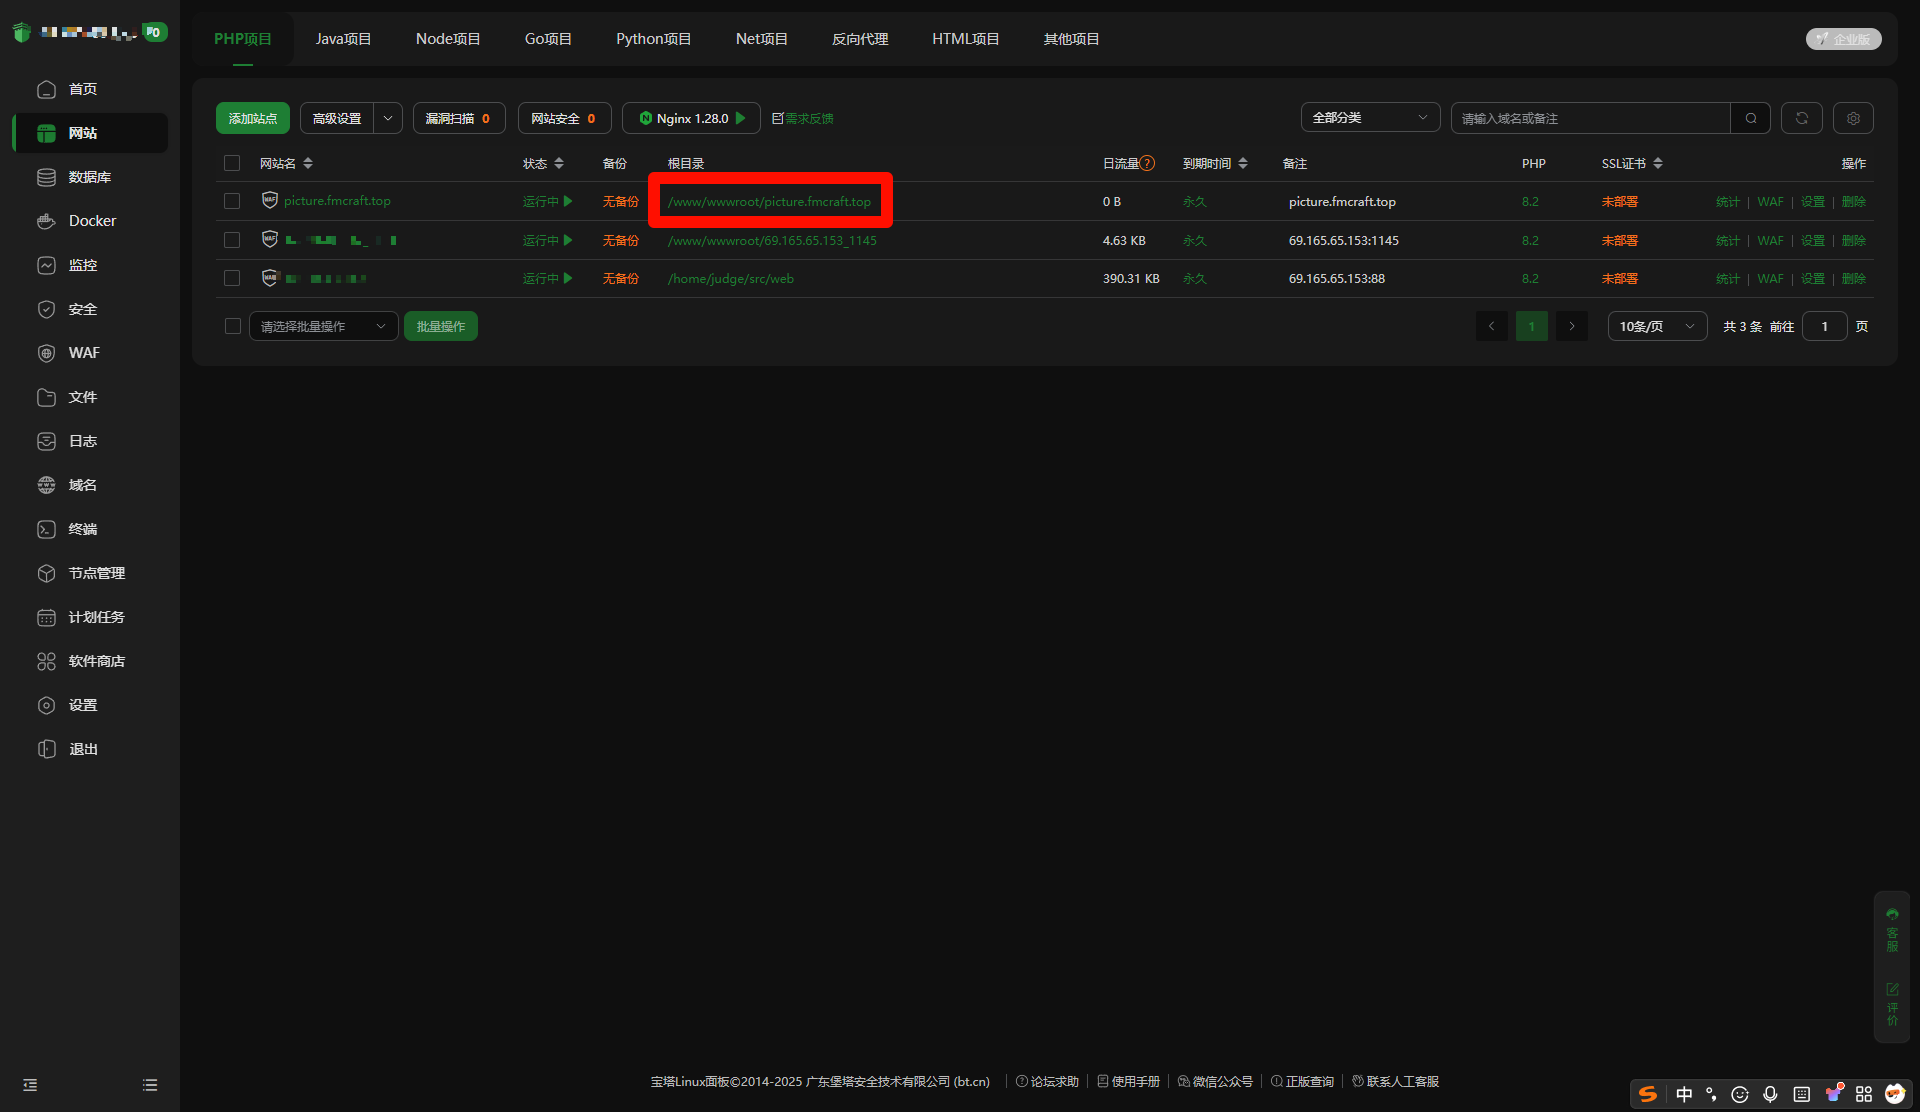
点击你刚创建网站的 根目录 进入文件管理
image.png

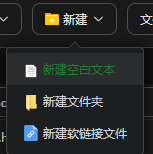
然后创建一个文本文件
image.png

将其命名为 index.php

没有设计确定按钮,直接回车即可,不要再找确定按钮了

双击编辑他

键入以下代码

<?php
$img_array = glob("photos/*.{gif,jpg,png}",GLOB_BRACE); 
$img = array_rand($img_array); 
$dz = $img_array[$img];
header("Location:".$dz);
?>

如果你想知道代码的含义,可以看看:

<?php
// 使用 glob 函数搜索 photos 目录下的所有 gif、jpg、png 格式的图片文件
// GLOB_BRACE 参数允许使用花括号来匹配多种文件扩展名
$img_array = glob("photos/*.{gif,jpg,png}", GLOB_BRACE); 

// 从图片数组中随机选择一个图片的索引键
// array_rand 函数返回随机数组元素的键名
$img = array_rand($img_array); 

// 通过随机选择的键名获取对应的图片文件路径
// $img_array[$img] 就是随机选中的图片文件完整路径
$dz = $img_array[$img];

// 发送 HTTP 重定向头部,将用户浏览器跳转到随机选中的图片地址
// 这样用户就会直接看到随机选择的图片
header("Location:".$dz);
?>

然后 Ctrl+S 保存

上传图片文件

新建一个文件夹,命名为 photo,进入此文件夹,将你想要的图片上传,扩展名一定要是 gif jpg png 三者其中之一

你想的没错,直接把本地文件直接拖到文件管理器即可

如果文件数量过多,可本地压缩成 zip 文件后,上传到文件管理器,再解压即可

测试

打开浏览器,键入你之前输入的域名或 ip+port ,你会发现他成功加载了图片

如果你是迷惑用户,你可能会怀疑为什么我刷新,还是那张图片,我建议你看看你访问的 url 是什么
如果你是迷惑用户,你可能会想着该怎么办,再次强调,随机图片 API,你是通过 api 访问的,加载一次客户站点,只会加载一次图片 api 站点,不会加载很多次
如果你是迷惑用户,你可能会想如果我在一个页面中引用多次 iframe 怎么办,再次强调,你是通过 api 访问的,访问一次,获取一次
如果你是迷惑用户,建议询问 Deepseek

恭喜你,打败了全国 99% 的选手

引流

【科技补全76】火绒曝光超级流氓软件鲁大师、小鸟壁纸;英特尔前员工盗窃上万份机密文件;谷歌被FFmpeg开发者怒喷;安卓将不再禁止高级用户随意装软件;\_哔哩哔哩\_bilibili
这不是广告

新概念英语点读工具

Github 开源

luzhenhua/NCE-Flow: 新概念英语在线点读,点句即读、连续播放,支持 EN / EN+CN / CN。

介绍

新概念英语在线点读,点句即读、连续播放

优势何在?

  • ​句子级点读​:点击任意句子开始播放,自动高亮跟随
  • ​多语言视图​:EN / EN+CN / CN 三种显示模式
  • ​播放控制​:倍速调节、连读/点读切换、循环模式、断点续播
  • ​全局快捷键​:空格播放/暂停、方向键导航、音量控制
  • ​学习管理​:课程收藏、学习记录、进度追踪
  • ​现代界面​:Apple 风格、深浅色主题、响应式设计
  • ​零依赖​:纯静态文件,解压即用

部署方法

我们如何部署如此有用的项目呢?我们可以使用同样有用的雨云和宝塔面板,并且在宝塔里安装 Docker

先购买一台服务器,1 核心 1G 也能跑起来这个项目,然后安装宝塔面板

方法1:Docker 部署

适合不用二开的

docker run -d -p {PORT}:80 --name nce-flow --restart unless-stopped luzhenhua/nce-flow:latest

{PORT} 处填外网访问端口

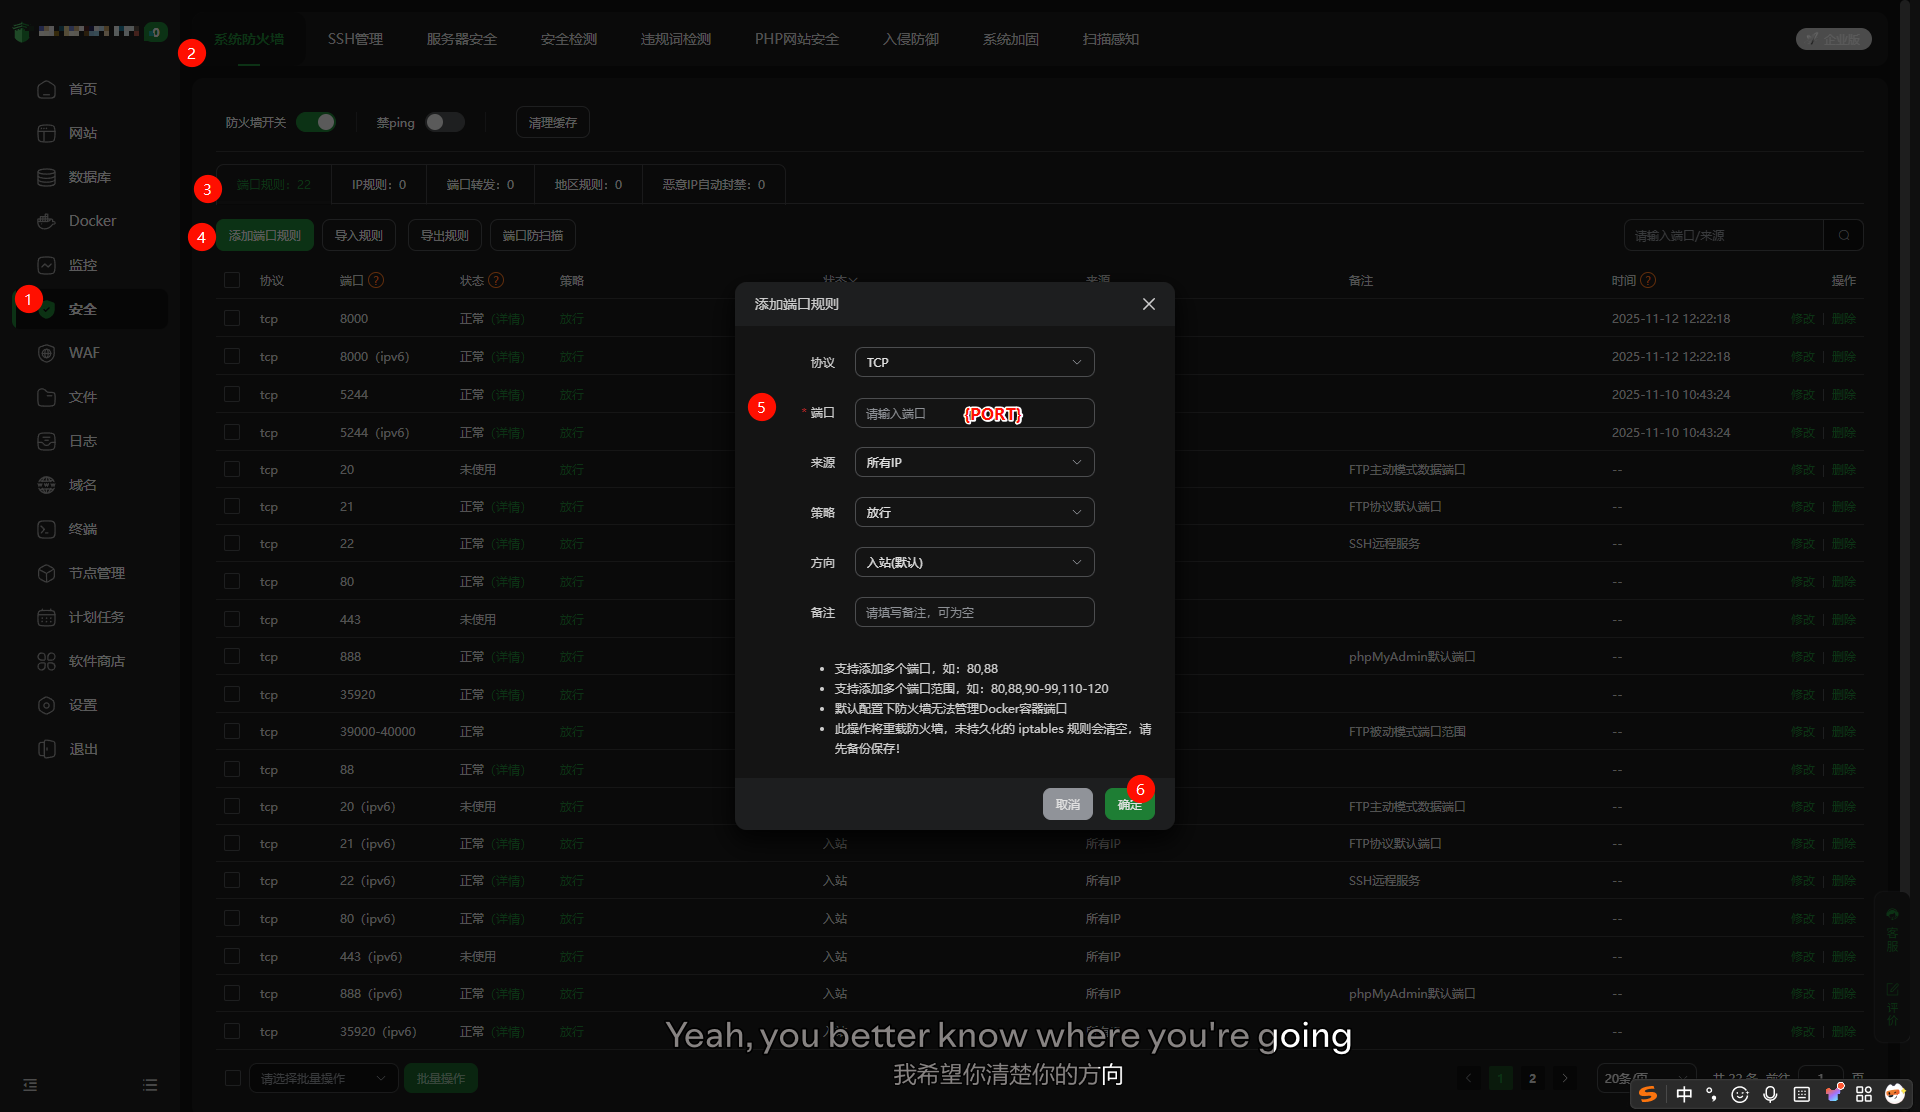
在你的 ssh 终端中键入命令,然后放行防火墙,通过浏览器访问 http://<server_ip>:<port> 即可

如何放行防火墙?
image.png

方法2:Docker-Compose 部署

适合有一定技术基础的,有自定义配置需求的

git clone https://github.com/luzhenhua/NCE-Flow.git # 使用 git 拉取项目
cd NCE-Flow # 进入项目目录
docker-compose up -d # 根据 docker-compose.yml 启动文件,如果不能使用这条命令请使用 docker compose up -d

在 ssh 终端运行即可,依旧需要放行防火墙,端口默认 8000

方法3:Python 部署

你需要先使用 apt update && apt install python3 && apt install pip 安装环境

将项目的 Release 中的 .tar.gz 下载至服务器

可以在自己的电脑中,找到 Release 中的 .tar.gz ,右键,复制链接,然后在服务器中,使用下述命令拉取
{URL} 就是复制的 URL

wget {URL}

警告:文件约为 583MB

使用下述命令解压

tar -zxvf filename.tar.gz

使用 cd 命令进入目录
使用 python3 -m http.server 8000 运行项目
依旧需要放行防火墙

更多方法请在 Github 探索

如何使用

浏览器访问 http://server_ip:port

选择你想要的一册,然后选择一课,点击播放按钮即可

在线文件管理器

Github 开源

9001/copyparty: Portable file server with accelerated resumable uploads, dedup, WebDAV, FTP, TFTP, zeroconf, media indexer, thumbnails++ all in one file, no deps
温馨提示,如果你要访问这个页面,你需要一台性能强劲的电脑

介绍

将几乎任何设备变成文件服务器,使用任何网络浏览器可以恢复上传/下载

  • 服务器只需要 Python(2 或 3),所有依赖项可选

部署方法

在你的电脑打开这个项目的 Release,右键最新的蓝色 copyparty-sfx.py

然后再 ssh 终端,使用 wget {URL} 下载这个 .py 文件

嗯嗯,非常 nice ,最后一步... 原神,启动!使用 python3 copyparty-sfx.py 运行这个 .py 文件

然后放行 3923 端口

浏览器访问 http://<server_ip>:3923 即可

如何使用

已经写的非常明显了
点击就是访问
虽然你可能看不懂英文
多用用就会了

前言

提到在线评测系统(Online Judge),很多人会想到用C++、Java 或 Python 等语言开发。但你可能不知道,​PHP 同样能够构建功能强大的在线评测系统​!今天我们就来聊聊基于 PHP 的 HUSTOJ ——一个成熟稳定的开源在线评测系统

HUSTOJ

hustoj 由 华中科技大学(实际上只有 zhblue 一个人和喜欢 pr 的网友) 开发,前后端完全使用 php 开发,判题机是 docker ,不用担心安全问题,这点为 oi 教学系统提供了很好的解决方案

主要优势:

  • 开源免费
  • 允许商用(只需要开放源代码)
  • 海量题库(约 $x(x \geq 5 \times 10^3)$ 道题目可以下载)
  • 支持多种语言提交
  • 社区活跃
  • 易于二开(直接修改文件即可,不需要重新 build)

HUSTOJ 相关资料

QQ 群:23361372
wiki:代码的那些事 | 程序员回忆录
github:zhblue/hustoj: Popular Simple Open Source Online Judge based on PHP/C++/MySQL/Linux for ACM/ICPC and NOIP training, with easy installation. 简单实用的开源OJ系统
题库:TK题库

正文

我们如何部署如此强势的 online judge 呢?
我们可以使用同样强势的的 雨云 和 宝塔面板
温馨提示:1-1 也可以部署 hustoj
购买完服务器后,需要安装宝塔面板
操作系统选择 ubuntu 22.04

开始部署

创建数据库

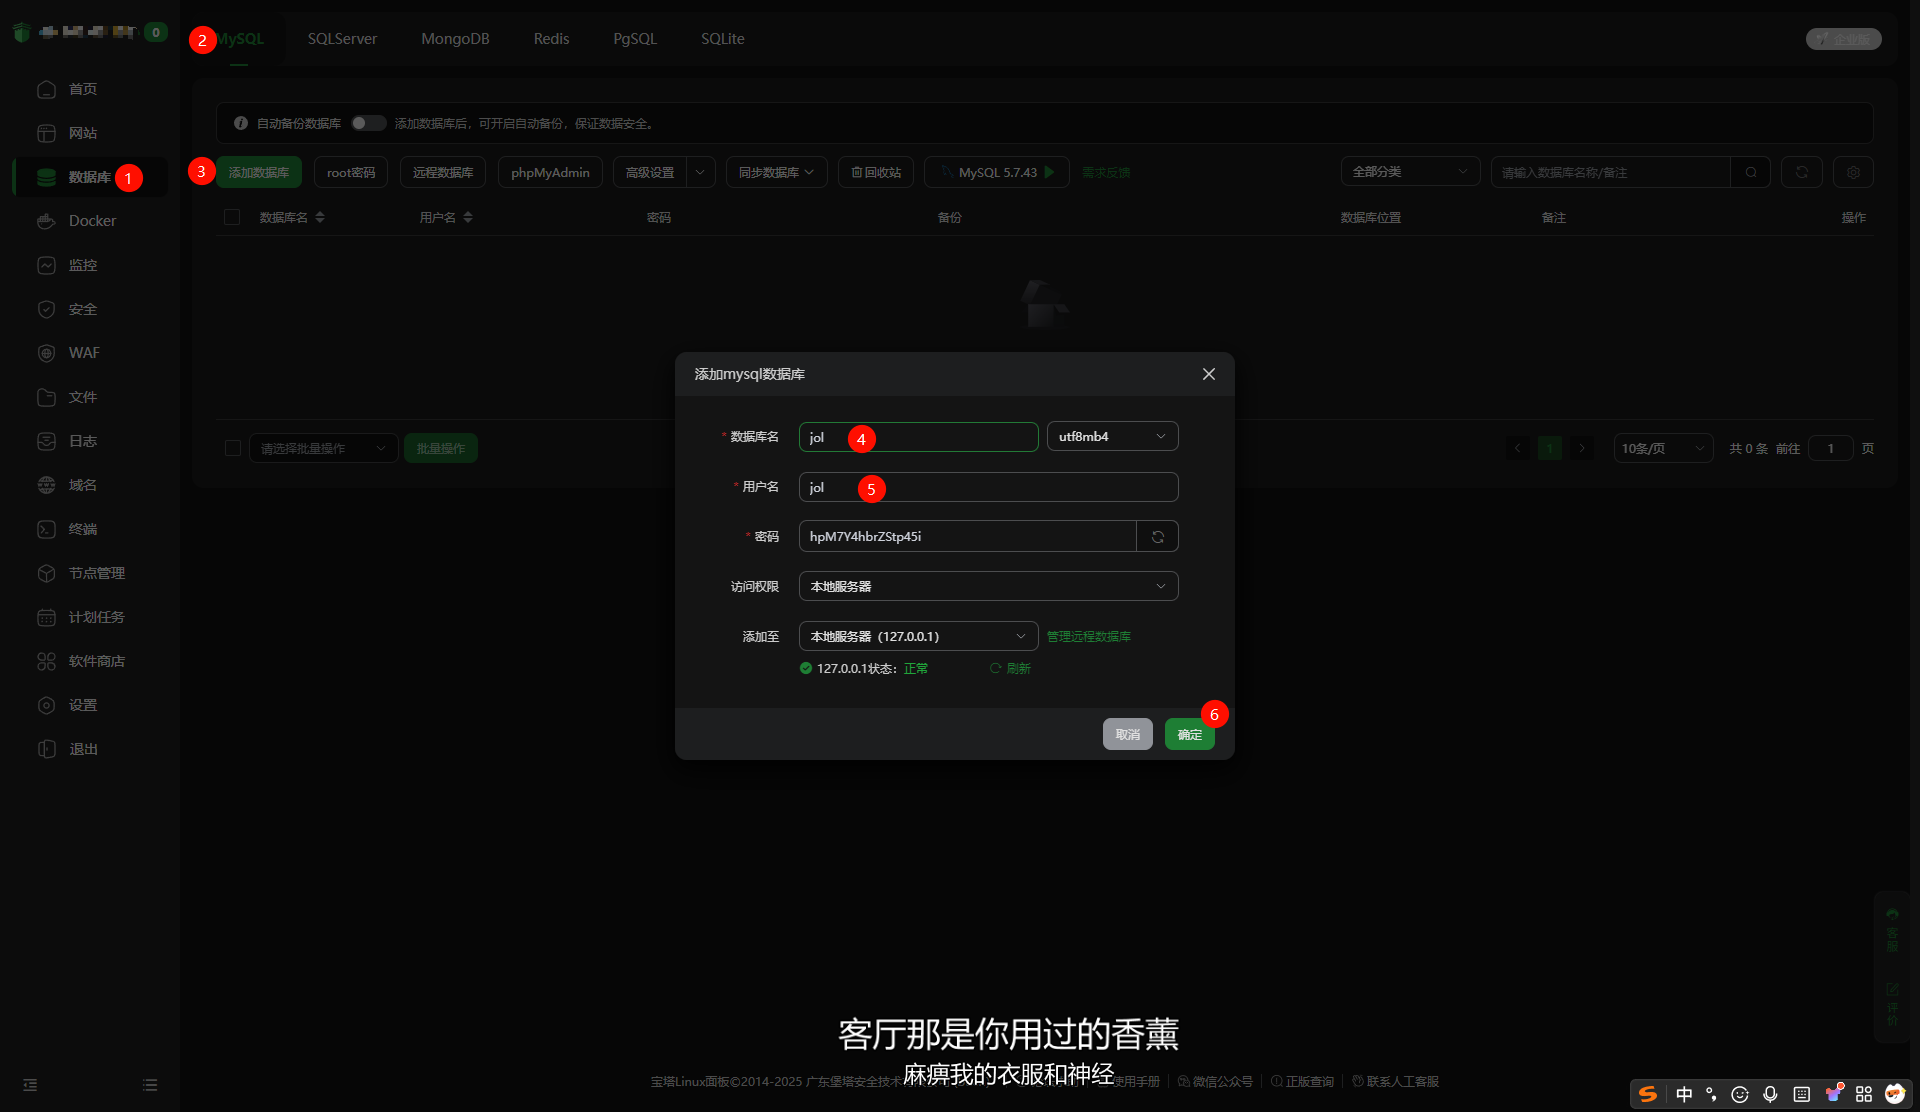
登录上你的 宝塔面板,左侧数据库,创建数据库,数据库名称 jol ,进行创建
image.png

运行安装脚本

先登录上你的 宝塔面板 ,进入左侧终端,执行两条命令

wget http://dl.hustoj.com/install-ubuntu22.04-bt.sh # 拉取安装脚本
bash install-ubuntu22.04-bt.sh # 运行安装脚本

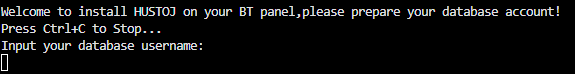
这时,他会要求你输入数据库用户名和密码,请依次键入你创建数据库的时候的用户名和密码
image.png

随后便开始安装了...

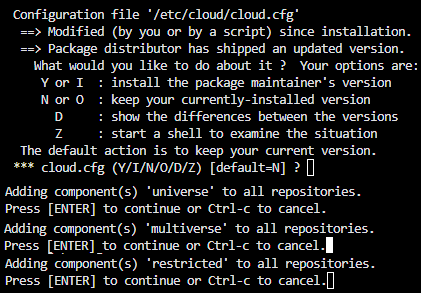
期间可能会多次需要你按下 enter 键

请不要使用 Windows + V 剪切板功能
请保持 bt 窗口活跃
安装速度结合网络宽带而定

需要按 enter 大杂烩:
image.png

创建站点并配置

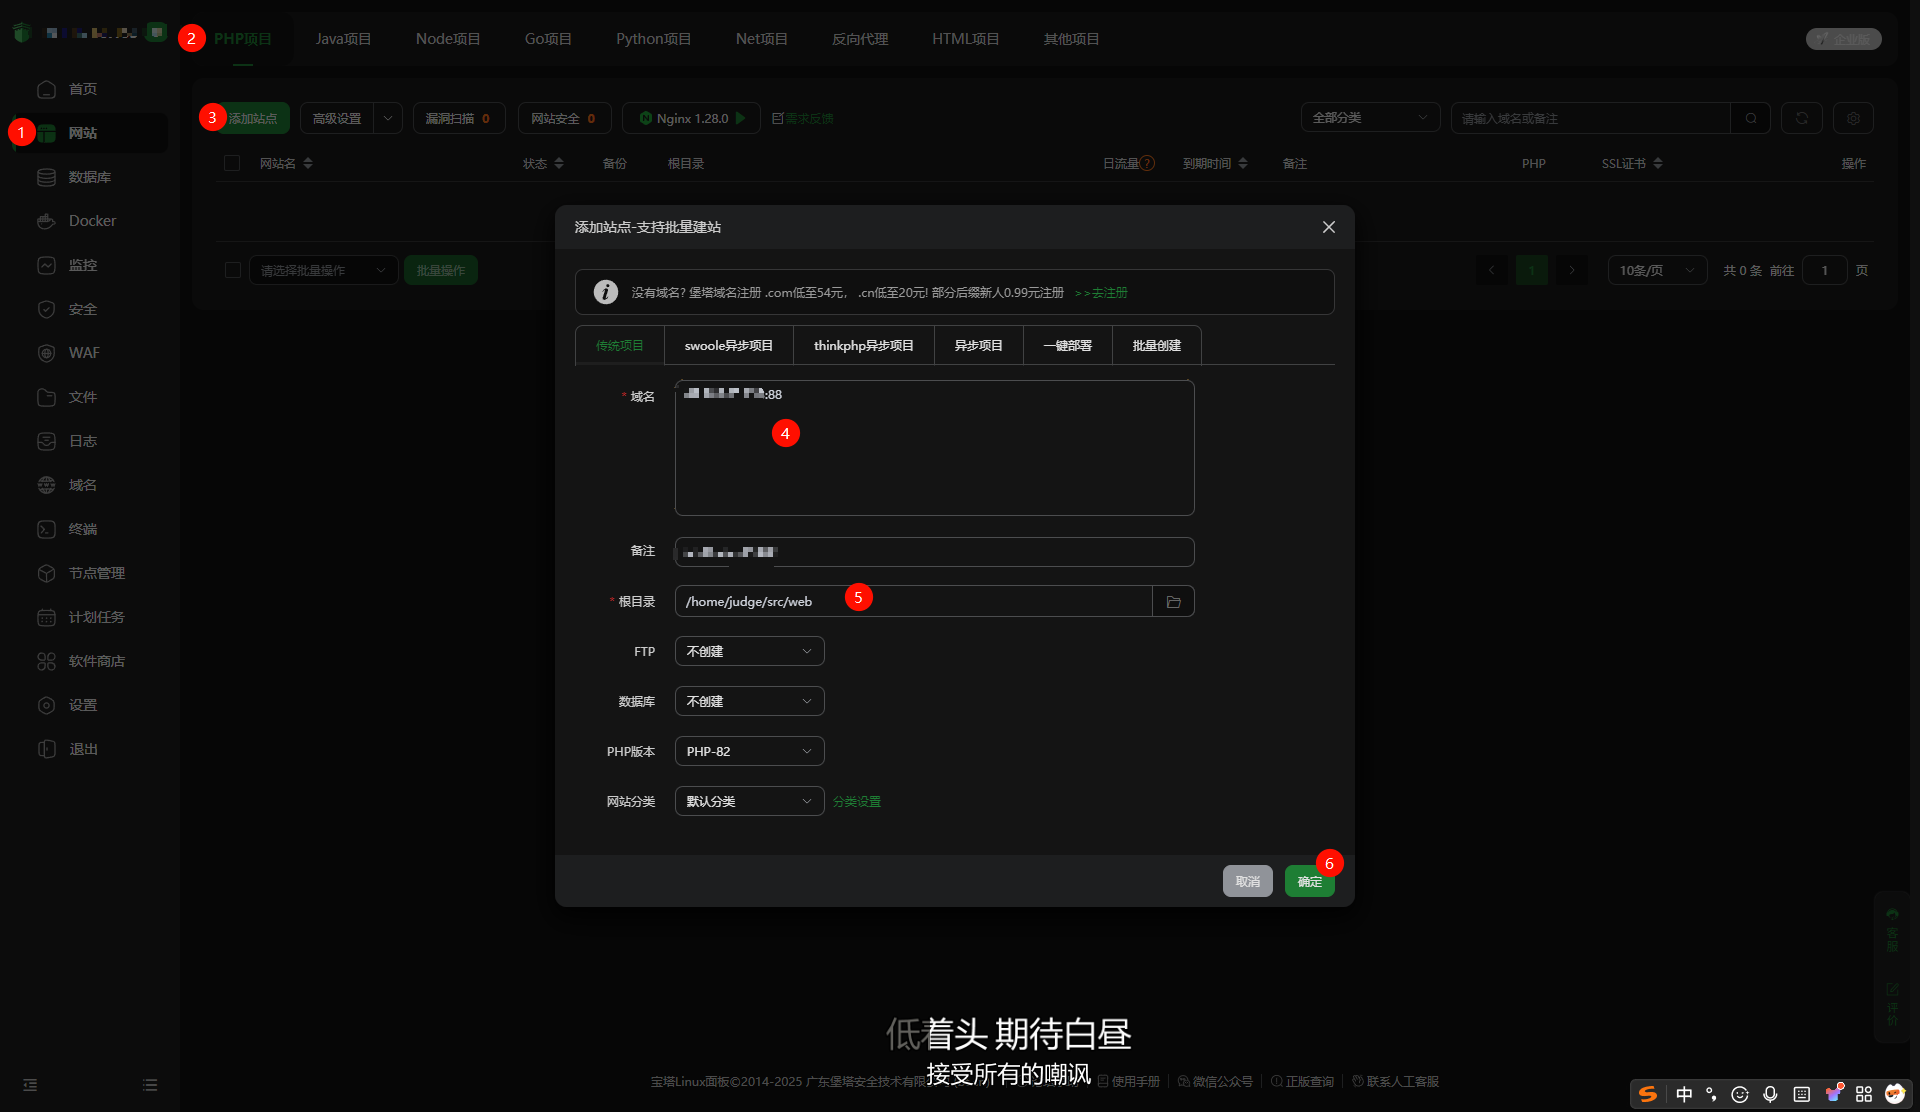
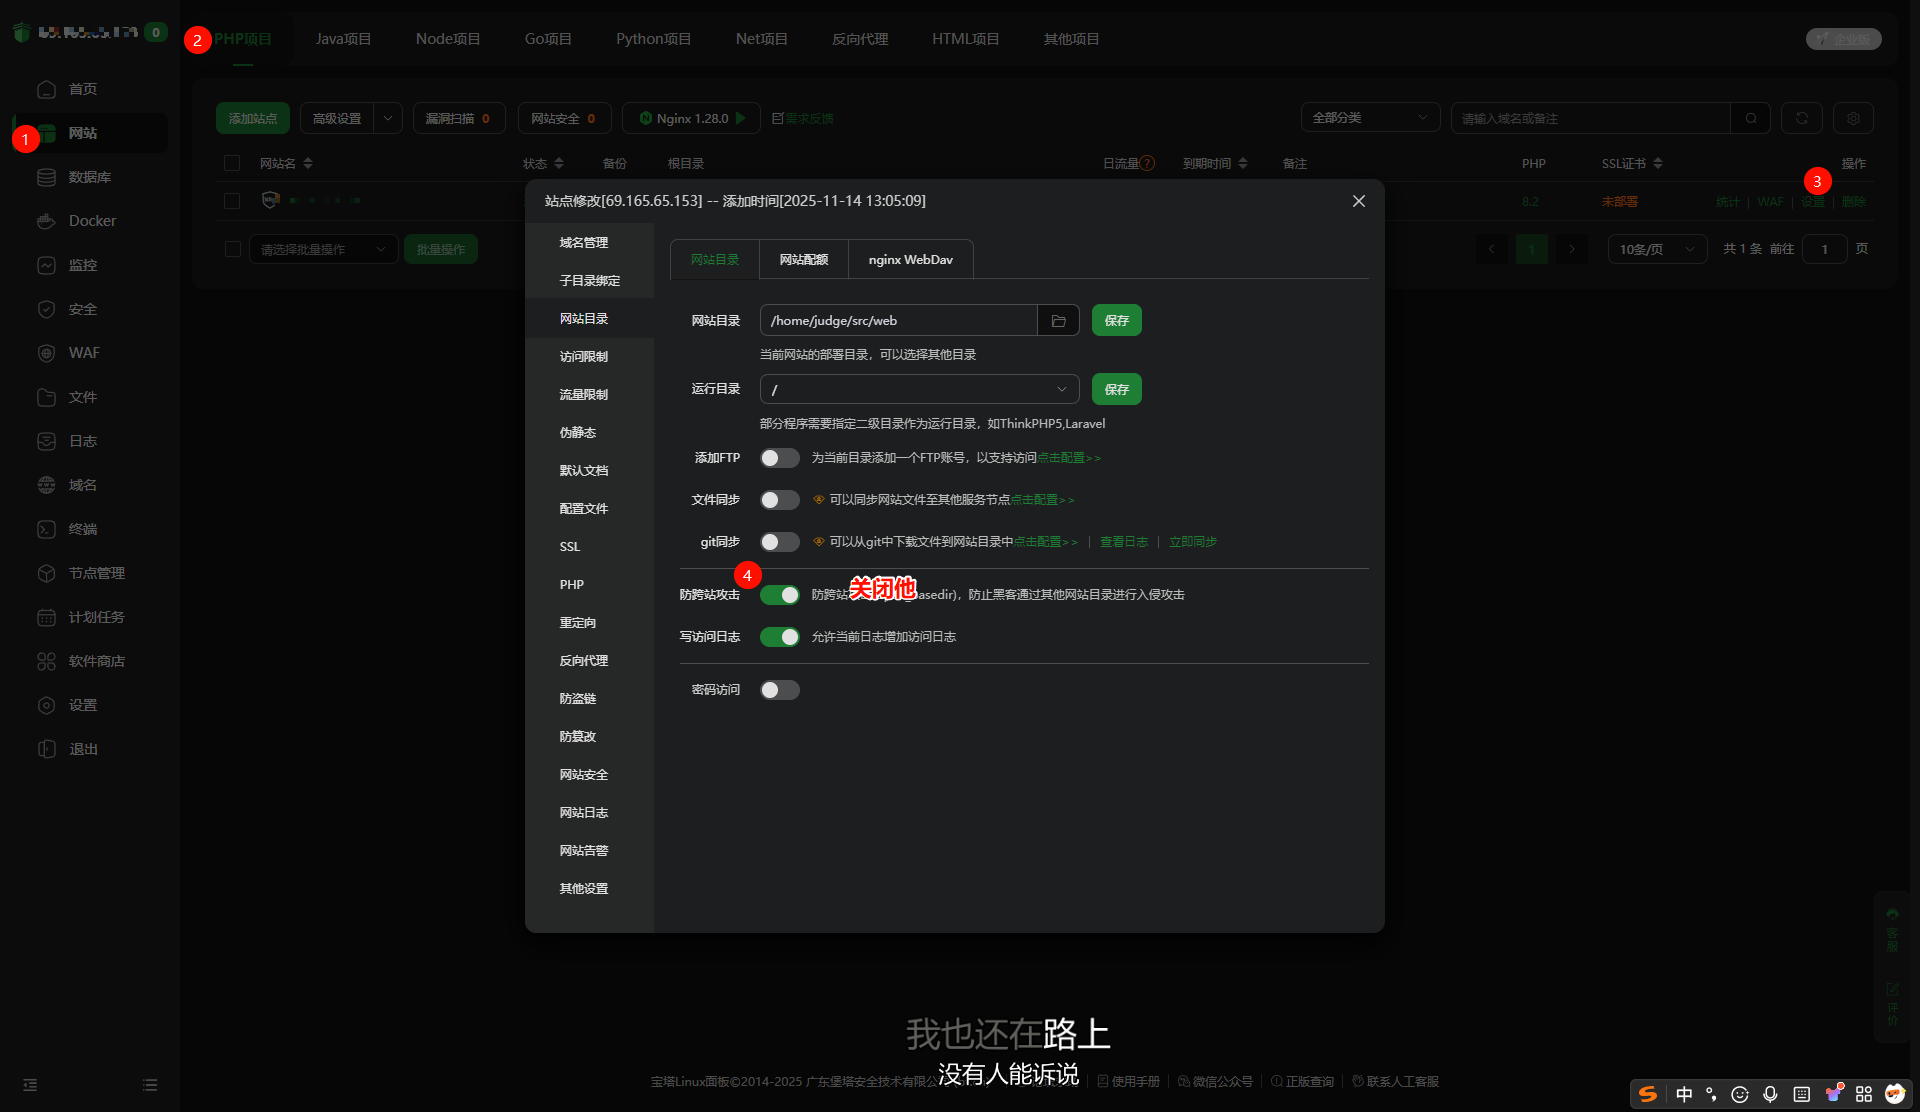
宝塔左边网站,php,创建网站,域名http://<server_ip>:<port>,根目录/home/judge/src/web
image.png

然后设置这个,左边网站目录,关闭放跨站攻击
image.png

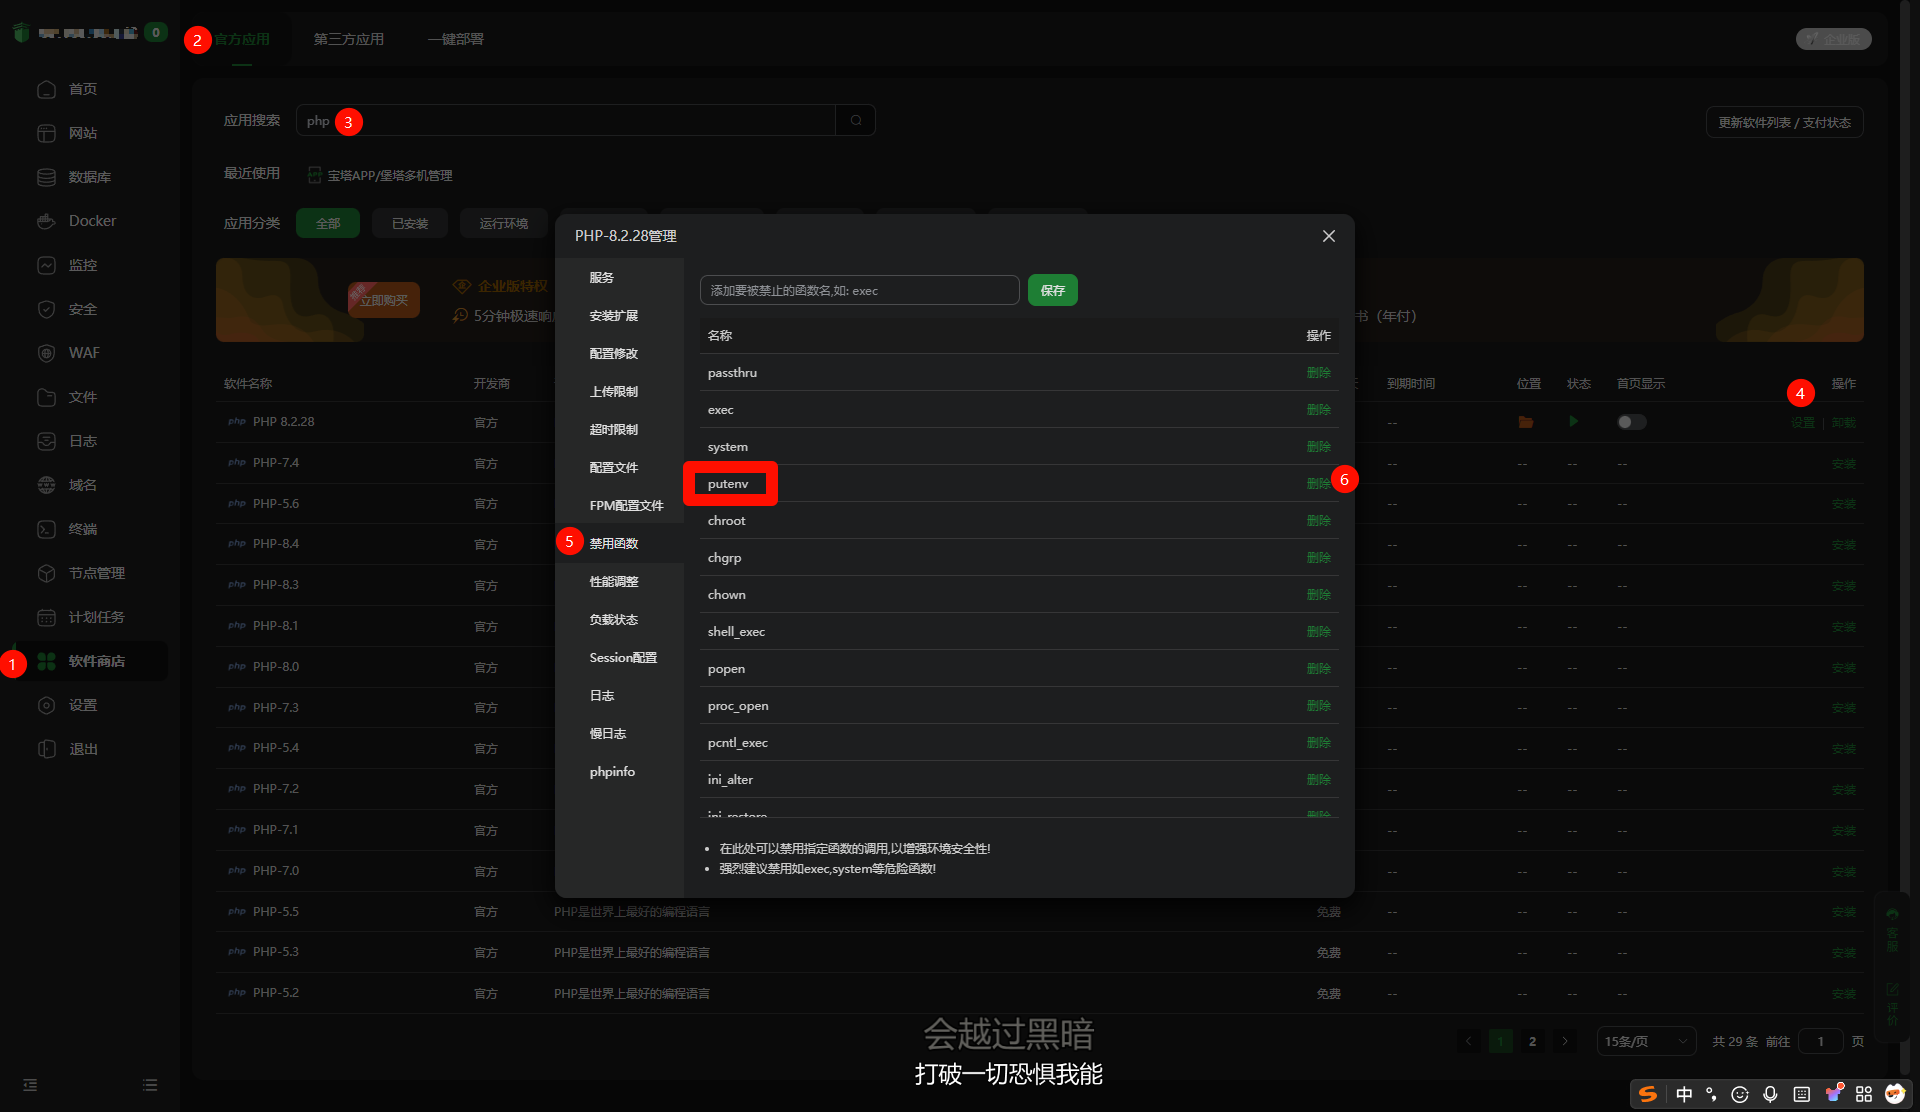
然后,左边软件商店,搜索 php ,设置安装的 php,左边禁用函数,取消 putenv 函数的禁用
image.png

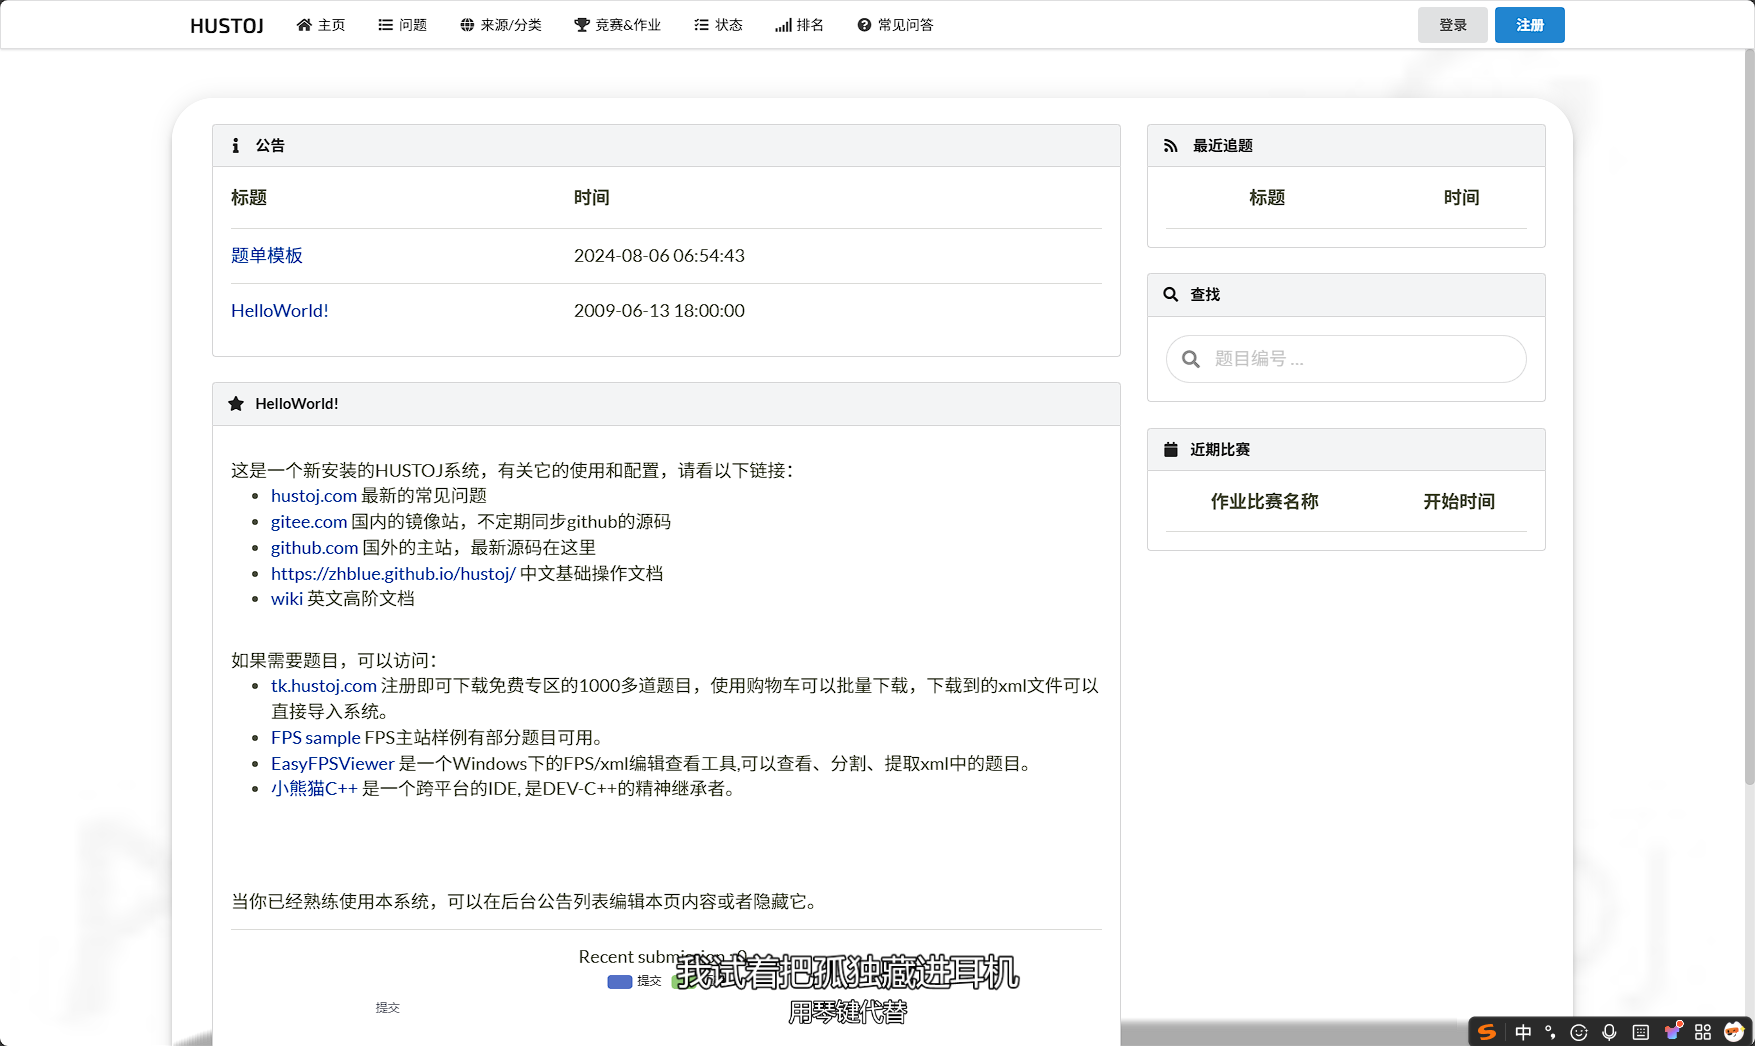
然后,使用浏览器访问你的 oj ,恭喜你,访问成功!
image.png

简单使用 HUSTOJ

注册管理员账户

右上角注册,用户名一定要写admin,其他随意,注册即可

添加一道题目

后台管理 URL 是 http://<server_ip>:<port>/admin/

左侧【问题-管理】【问题-添加】

<span class='md'>
</span>

这是 markdown 的标记,题面需要在里面写,支持 latex、katex

添加即可

维护

系统配置

/home/judge/src/web/include/db_info.inc.php 有注释

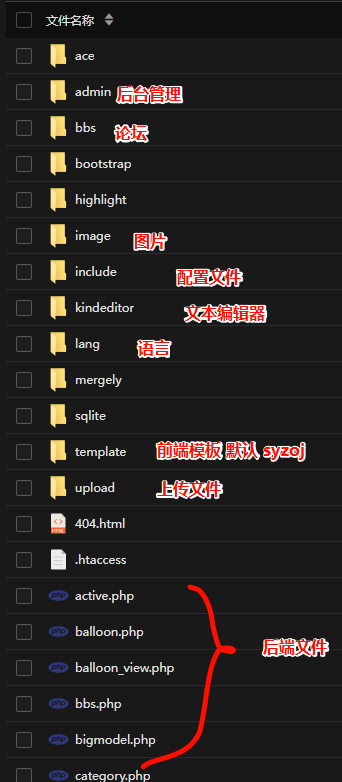
其他你可能需要知道的东西

/home/judge/src/web 是站点文件
image.png


感谢阅读