标签 题解 下的文章

传送门

题目
更好的阅读体验

题目大意

读入一个字符串, 匹配括号字符串所表示的树,求根节点到所有叶节点的距离之和。

分析题目

  • 括号字符串中,每一个叶节点都是对应一个 ();
  • 字符串中的深度比实际深度大 $1$,需要减去 $1$ 再进行计算;
  • 扫描字符串,遇到 ( 深度 $+1$,否则深度 $-1$;
  • 当遇到 () 时,当前的深度 $-1$ 就是根节点到此处的距离;
  • 时间复杂度为 $O(n)$ 可以通过此题。

算法步骤

  1. 扫描字符串,记为 $s_i$;
  2. 对 $s_i$ 作判断,( 和 ) 需要分情况讨论;
  3. 如果遇到 (,深度 $+1$,并且,如果下一个字符是 ) 说明找到了叶节点,将 深度-1 记录到答案,需要注意下个字符是否为合法边界;
  4. 如果遇到 ),深度 $-1$;
  5. 输出答案。

代码

#include <bits/stdc++.h>  
#define int long long // 将所有的 int 替换成 long long,否则会爆 int  
using namespace std;  
string s;  
int ans,depth,i;  
signed main(){ // 因为 int 会被替换成 long long,但是返回值不允许 long long,所以使用 signed  
    cin>>s; // 对应步骤 1  
    for(i=0;i<s.length();i++) // 对应步骤 2  
        if(s[i]==\'(\'){ // 对应步骤 3 及下面两行  
            depth++;  
            if(i+1<s.length()&&s[i+1]==\')\') ans+=depth-1; // 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算  注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 注意 i+1<s.length(),如果当前字符 id +1 比 s 的长度长,那么属于越界操作,不计算 
        }else depth--; // 对应步骤 4  
    cout<<ans; // 对应步骤 5  
}

感受

我也不是打 noip 的货,也很菜

题解

梦熊 NOIP 2025 模拟赛 3 题解

T1 战争游戏

题目描述

游戏在一行 $n$ 个城市上进行,城市 $i$ 初始有士兵 $a_i$ 人。前 $m$ 个城市属于小L,其余属于小K,两人交替操作,小L先手。操作包含三种:

  1. 转移:选择己方地盘上相邻($|x-y|=1$)的两个城市 $x$、$y$,将 $x$ 的所有士兵转移到 $y$,$a_x$ 变为 0。
  2. 攻占:选择己方城市 $x$ 和对方相邻城市 $y$,小L操作需满足 $a_x > a_y$,小K操作需满足 $a_x \geq a_y$,攻占后 $y$ 归己方,士兵转移方式同转移操作。
  3. 不进行任何操作。
    当一方占据所有城市时获胜,需对 $m=1,2,...,n-1$ 分别输出获胜方。

关键思路

  1. 特殊性质B:若先手第一步无法攻占,双方会优先集中兵力,最终比较分界线两侧总兵力。
  2. 特殊性质C:若先手第一步可攻占对方城市且后手无法反制,比较攻占后两侧总兵力。
  3. 正解:先手攻占后需判断对手是否能反制,若能则选择转移兵力,否则执行攻占,核心是比较关键状态下的兵力总和。

T2 加减乘除

题目描述

给定一棵以 1 为根的树,每个节点 $u$ 有运算符号 $op_u$(加或减)和数值 $a_u$。$q$ 次询问,每次给定 $x$,从根节点出发,需满足边的范围条件 $[l_v, r_v]$(即经过节点 $u$ 运算后的 $x'$ 需在子节点 $v$ 的边范围内)才能走向子节点,求能到达的节点个数。

正解

  1. 区间预处理:每个节点 $u$ 对应可到达的 $x$ 区间 $[L_u, R_u]$,初始根节点区间为 $[-\infty, +\infty]$。
  2. 区间更新:向下遍历树时,运算操作会平移区间,边的范围条件会取区间交集,以此递推得到所有节点的 $[L_u, R_u]$。
  3. 高效查询:对所有区间端点离散化,用差分法给每个区间 $[L_u, R_u]$ 加 1,查询时二分找到 $x$ 对应的区间,即可得到答案。
  4. 时间复杂度:$O((n+q) \log n)$。

T3 空之碎物

题目描述

定义二进制不退位减法 $\ominus$,给定序列 $a$,对于区间 $[l, r]$,$f(l, r)$ 表示将该区间元素作为多重集,经若干次合并操作(选两个数合并为其不退位减法结果)后剩余的最大值。求 $\sum_{i=1}^{n} \sum_{j=i+1}^{n} f(i, j)$ 对 998244353 取模的值。

核心性质

  1. 性质1:最终操作结果可表示为 $x \ominus(y \ominus a_1 \ominus a_2 \ominus ... \ominus a_{n-2})$($a_1~a_{n-2}$ 为除 $x,y$ 外的元素)。某二进制位无1时无影响,恰好一个1时贡献由 $y$ 选择决定,至少两个1时贡献为0。
  2. 性质2:若区间长度超过 $\log_2 V + 2$($V$ 为元素最大值,此处 $V < 2^{25}$),则 $f(l, r)$ 等于区间最大值。

正解

  1. 处理长区间:直接累加所有长度超过 $\log_2 V + 2$ 的区间的最大值。
  2. 处理短区间:枚举每个二进制位,对该位有两个1的元素建立连边,通过枚举连边计算贡献,时间复杂度 $O(n \log_2^2 V)$。

T4 Ice Drop

题目描述

一个正整数序列是“好的”,当且仅当对任意正整数 $k$,序列中所有 $k$ 的倍数位置连续。给定序列 $a$,$f(b)$ 表示满足以下条件的“好的”序列 $b'$ 的数量:

  1. $|b'| = |b|$;
  2. 若 $b_i > 1$,则 $b_i' = b_i$;
  3. $LCM(b_1,...,b_m) = LCM(b_1',...,b_m')$($m$ 为 $b$ 的长度)。
    $q$ 次询问,每次给定 $l, r$,求 $\sum_{x=l}^{r} \sum_{y=x}^{r} f(a[x,y])$ 对 $10^9+7$ 取模的值。

关键思路

  1. 核心等价:序列是“好的”等价于每个质因子的指数序列是单峰的。
  2. 特殊性质A($q=1$):不能新增质因子,也不能超过原质因子最大指数,通过组合数计算合法填充方式,答案为各质因子贡献乘积。
  3. 特殊性质B:若只有一个质因子,合法区间是若干不交区间的子集,答案非0即1。
  4. 正解:用扫描线结合线段树,维护全局乘、单点修、查历史和,对每个不交区间单独处理,时间复杂度 $O(n \log n)$。

个人代码

T1

主要思路:骗分

#include <bits/stdc++.h>
using namespace std;
int T,n,i,m,ma,t,a[100010];
string ans;
int main(){
    cin>>T;
    while(T--){
        cin>>n;t=ma=0;ans="";
        for(i=1;i<=n;i++)
            cin>>a[i],ma+=a[i];
        for(m=1;m<n;m++){
            t+=a[m];
            if(2*t>ma) ans+='1';
            else ans+='0';
        }
        cout<<ans<<"\n";
    }
}

太好力,又水了一篇 blog
MX-S11

URL

【MX-X23】梦熊 X 组 · 月亮赛(同步赛) - 洛谷 | 计算机科学教育新生态

【MX-J26】梦熊 J 组 · 月亮赛(同步赛) - 洛谷 | 计算机科学教育新生态

我的分数

X组:10分

J组:210分

MX-J26/X23 月亮赛 官方题解

A. 丢手绢

小朋友的编号为 $1 \sim n$,直接处理不够便捷,因此将所有编号减去 1,转换为 $0 \sim n-1$。这样调整后,便能通过取模运算轻松计算出每个被放手绢的小朋友编号。

具体规则如下:设编号为 $x$ 的小朋友被记录的数字为 $a_{x}$,则被放手绢的小朋友编号为 $(x + a_{x}) \mod n$。需特别注意,此处涉及负数取模的情况,计算时需遵循相应的取模规则。

后续操作流程为:统计每个小朋友被投放手绢的次数,找出其中的最大值,再依次输出所有出现最大值的小朋友的位置(此处位置需根据最初编号规则还原,若最终结果需对应 $1 \sim n$ 的编号,需将计算得到的 $0 \sim n-1$ 编号加 1)。

该算法的时间复杂度为 $O(n)$,其中 $n$ 为小朋友的总数,仅需遍历一次所有小朋友的记录即可完成统计与计算。

B. 括号序列

首先进行初步判断:若括号序列中左括号和右括号的数量不相等,则该括号序列一定无法构成合法序列,直接判定为无解。接下来仅针对左右括号数量相等的情况展开分析。

判断括号序列是否合法可通过前缀和的方法实现,具体定义前缀和数组 $a_i$ 如下:

$$ a_{i}= \begin{cases} 0, & i=0 \\ a_{i-1}+1, & s_{i}='(' \\ a_{i-1}-1, & s_{i}=')' \end{cases} $$

当遇到相邻的 “)(” 时,将其修改为 “()”,这一操作的本质是将初始时 “)” 对应位置的前缀和加 1,而其他位置的前缀和保持不变。括号序列合法的核心条件是:所有位置的前缀和 $a_i \geq 0$。

基于此条件,判断流程如下:找到第一个满足 $a_i < 0$ 的位置,若该位置附近存在可修改的 “)(” 结构(即能通过修改使该位置及后续位置的前缀和均非负),则进行修改操作,随后再次检查修改后的括号序列是否满足所有前缀和 $a_i \geq 0$,以此确定序列是否合法。

该算法的时间复杂度为 $O(n)$,$n$ 为括号序列的长度,仅需遍历一次序列即可完成前缀和计算与合法性判断。

C. 猜拳游戏

首先定义 $g = \gcd(n, m)$(即 $n$ 和 $m$ 的最大公约数),并令 $n' = \frac{n}{g}$,$m' = \frac{m}{g}$。

在猜拳游戏中,$10100$ 是一个足够大的数字(其值超过 $\text{lcm}(n, m)$,即 $n$ 和 $m$ 的最小公倍数),因此只需考虑游戏不断进行过程中可能出现的所有状态。

将字符串 $a$(长度为 $n$)和字符串 $b$(长度为 $m$)分别按照下标对 $g$ 取模的余数进行分组,共可分为 $g$ 组。以第 $k$ 组($0 \leq k < g$)为例,字符串 $a$ 中属于该组的有 $n'$ 个招式,字符串 $b$ 中属于该组的有 $m'$ 个招式,这两组招式两两组合形成的 $n' \times m'$ 种情况,一定会在同一局游戏中全部出现。

若要避免平局,必须保证字符串 $a$ 中该组的 $n'$ 个招式组成的集合与字符串 $b$ 中该组的 $m'$ 个招式组成的集合没有交集(即两组招式完全不同)。

接下来需讨论 “石头(R)、剪刀(P)、布(S)” 这三种招式在字符串 $a$ 和 $b$ 中的可选情况,在所有合法的情况中选择操作次数最少的方案,最后将 $g$ 组的最少操作次数相加,得到最终的答案。

该算法的时间复杂度为 $O(n + m)$,其中 $n$ 和 $m$ 分别为字符串 $a$ 和 $b$ 的长度,需分别遍历两个字符串完成分组与招式集合的判断。

D. 卡常数

首先分析单个数列的情况:对于某一数列,选择其中一个位置 $j$,会使该数列的代价乘以系数 $\frac{a_{i,j} - b_{i,j}}{a_{i,j}}$(其中 $a_{i,j}$ 和 $b_{i,j}$ 为该数列第 $j$ 个元素的相关参数)。由于该系数为真分数,将数列中所有这样的真分数按照从小到大的顺序排列后,从左到右选择这些真分数(即优先选择较小的真分数),能使数列代价的减少量最大,是最优的选择策略。

进一步计算每个数列中,按照上述顺序选择每个元素时,该元素能让数列代价比选择上一个元素后再减少的量,将这个减少量定义为该元素的“价值”。通过分析可发现,在同一个数列中,元素的价值是单调递减的(即越靠后选择的元素,其减少代价的能力越弱)。

基于单个数列的价值特性,将所有数列中所有元素的价值整合到一个集合中,对该集合按照从大到小的顺序排序,然后依次选择价值最大的元素,即可实现整体代价的最小化。

贪心策略正确性证明:由于单个数列内部元素的价值单调递减,后续元素的价值必然小于前面元素的价值,因此在选择时,后续元素不可能先于前面元素被选中,这就保证了将所有元素价值排序后从大到小选择的贪心策略是正确的。

设 $m = \sum l_i$(其中 $l_i$ 为第 $i$ 个数列的长度),则该算法的时间复杂度为 $O(m \log m)$,主要耗时在于对所有元素价值的排序操作。

E. 向死存魏

首先采用离线处理的方式,将所有的“二操作”(具体操作含义需结合题目背景,此处默认是对序列的修改或查询操作)加入到操作序列中。在执行操作的过程中,实时记录当前序列的长度,若某一查询操作要求的答案超过当前序列的长度,则判定该查询无解。设所有操作全部结束后,序列的最终长度为 $k$。

对于删除操作,由于每个元素至多被删除一次,且序列的最终长度为 $k$,因此可使用 $set$ 数据结构对序列进行暴力修改(如标记删除或直接移除元素),操作效率可满足需求。

对于查询操作,首先利用双指针法预处理出初始状态下从序列每个位置开始查询的答案。在后续的删除操作中,针对被删除的元素 $x$,先确定其删除区间:设删除区间左边第一个未被删除的位置为 $p$(若不存在这样的位置,则令 $p = 0$),删除区间右边第一个未被删除的位置为 $q$(若不存在这样的位置,则令 $q = k + 1$)。删除该区间内所有的 $x$ 后,会对起始位置在 $[p + 1, q - 1]$ 范围内的查询产生影响——从这些起始位置开始查询时,需要到位置 $q$ 才能找到元素 $x$。

为高效处理上述区间影响,需对 $[p + 1, q - 1]$ 范围内的当前查询答案进行更新(将答案设为 $q$),此处可使用线段树维护“区间取最值、单点查询”的操作,确保查询与更新的效率。

该算法的时间复杂度为 $O((k + m) \log k)$,其中 $k$ 为序列最终长度,$m$ 为操作总数,线段树的查询与更新操作均为 $O(\log k)$ 复杂度,且需处理 $m$ 次操作。

F. 网格 III

在网格操作中,每一次操作至多会影响 $O(n)$ 个格子($n$ 为网格的边长或相关维度参数),因此只需关注当前操作实际改变的格子数量即可。

由于行列混合操作较为复杂,可将其拆分为两个独立的部分讨论:一是计算有多少行对当前列的修改产生贡献,二是计算有多少列对当前行的修改产生贡献。下文以“计算行对当前列修改的贡献”为例展开分析。

首先为每行和每列分别记录两个关键信息:最后一次修改的时间、最后一次修改的颜色(如红色或白色)。对于网格中 $k \times k$ 的正方形区域,其对应的所有行列信息仅存在两种不同的有效情况:

  1. 该正方形区域内所有列的修改颜色均为红色,且最晚的白色行修改时间在最早的红色列修改时间之前;
  2. 该正方形区域内存在列的修改颜色为白色,且所有行的修改颜色均为红色,同时最早的红色行修改时间在最晚的白色列修改时间之后。

由于 $k$ 的取值较小,可直接枚举包含当前列且长度为 $k$ 的区间,暴力查询该区间内的行列信息,进而统计满足上述两种情况的行的数量。为提高效率,对于每行,预先记录所有长度为 $k$ 的区间的信息,每次修改操作仅会改变 $O(k)$ 个区间的信息,后续可通过一维偏序的方法查询满足条件的行数量。

为简化时间与颜色的判断逻辑,对修改时间进行如下处理:若修改颜色为红色,时间值保持不变;若修改颜色为白色,时间值取其相反数。初始状态下,所有行列的修改颜色默认为红色,时间值可设为初始常量(如 0)。经过这样的处理,上述两种情况的判断可转化为对区间内时间值取最小值的操作。

可使用树状数组或线段树维护区间最小值,若直接暴力求区间最小值,算法的时间复杂度为 $O(n k^2 + n k \log n)$;若采用单调队列对区间最小值查询进行优化,时间复杂度可降至 $O(n k \log n)$,其中 $n$ 为网格的相关维度参数,$k$ 为正方形区域的边长。

G. 我爱数数

设 $t_i$ 表示使 $b_i \geq a_i$ 所需的操作次数($a_i$ 和 $b_i$ 为题目给定的数组元素),则本题的答案等价于求 $E[\max_{i=1}^{n} t_i]$(即 $t_i$ 最大值的期望)。

可通过容斥原理计算该期望,具体公式为:答案等于对所有非空子集 $S \subseteq [n]$,求和 $(-1)^{|S| - 1} \times E[\min_{i \in S} t_i]$(其中 $|S|$ 表示子集 $S$ 的元素个数,$E[\min_{i \in S} t_i]$ 表示子集 $S$ 中 $t_i$ 最小值的期望)。

期望计算分析

假设有 $x$ 个区间满足:对任意 $i \in [l_p, r_p] \cap S$,均有 $c_p < a_i$($[l_p, r_p]$ 为区间的左右端点,$c_p$ 为区间的相关参数)。此时,剩余的 $m - x$ 个区间($m$ 为总区间数)一旦被选中,就会覆盖子集 $S$ 中的某个元素,导致 $t_i$ 的值固定。

在上述假设下,$E[\min_{i \in S} t_i]$ 的计算过程如下:

$$ E[\min_{i \in S} t_i] = \sum_{i=0}^{+\infty} \frac{x^i (m - x) (i + 1)}{m^{i + 1}} = \frac{m}{m - x} $$

基于此,定义 $w_x$ 为:对所有满足“恰好有 $x$ 个区间符合上述条件”的子集 $S$,求和 $(-1)^{|S| - 1}$。则最终答案可表示为:

$$ \text{答案} = \sum_{x=0}^{m - 1} w_x \times \frac{m}{m - x} $$

动态规划与优化

为计算 $w_x$,引入辅助函数 $h_i$,定义如下:

$$ h_i = \begin{cases} a_i - 1 & i \in S \\ +\infty & \text{Otherwise} \end{cases} $$

此时,“对任意 $i \in [l_p, r_p] \cap S$,$c_p < a_i$”这一限制条件可转化为“对任意 $i \in [l_p, r_p]$,$c_p \leq h_i$”。

进一步构建小根笛卡尔树(基于 $h_i$ 的值),并在树上进行动态规划。定义状态 $f_{L, R, u, x, 0/1}'$,其含义为:

  • 考虑区间 $[L, R]$,仅关注 $h_i \geq u$ 的位置,且 $[L, R]$ 是一个连续段(即 $h_{L - 1} < u$ 且 $h_{R + 1} < u$);
  • 满足 $L \leq l_p \leq r_p \leq R$ 且 $c_p \leq x \leq \min_{i \in [l_p, r_p]} h_i$ 的区间 $p$ 共有 $x$ 个;
  • 子集 $T = S \cap [L, R]$ 的元素个数为偶数(对应“0”)或奇数(对应“1”);
  • 该状态的值表示满足上述条件的子集 $T$ 的数量。

令 $f_{L, R, u, x} = f_{L, R, u, x, 0}' - f_{L, R, u, x, 1}'$,并引入辅助数组 $g$,则动态规划的转移公式如下:

$$ g_{L, R, u, x} = f_{L, R, u + 1, x} - \sum_{i=L}^{R} [h_i = u] \sum_{y=0}^{x} f_{L, i - 1, u + 1, y} \times g_{i + 1, R, u, x - y} $$

$$ f_{L, R, u, x} = g_{L, R, u, x - s_{L, R, u}} $$

其中 $s_{L, R, u}$ 表示满足 $L \leq l_p \leq r_p \leq R$ 且 $c_p = u$ 的区间 $p$ 的数量。

时间复杂度优化

若直接按照上述转移公式计算,时间复杂度为 $O(n^4 m^2)$($n$ 为数组长度,$m$ 为总区间数)。但通过观察可知,$h_i = u$ 的位置对于所有 $u$ 而言,总数仅为 $n$ 个,因此可将时间复杂度优化至 $O(n^3 m^2)$。

进一步利用经典的拉格朗日插值(拉插)技巧,可将转移过程中的卷积运算转化为点乘运算,此时时间复杂度可降至 $O(n^3 m + m^2)$。关于拉格朗日插值技巧的具体应用,可参考题目 CF1874E Jellyfish and Hack。

我的评价

首先,让我吐槽一下这次比赛XJ的题目分配

题目分配

MX-J+XABCDEFG
洛谷T1T2T3T4T5T6T7
MX-J26√√√√√
MX-X23 √√√√√
知识点入门入门入门提高提高NOINOI

开始吐槽

在我的印象里,CSP-X是小学组的难度,但是,这里为什么X组的难度有NOI,我就感觉很猎奇,而且,为什么J组的第一二题在X组没,Who can tell me?

关于各题

【MX-X23-T1】丢手绢

这道题我大概提交了有好几次,主要是老是TLE,原因是因为写了太多没用的循环,这是AC的代码

#include <bits/stdc++.h>
using namespace std;
const int N=100010;
int n,x,i,f[N],ma,s;
int main(){
    cin>>n;
    for(i=1;i<=n;i++){
        cin>>x;s=i+x;
        while(s<1) s+=n;
        while(s>n) s-=n;
        f[s]++;
        ma=max(ma,f[s]);
    }
    for(i=1;i<=n;i++) if(f[i]==ma) cout<<i<<" ";
}

注意超n和小1的数据处理

【MX-X23-T2】括号串

这道题,我当时是在洛谷搜一道题,叫做括号串匹配,然后,找到了,但是没用,然后我在CSXX上找答案,找到了,但是没用

所以只好独立思考

namespace pts70{
bool check(string s){
    int tmp,i;
    for(i=tmp=0;i<s.length();i++){
        if(s[i]=='(') tmp++;
        else if(s[i]==')'){
            tmp--;
            if(tmp<0) return 0;
        }
    }
    return tmp==0;
}
int main(){
    cin>>T;
    while(T--){
        cin>>n>>s;fl1=0;
        if(check(s)) fl1=1;
        if(n>1000){cout<<(fl?"Yes":"No")<<"\n";continue;}
        ss=s;
        for(i=0;i<ss.length()-1;i++){
            ss=s;
            if(ss[i]==')'&&ss[i+1]=='('){
                ss[i]='(';ss[i+1]=')';
                if(check(ss)) fl=1;
                else ss=s;
            }
        }
        cout<<(fl?"Yes":"No")<<"\n";
    }
    return 0;
}
}

思路其实也很明显了,就是死暴力,check函数就是判断这个字符串的括号是否合法,然后,20-29行就是两个字符串一个一个往后做,替换,然后判断,可以就输出,不可以就下一个

测试点编号结果时间内存
1AC4ms788.00KB
2AC4ms788.00KB
3AC4ms832.00KB
4AC8ms788.00KB
5AC8ms832.00KB
6AC34ms788.00KB
7AC33ms788.00KB
8WA32ms788.00KB
9WA32ms788.00KB
10WA34ms788.00KB

然后我看了一眼前面那个人的代码,发现是我想多了,代码

#include <bits/stdc++.h>
using namespace std;
const int N=100010;
int T,n,t,w,wz,i,fl1,fl2,sts;
char s[N];
void count(){
    if(s[i]=='(') t++;
    if(s[i]==')') w++;
}
int main(){
    cin>>T;
    while(T--){
        cin>>n;t=w=0;fl1=1;
        for(i=1;i<=n;i++){
            cin>>s[i];
            count();
            if(t<w){fl1=0;wz=i;}
        }
        if(t==w){
            sts=1;
            if(fl1==1){cout<<"Yes\n";sts=0;continue;}
            swap(s[wz],s[wz+1]);
            t=w=0;fl2=1;
            for(i=1;i<=n;i++){
                count();
                if(t<w) fl2=0;
            }
            if(wz==n) fl2=0;
            if(sts==1) cout<<(fl2?"Yes":"No")<<"\n";
        }else{cout<<"No\n";continue;}
    }
}

【MX-X23-T3】猜拳游戏

不会做,这个代码 10pts

#include <bits/stdc++.h>
using namespace std;

int main(){
    cout<<1;
}
题目

上海市2025CSP-J十连测Round 5

大感

难度感觉还好,我这次也是拿到了80分的成绩,试卷打印的时候少了第一道完善程序,所以这份试卷的第一道完善程序作废,不得分

错题大纲

一 单项选择

T6

题目:设某算法的计算时间表示为递推关系式$ T(n)=T(n-1)+n $,$ n $为正整数,$ T(0) = 1$则该算法的时间复杂度为( )

A $ O(logn) $
B $ O(nlogn) $
C $ O(n) $
D $ O(n^2)$

这道题,我当时是模拟了一下,模拟的结果是这样的:

T(5)=T(4)+5
T(4)=T(3)+4
T(3)=T(2)+3
T(2)=T(1)+2
T(1)=0

此时,$n$为5,一共做了5次的$T(n)$,则时间复杂度为$O(n)$

但是错了

我估摸着是答案写错了

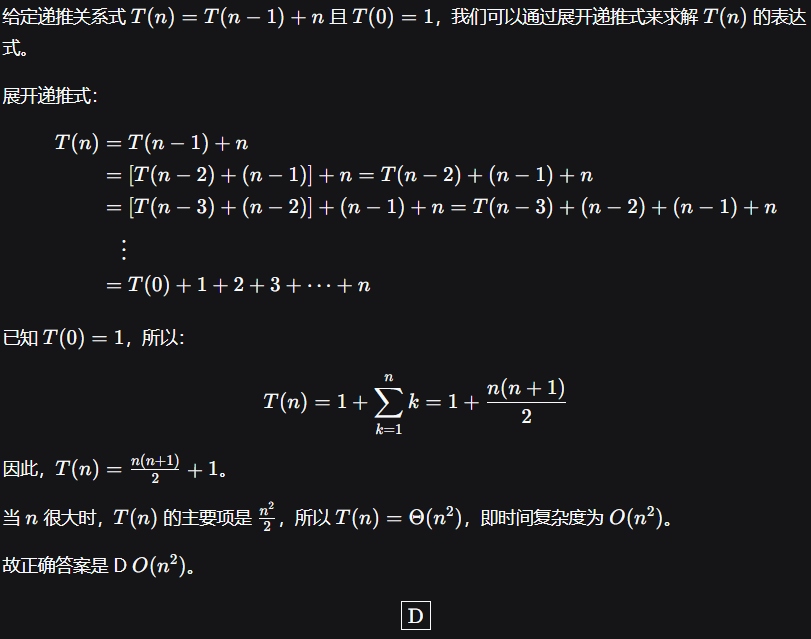
然后,我们邀请AI:

image.png

给定递推关系式 (T ( n )=T ( n-1 )+n)且 (T ( 0 )=1) ,我们可以通过展开递推式来求解 (T ( n ))的表达式。 展开递推式:

[
\begin{array}{l} T (n) = T (n - 1) + n \ = [ T (n - 2) + (n - 1) ] + n = T (n - 2) + (n - 1) + n \ = [ T (n - 3) + (n - 2) ] + (n - 1) + n = T (n - 3) + (n - 2) + (n - 1) + n \ \vdots \ = T (0) + 1 + 2 + 3 + \dots + n \ \end{array}
]

已知 T(0)=1,所以:

[
T (n) = 1 + \sum_ {k = 1} ^ {n} k = 1 + \frac {n (n + 1)}{2}
]

因此, (T ( n ) = \frac { n ( n + 1 ) } { 2 } + 1。) 当 (n) 很大时, (T(n)) 的主要项是 (\frac{n^2}{2}) ,所以 (T(n) = \Theta (n^2)) ,即时间复杂度为 (O(n^2)) 故正确答案是D (O(n^2)) 。

说人话,就是模拟的数据太小了,建议增加数据模拟值

T10

题目:具有$n$个顶点,$e$条边的图采用邻接表存储结构,进行DFS和BFS的时间复杂度均为( )

A $O(n+e)$
B $O(ne)$
C $O(e^2)$
D $O(n^2)$

我在考试中选了B,那时候我根本不知道邻接表是啥

现在让我们邀请AI

邻接表
邻接表是图的一种高效存储结构,用于表示顶点间的关联关系,尤其适合稀疏图(边数远少于顶点数平方)。
存储方式分两部分:

  1. 顶点表:用数组或链表存储所有顶点信息,每个顶点元素关联一个指针,指向其邻接边的列表。
  2. 邻接边表:为每个顶点建立一个链表,链表节点存储与该顶点直接相连的“邻接顶点索引”及边的权重(无向图/有向图通用)。比如无向图中顶点A连B,A的邻接表含B,B的邻接表也含A;有向图中A→B仅A的邻接表含B。
    相比邻接矩阵,邻接表节省空间,查询顶点邻接边时效率更高,是图论中常用的存储方式。

继续邀请ai分析题目

答案选A:$O(n+e)$
解析:在邻接表存储结构中,DFS(深度优先搜索)和BFS(广度优先搜索)遍历图时,每个顶点都会被访问一次(时间复杂度$O(n)$),同时每条边也会被检查一次(时间复杂度$O(e)$)。
两种算法的总操作次数是顶点访问次数与边检查次数的总和,因此时间复杂度均为$O(n+e)$,适用于有向图和无向图的情况。

所以,选A,说人话:分别遍历点和边

T15

题目:由数字1,1,2,4,8,8所组成的不同的四位数的个数是( )

A 102
B 120
C 560
D 720

考试中,不知道就选C

答案为A
本题有4种情况,他们分别是无重复数字 $A_4^4$共24种、含2个1(无8重复) $C_2^4 \times A_2^3=6 \times 6=36$、含两个8(无1重复) $C_2^4 \times A_2^3=36$、含两个1和两个8 C_2^4=6,综合为102种

二 阅读程序

第一大题

#include<iostream>
int main()
{
    int n, c;
    std::cin >> n >> c;
    long long sum = 0;
    int pre = 1000000000;
    for (int i = 0; i < n; ++i) {
        int a;
        std::cin >> a;
        if (pre > a) {
            pre = a;
        }
        sum += pre;
        pre += c;
    }
    std::cout << sum << "\n";
}

T16

题目:当输入的a全部相等时,程序输出的结果一定等于$n \times a$

我当时考试中填的是正确

当时也没模拟完整

考试后模拟的样例:

input

5 3
3 3 3 3 3

output

45

事实声明,本题为×

第二大题

bool c[max_size][max_size] = {false};
void draw(int size, int x, int y)
{
    if (size == 1)
    {
        c[x][y] = true;
    }
    else
    {
        int half = size / 2;
        draw(half, x + half, y);
        draw(half, x, y + half);
        draw(half, x + half, y + half);
    }
}
void print(int n)
{
    int length = 1 << n;
    draw(length, 0, 0);
    for (int x = 0; x < length; ++x)
    {
        for (int y = 0; y < length; ++y)
        {
            if (c[x][y])
                std::cout << '*';
            else
                std::cout << '.';
        }
        std::cout << "\n";
    }
}

这个代码怎么不完整

T20

题目:在draw的过程中,左上角的四分之一子区域始终不会被绘制

当时我模拟是模拟到这里了

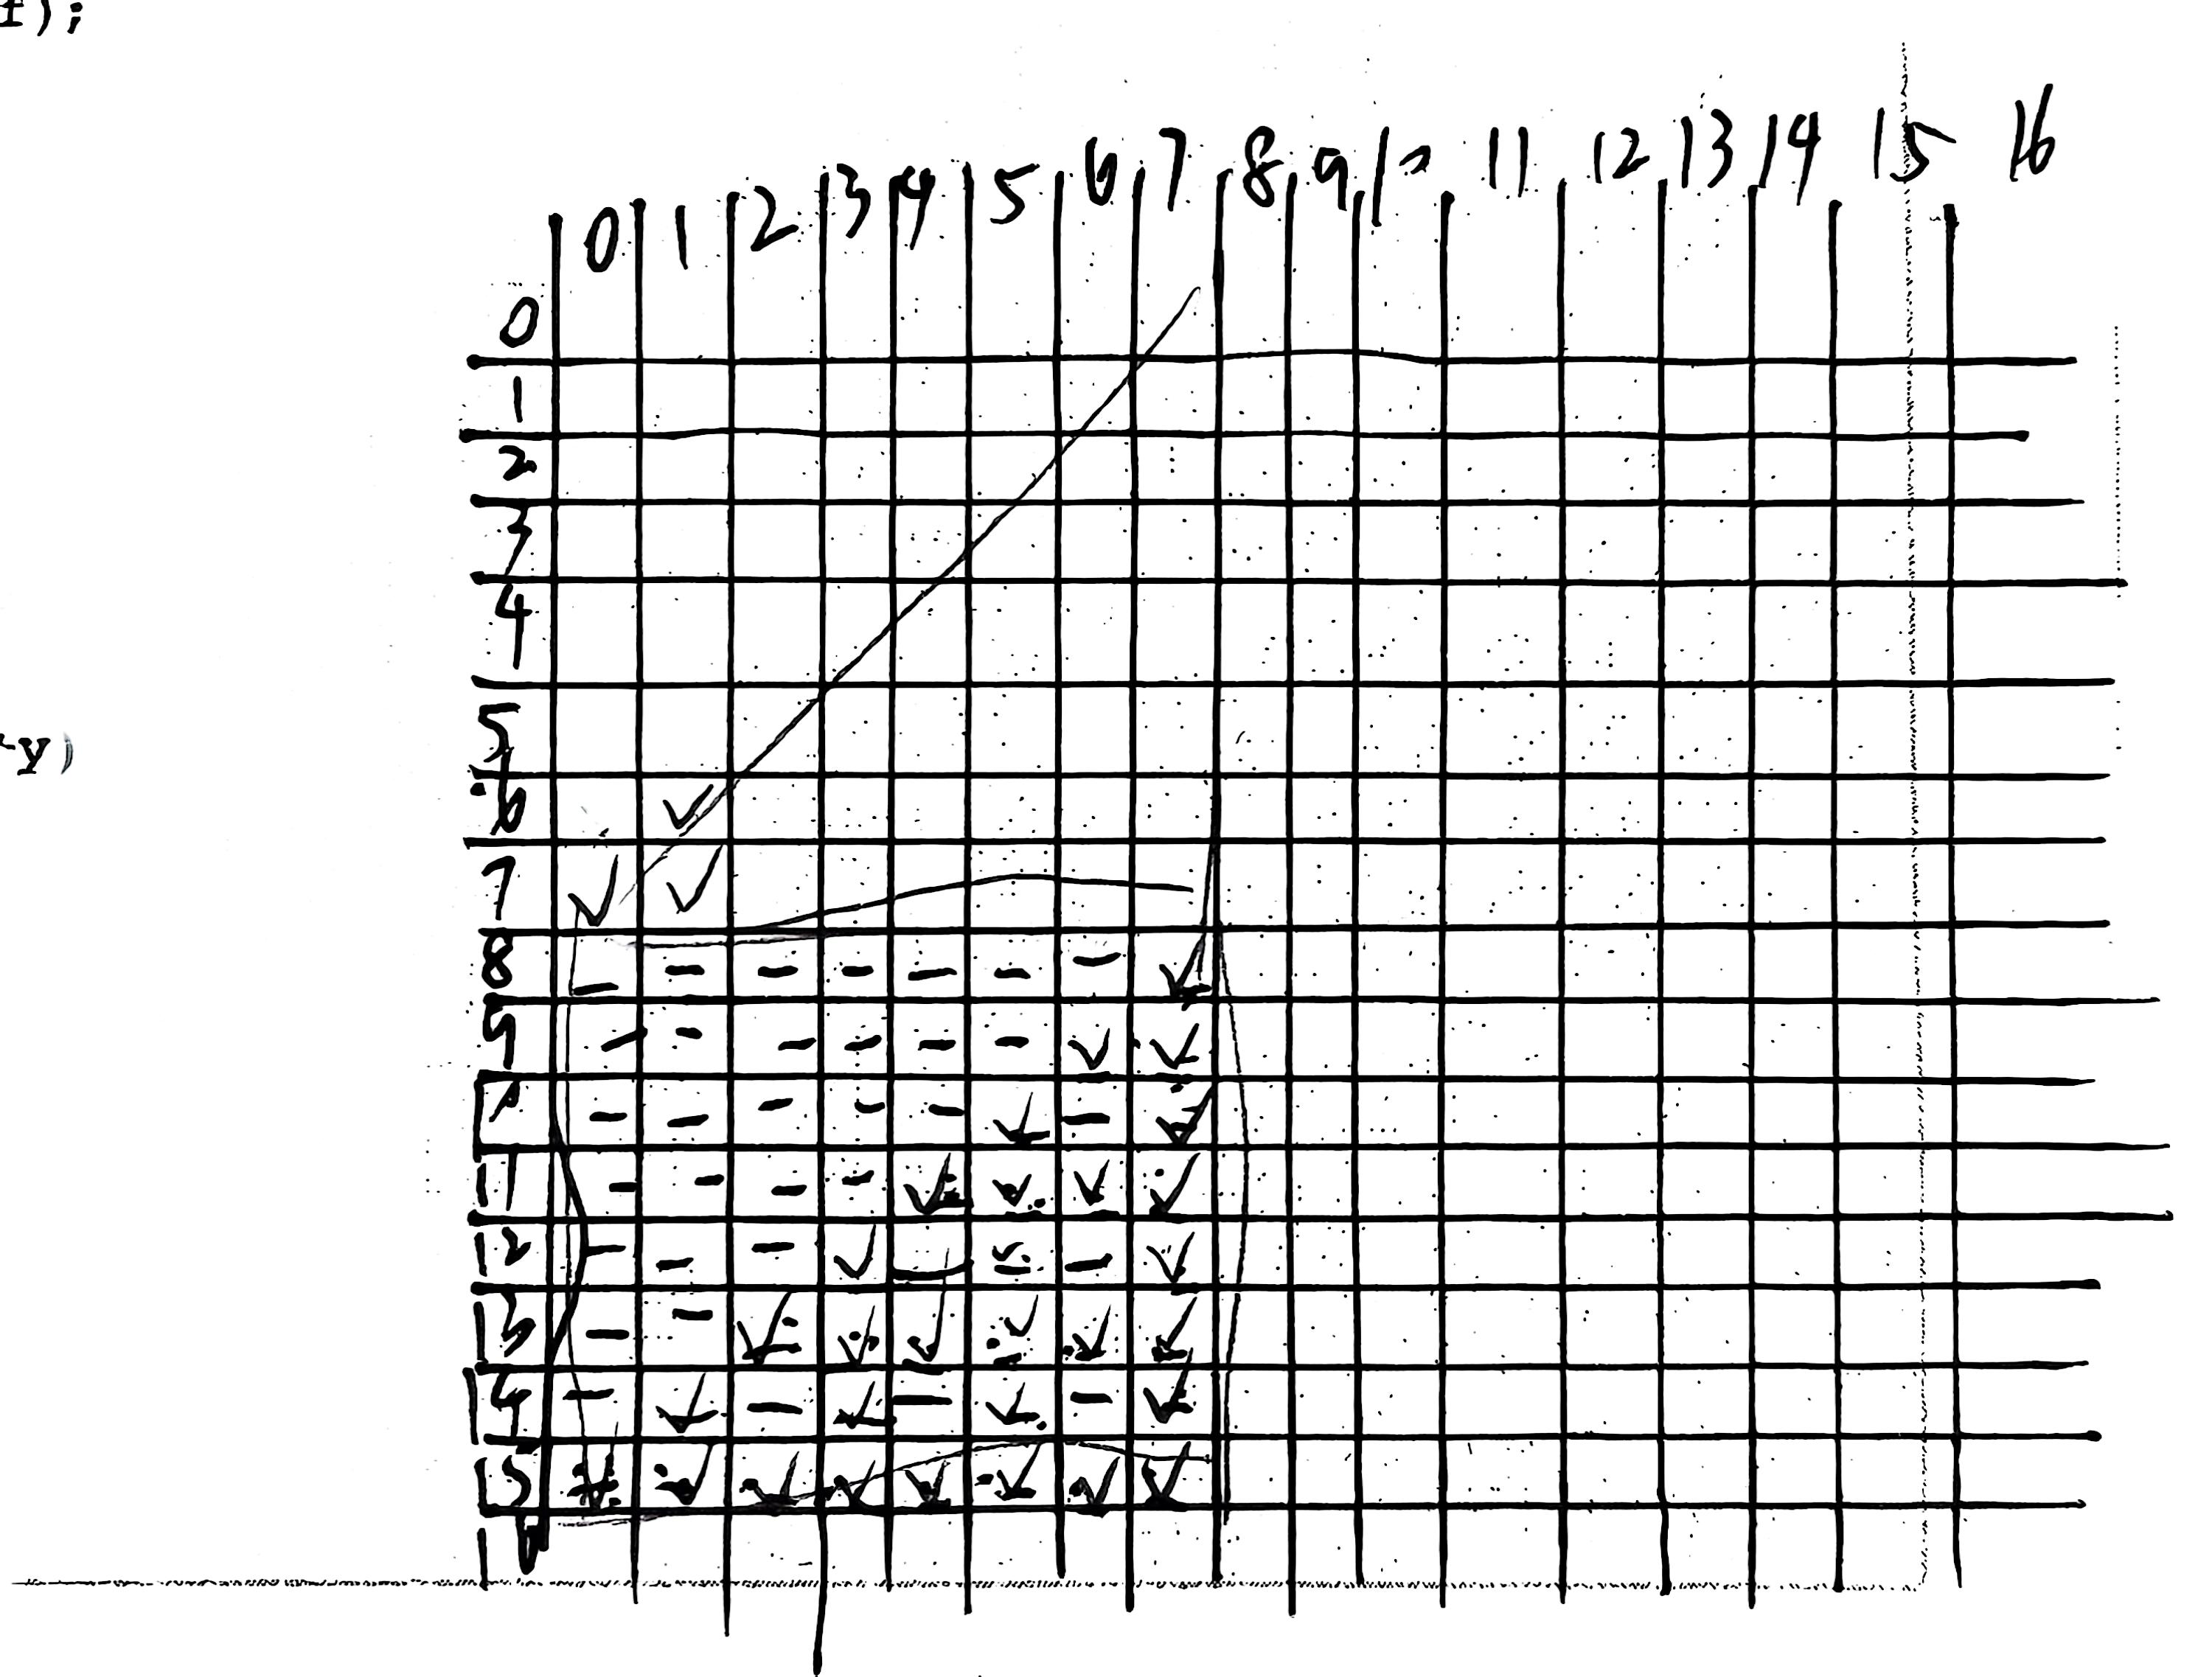
模拟图.jpg

然后也懒得模拟了

如果按照这样的规律下去,那么左上角四分之一区域是会被绘制的

也不懂

估计是我题目理解问题

T24

题目:print(n)的时间复杂度为( )

A $O(n)$
B $O(2^n)$
C $O(3^n)$
D $O(4^n)$

答案为D,考试我选了B

但是deepseek的观点是选C,所以,我们需要注意:[font color="#FF0000"]内容由 AI 生成,请仔细甄别[/font]

T27

题目:程序输出的图形,是沿( )对称图形

A 对角线
B 水平中轴
C 垂直中轴
D 中心镜像

考试我选择C,因为从上面那张目前模拟的地方,选C确实对于模拟没错

but

为什么错了???

也许是模拟错了吧

其实还有另外一张模拟了一张的草稿纸,但被我当作lese扔进垃圾桶了

第三大题

bool valid = true;
std::vector<int> adj[max_node];
bool instack[max_node] = {false};
bool visited[max_node] = {false};
void dfs(int node)
{
    instack[node] = true;
    visited[node] = true;
    for (auto after : adj[node]) {
        if (!visited[after]) {
            visited[after] = true;
            dfs(after);
        } else if (instack[after]) {
            valid = false;
        }
    }
    instack[node] = false;
}
int main()
{
    int n, m;
    std::cin >> n >> m;
    for (int i = 0; i < m; i++)
    {
        int x, y;
        std::cin >> x >> y;
        adj[x].push_back(y);
    }
    for (int i = 1; i <= n; i++)
    {
        if (!visited[i])
        {
            dfs(i);
        }
    }
    if (valid) {
        std::cout << "Valid\n";
    } else {
        std::cout << "Invalid\n";
    }
}

T34

题目:当输入节点数$n=10^5$,边数$m=2 \times 10^5$时,程序是否能高效运行( )

A 能,$O(n+m)$复杂度
B 不能,$O(nm)$复杂度
C 不能,递归栈溢出
D 取决于图的具体结构

说实话,我考试中都不知道这个代码在干什么,全都是瞎懵的,选择题全队,选择题错了一个,即这个,考试懵了C,因为不知道就选C

让我们的deepseek来分析这道题

???deepseek选C???

小声os:@deepseek: look in my eyes . tell me ? why ? why baby ? why ?

三 完善程序

第一大题

S了
但是让deepseek根据题目写代码

#include <iostream>
#include <vector>
using namespace std;

const int MAX_N = 1005;
const int MAX_M = 1005;

int main() {
    int n, N;
    cin >> n >> N;
    vector<string> P(N);
    for (int i = 0; i < N; ++i) {
        cin >> P[i];
    }
    int Q;
    cin >> Q;

    // 前缀和数组,sum_black[i][j] 表示从(0,0)到(i-1,j-1)的黑格数量
    vector<vector<int>> sum_black(n + 1, vector<int>(n + 1, 0));

    for (int i = 1; i <= n; ++i) {
        for (int j = 1; j <= n; ++j) {
            int pi = (i - 1) % N;
            int pj = (j - 1) % N;
            int black = (P[pi][pj] == 'B') ? 1 : 0;
            sum_black[i][j] = sum_black[i - 1][j] + sum_black[i][j - 1] - sum_black[i - 1][j - 1] + black;
        }
    }

    while (Q--) {
        int A, B, C, D;
        cin >> A >> B >> C >> D;
        // 计算矩形区域内的黑格数量,注意坐标从0开始,转换为前缀和的1-based索引
        int black_count = sum_black[C + 1][D + 1] - sum_black[A][D + 1] - sum_black[C + 1][B] + sum_black[A][B];
        cout << black_count << endl;
    }

    return 0;
}

也不知道对不对

第二大题

#include<iostream>
int len(int n) {
    int length = 0;
    while (n > 0) {
        n /= 10;
        length++;
    }
    return length;
}
void print(int n, char ch) {
    while (n-- > 0) std::cout << ch;
}
int main() {
    int a, b;
    char dummy;
    std::cin >> a >> dummy >> b;
    int p = a;
    int q = b;
    while (a != 0 and b != 0) {
        if (a >= b) a %= b;
        else b %= a;
    }
    int gcd;
    if (____(1)____) gcd = b;
    else gcd = a;
    int i = p / q;
    p %= q;
    p /= gcd;
    q /= gcd;
    if (____(2)____) {
        std::cout << i << "\n";
    } else {
        int i_len = len(i);
        int p_len = len(p);
        int q_len = len(q);
        ____(3)____;
        std::cout << ____(4)____ << "\n";
        if (i != 0) std::cout << i;
        ____(5)____;
        std::cout << "\n";
        ____(6)____;
        std::cout << ____(7)____ << "\n";
    }
}

T44

考试的时候眼瞎了,看错位置了,这个是要输出杠的

完

致谢