标签 CSP-J 下的文章

试题

上海市2025CSP-J十连测Round 7.pdf

大感

我们这一次并没有批分数,所以关于上海市2025CSP-J十连测Round 7的内容我们会分为$Part 1$和$Part 2$
这一次我估计很难

上海市2025CSP-J十连测Round 7 题干

一、单项选择题

共15题、每题2分,共计30分,每题有且仅有一个正确选项。

  1. 如果开始时计算机处于小写输入状态,现在有一只小老鼠反复按照CapsLock、字母键A、字母键S和字母键D的顺序循环按键,即CapsLock、A、S、D、CapsLock、A、S、D……则屏幕上输出的第2025个字符是字母()。
    A. A
    B. S
    C. D
    D. a
  2. 在8位二进制补码中,10101011表示的是十进制下的()。
    A. -85
    B. -43
    C. 43
    D. 85
  3. 给定一个含N个不相同数字的数组,在最坏情况下,找出其中最大或最小的数,至少需要$N-1$次比较操作。则最坏情况下,在该数组中同时找最大与最小的数至少需要()次比较操作。(「」表示向上取整,⌊⌋表示向下取整)
    A. $\left\lceil\frac{3N}{2}\right\rceil - 2$
    B. $\left\lfloor\frac{3N}{2}\right\rfloor - 2$
    C. $2N - 2$
    D. $2N - 4$
  4. 表达式$a*(b+c)-d$的后缀表达形式为()。
    A. $abc d*+-$
    B. $abc+*d-$
    C. $abc*+d-$
    D. $-+*abcd$
  5. 约定二叉树的根节点高度为1。一棵结点数为2025的二叉树最少有()个叶子结点;一棵结点数为2025的二叉树最小的高度值是()。
    A. 1,11
    B. 1,12
    C. 2,11
    D. 2,12
  6. 向一个栈顶指针为$hs$的链式栈中插入一个指针s指向的结点时,应执行()。
    A. $hs \to next = s;$
    B. $s \to next = hs; hs = s;$
    C. $s \to next = hs \to next; hs \to next = s;$
    D. $s \to next = hs; hs = hs \to next$
  7. 2-3树是满足两个条件的树:①所有叶结点到根的路径长度相同;②所有非叶子结点有两个或三个子结点。如果一棵2-3树有10个叶结点,那么它可能有()个非叶结点。
    A. 3
    B. 4
    C. 6
    D. 8
  8. 由四个没有区别的点构成的简单无向连通图的个数是()。
    A. 6
    B. 7
    C. 8
    D. 9
  9. 设含有10个元素的集合的全部子集数为S,其中由7个元素组成的子集数为T,则$\frac{T}{S}$的值()。
    A. $\frac{5}{32}$
    B. $\frac{15}{128}$
    C. $\frac{1}{8}$
    D. $\frac{21}{125}$
  10. 如下图所示,共有13个格子。对任何一个格子进行一次操作,会使得它自己以及与它上下左右相邻的格子中的数字改变(由1变0,或由0变1)。现在要使得所有的格子中的数字都变为0,至少需要()次操作。
    A. 3
    B. 4
    C. 5
    D. 6
  11. 一个1×8的方格图形(不可旋转)用黑、白两种颜色填涂每个方格。如果每个方格只能填涂一种颜色,且不允许两个黑格相邻,共有()种填涂方案。
    A. 8
    B. 55
    C. 56
    D. 64
  12. 设G是有n个结点、m条边($n \leq m$)的连通图,必须删去G的()条边,才能使得G变成一棵树。
    A. $m - n + 1$
    B. $m - n$
    C. $m + n + 1$
    D. $n - m + 1$
  13. 有7个一模一样的苹果,放到3个一样的盘子中,一共有()种放法。
    A. 7
    B. 8
    C. 21
    D. 2187
  14. 若$f_0 = 0$,$f_1 = 1$,$f_{n+1} = \frac{f_n + f_{n-1}}{2}$,则随着i的增大,$f_i$将接近于()。
    A. $\frac{1}{2}$
    B. $\frac{2}{3}$
    C. $\frac{\sqrt{5} - 1}{2}$
    D. 1
  15. 以下是32位机器和64位机器的区别是()。
    A. 显示器不同
    B. 硬盘大小不同
    C. 寻址空间不同
    D. 输入法不同

二、阅读程序

判断题1分,选择题3分,共计40分;判断题正确填T,错误填F。

第1题

int solve1(int n) {
    n++;
    int size = 0;
    int digit[16];
    int pow = 1;
    int s = 0;
    while (n > 0) {
        digit[size] = n % 10;
        size++;
        n /= 10;
        s += pow;
        pow *= 5;
    }
    while (size > 0) {
        --size;
        pow /= 5;
        s += (digit[size] / 2) * pow;
        if (digit[size] % 2 == 0) break;
    }
    return s - 1;
}

int solve2(int n) {
    int s = 0;
    for (int i = 1; i <= n; i += 2) {
        int t = i;
        bool pass = true;
        while (t > 0) {
            int x = t % 10;
            if (x % 2 == 0) {
                pass = false;
                break;
            }
            t /= 10;
        }
        if (pass) s++;
    }
    return s;
}

保证solve1与solve2的参数n是非负整数。

判断题

  1. solve1(11)的返回值为6()。
  2. solve2(12345)的返回值为906()。
  3. 对所有的$n > 0$,必有solve1(n) <= n()。
  4. solve1(0)的返回值为0()。

选择题

  1. 关于solve1(n)与solve2(n)的大小关系,当$n \geq 0$时,下列说法正确的是()。
    A. 必然有solve1(n) < solve2(n)
    B. 必然有solve1(n) == solve2(n)
    C. 只有当n为偶数时,才有solve1(n) = solve2(n)
    D. 只有当n为奇数时,才有solve1(n) == solve2(n)
  2. 若将solve1函数中第一句n++去掉,将solve2函数中for循环的i += 2改为i += 1,则新返回值与原来相比()。
    A. solve1不变,solve2变大
    B. solve1不变,solve2变小
    C. solve1变小,solve2不变
    D. solve1变大,solve2不变
  3. solve1(n)与solve2(n)的时间复杂度为()。
    A. $\Theta(logn)$、$\Theta(logn^2)$
    B. $\Theta(logn)$、$\Theta(n)$
    C. $\Theta(logn)$、$\Theta(nlogn)$
    D. $\Theta(n)$、$\Theta(n^2)$

第2题

int a[maxn];
int b[maxn];
int n, m;
const long long mod = 1000000007;
bool filled[maxn][maxn];
long long mem[maxn][maxn];

long long solve(int i, int j) {
    if (filled[i][j]) return mem[i][j];
    if (i == n) return 1;
    if (j == m) return 1;
    filled[i][j] = true;
    if (a[i] == b[j]) {
        long long sum = solve(i + 1, j) + solve(i, j + 1);
        return mem[i][j] = sum % mod;
    } else {
        return mem[i][j] = (solve(i + 1, j) - solve(i + 1, j + 1)) % mod;
    }
}

int main() {
    std::cin >> n >> m;
    for (int i = 0; i < n; ++i) std::cin >> a[i];
    for (int i = 0; i < m; ++i) std::cin >> b[i];
    std::cout << (solve(0, 0) + mod) % mod << "\n";
}

判断题

  1. 若依次输入数据2 2 1 3 3 1,程序返回的结果是3()。
  2. 如果$n = 0$或$m = 0$,程序返回的结果是1()。
  3. 如果两个序列完全相同,程序返回的结果是$2^n$()。
  4. 输出时,执行solve(0,0)+mod是多余的运算()。

选择题

  1. 该程序的主要功能是()。
    A. 计算两个序列的最长公共子序列的长度
    B. 计算两个序列的公共子序列的数量
    C. 计算两个序列的公共子串的数量
    D. 计算两个序列的相同元素个数
  2. 该程序的时间复杂度为()。
    A. $\Theta(n + m)$
    B. $\Theta(n \cdot m)$
    C. $\Theta(2^{m + n})$
    D. $\Theta(nlogm)$
  3. 当$a[i] = b[j]$时,返回值需要减去solve(i+1,j+1)的原因是()。
    A. 排除重复情况
    B. 排除错误情况
    C. 优化程序的空间效率
    D. 优化程序的时间效率

第3题

long long k;
int n;
int p[20];
bool used[20] = {false};
long long frac[20];

void gen(int i) {
    if (i > n) {
        for (int i = 1; i <= n; ++i) std::cout << p[i] << " ";
        return;
    }
    for (int a = 1; a <= n; ++a) if (!used[a]) {
        if (k <= frac[n - i]) {
            p[i] = a;
            used[a] = true;
            gen(i + 1);
            return;
        } else {
            k -= frac[n - i];
        }
    }
}

int main() {
    n = 1;
    std::cin >> k;
    frac[0] = frac[1] = 1;
    while (k > frac[n]) {
        k -= frac[n];
        frac[n + 1] = frac[n] * (n + 1);
        n++;
    }
    gen(1);
}

判断题

  1. 当输入k为1时候,输出1()。
  2. 当输入k为1000时候,输出1 5 2 4 3()。

选择题

  1. 关于程序输出的序列所满足的性质,错误的是()。
    A. 输出的每个数字各不相同
    B. 输出的数字都在1到n之间
    C. 输出的相邻的数字差距不会超过1
    D. 最先输出的数字在程序中是最先被确定的
  2. 下列说法正确的是()。
    A. 越大的k一定会输出越长的序列
    B. k若是奇数,输出序列的长度一定也是奇数
    C. 程序的时间复杂度为(k!)
    D. gen递归是树形递归
  3. 若程序输出的第一个数字为2,第二数字为4,剩下还有三个数字,则输入的k()。
    A. 最小值是60,最大值是65
    B. 最小值是65,最大值是70
    C. 最小值是70,最大值是75
    D. 最小值是75,最大值是80
  4. 如果使得输出序列出现7,则输入k最少需要()。
    A. 343
    B. 874
    C. 2170
    D. 5040

三、完善程序

单选题,每小题3分,共计30分。

第1题

有一个用户,在连续的n天里,都会收到积分,也会消费积分。积分在获得后的m天内有效(m为一个给定的整数),过期失效。在第i天,用户将会获得$p_i$分,他需要消费$c_i$分。若积分不足,则用掉全部积分后用其他方式消费。消费积分时,先用最早的。当天获取的积分可以当天消费。请计算这个用户一共消费了多少积分。

const int max_size = 100000;
int queue[max_size];
int head = 0;
int tail = 0;

int main() {
    int n, m;
    std::cin >> n >> m;
    int sum = 0;
    for (int i = 0; i < n; ++i) {
        int p, c;
        std::cin >> p >> c;
        queue[_(1)_] = p;
        while (_(2)_) {
            if (_(3)_) {
                queue[head] -= c;
                sum += c;
                c = 0;
            } else {
                int amount = _(4)_;
                c -= amount;
                sum += amount;
            }
        }
        if (_(5)_ > m) {
            head++;
        }
        std::cout << sum << "\n";
    }
}
  1. (1)处应填()。
    A. tail
    B. tail + 1
    C. i + head
    D. tail++
  2. (2)处应填()。
    A. head < tail || c > 0
    B. head < tail || p > 0
    C. head < tail && c > 0
    D. head < tail && p > 0
  3. (3)处应填()。
    A. queue[head] > c
    B. queue[tail] > c
    C. queue[head + 1] > c
    D. queue[tail - 1] > c
  4. (4)处应填()。
    A. queue[head++]
    B. queue[head]
    C. queue[tail--]
    D. queue[tail]
  5. (5)处应填()。
    A. head - tail
    B. tail - head
    C. tail + head
    D. i - head + 1

第2题

给定一个1到n的排列$p_1, p_2, ..., p_n$。请统计排列中所有长度大于等于2的连续子序列的次大数之和。定义$max_2(a_i, a_{i+1}, ..., a_j)$表示从$a_i$开始到$a_j$结束的连续子序列中,排名第二大的数,这个数就是一个连续子序列的次大数之和。题目就是要求:$\sum_{1 \leq i < j \leq n} max_2(a_i, a_{i+1}, ..., a_j)$。solve用于解决这个问题。

int q[maxn];
int prev[maxn];
int next[maxn];

long long solve(int n, int p[]) {
    for (int i = 1; i <= n; ++i) {
        _(1)_;
    }
    p[0] = q[0] = prev[0] = 0;
    p[n + 1] = q[n + 1] = next[n + 1] = n + 1;
    for (int i = 1; i <= n; ++i) {
        int num = _(2)_;
        int prev_num = p[i - 1];
        int next_num = p[i + 1];
        prev[num] = _(3)_;
        next[num] = _(4)_;
    }
    long long sum = 0;
    for (int num = 1; num <= n; ++num) {
        int prev_num = prev[num];
        int prev_prev_num = prev[prev_num];
        int next_num = next[num];
        int next_next_num = next[next_num];
        sum += (long long)num * (q[num] - q[prev_num]) * _(5)_;
        sum += (long long)num * (q[next_num] - q[num]) * _(6)_;
        _(7)_ = prev_num;
        _(8)_ = next_num;
    }
    return sum;
}
  1. (1)处应填()。
    A. $q[p[i]] = i$
    B. $q[i] = p[i]$
    C. $q[i] = i$
    D. $q[p[i]] = p[i]$
  2. (2)(3)(4)处应填()。
    A. p[i],prev_num,next_num
    B. q[i],next_num,prev_num
    C. p[i],next_num,prev_num
    D. q[i],prev_num,next_num
  3. (5)处应填()。
    A. (q[prev_num] - q[prev_prev_num])
    B. (q[next_next_num] - q[prev_num])
    C. (q[next_num] - q[prev_prev_num])
    D. (q[next_next_num] - q[next_num])
  4. (6)处应填()。
    A. (q[prev_num] - q[prev_prev_num])
    B. (q[next_next_num] - q[prev_num])
    C. (q[next_num] - q[prev_prev_num])
    D. (q[next_next_num] - q[next_num])
  5. (7)(8)处应填()。
    A. prev[prev_num],next[next_num]
    B. prev[next_num],next[prev_num]
    C. next[prev_num],prev[next_num]
    D. next[next_num],prev[prev_num]
试题

2023CSP-J.pdf

大感

说实话,我当时参加2023CSP-J还是五年级吧?当时只考了65分,这次再考,考了78.5分,分数线是72分(浙江)

错题大纲

一 单项选择

T6

小明在某一天中依次有七个空闲时间段,他想要选出至少一个空闲时间段来练习唱歌,但他希望任意两个练习的时间段之间都有至少两个空闲的时间段让他休息。则小明一共有( )种选择时间段的方案
A:31
B:18
C:21
D:33

这道题,是一道经典的排列组合题
这实际上是一个组合问题,但带有约束:选取的子集中任意两个元素至少相差3
我们可以考虑用递推或组合计数的方法。这里我们采用递推(动态规划)的方法来计数所有非空子集满足约束的方案数
定义:
令 $a_n$​ 表示在n个时间段中,选择至少一个时间段满足任意两个被选的时间段之间至少间隔2个(即索引差至少为3)的总方案数
注意:问题要求“至少一个”,即非空子集
实际上,我们可以先计算所有满足约束的子集(包括空集)的数量,然后减去1(空集)即可
设$f(n)$为在n个时间段中,满足任意两个被选时间段索引差至少为3的子集个数(包括空集)
考虑第n个时间段是否被选:

  • 如果不选第n个,那么方案数就是前n-1个的满足约束的子集数:$f(n−1)$
  • 如果选第n个,那么第n-1和n-2个都不能被选(因为要求至少间隔两个),所以前n-3个可以任意选(满足约束),因此方案数为 $f(n−3)$(注意:这里f包括空集,所以当n<3时需要小心)

因此,递推式子为:
$f(n)=f(n−1)+f(n−3)对于n≥3$
经过计算,非空为18
则答案为B

T8

后缀表达式6 2 3 + - 3 8 2 / + * 2 ^ 3 +对应的中缀表达式为( )
A ( ( 6 - ( 2 + 3 ) ) * ( 3 + 8 / 2 ) ) ^ 2 + 3
B 6 - 2 + 3 * 3 + 8 / 2 ^ 2 + 3
C ( 6 - ( 2 + 3 ) ) * ( ( 3 + 8 / 2 ) ^ 2 ) + 3
D 6 - ( ( 2 + 3 ) * ( 3 + 8 / 2 ) ) ^ 2 + 3

这种题,有一种很好的方法,就是加括号,然后移符号
例如下面这个中缀表达式
3 + 8 / 2
先给运算加括号
( 3 + ( 8 / 2 ) )
然后将符号移动到当前括号的最右侧(后缀表达式)
3 8 2 / +
记得删括号

所以,这道题先加括号,再转运算符后是
6 2 3 + - 3 8 2 / + * 2 ^ 3 +
选A

T10

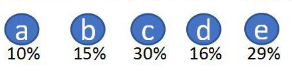
假设有一组字符${a,b,c,d,e,f}$,对应的频率分别为$5%,9%,12%,13%,16%,45%$。请问以下哪个选项是字符$a,b,c,d,e,f$分别对应的一组哈夫曼编码?( )
A 1111 1110 101 100 110 0
B 1010 1001 1000 011 010 00
C 000 001 010 011 10 11
D 1010 1011 110 111 00 01

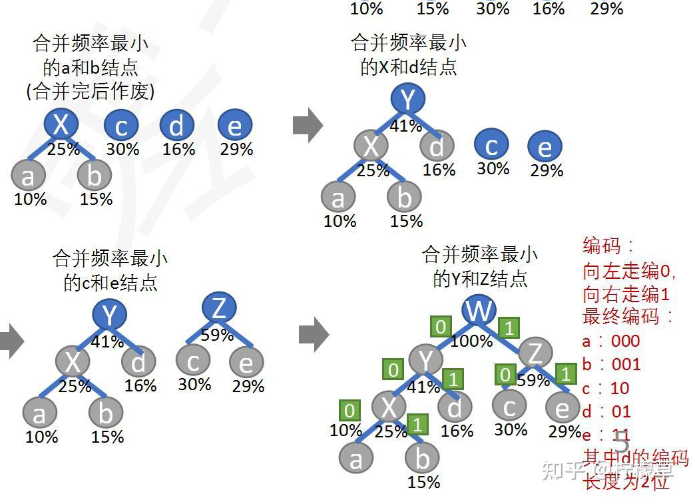
哈夫曼编码的原理是:让频率小的字母编码长度长,频率大的字母编码长度短,因此达到文章总体编码长度更短的效果,具体过程如下,但不是题目样例
image.png
image.png

T14

一个班级有10个男生和12个女生。如果要选出一个3人的小组,并且小组中必须至少包含一个女生,那么有多少种可能的组合?( )
A 1420
B 1770
C 1540
D 2200

根据题意,列出:
总共有22人(10男 + 12女),选出3人的总组合数:$C(22, 3) = \frac{22 \times 21 \times 20}{3 \times 2 \times 1} = 1540$
小组中没有任何女生(即全为男生)的组合数:$C(10, 3) = \frac{10 \times 9 \times 8}{3 \times 2 \times 1} = 120$
因此,至少包含一个女生的组合数:$\text{总组合数} - \text{全男生的组合数} = 1540 - 120 = 1420$
所以,选A

二 阅读程序

第一大题

#include <iostream>
#include <cmath>
using namespace std;

double f(double a, double b, double c) {
    double s = (a + b + c) / 2;
    return sqrt(s * (s - a) * (s - b) * (s - c));
}

int main() {
    cout.flags(ios::fixed);
    cout.precision(4);

    int a, b, c;
    cin >> a >> b >> c;
    cout << f(a, b, c) << endl;
    return 0;
}

第二大题

#include <iostream>
#include <vector>
#include <algorithm>
using namespace std;

int f(string x, string y) {
    int m = x.size();
    int n = y.size();
    vector<vector<int>> v(m + 1, vector<int>(n + 1, 0));
    for (int i = 1; i <= m; i++) {
        for (int j = 1; j <= n; j++) {
            if (x[i - 1] == y[j - 1]) {
                v[i][j] = v[i - 1][j - 1] + 1;
            } else {
                v[i][j] = max(v[i - 1][j], v[i][j - 1]);
            }
        }
    }
    return v[m][n];
}

bool g(string x, string y) {
    if (x.size() != y.size()) {
        return false;
    }
    return f(x + x, y) == y.size();
}

int main() {
    string x, y;
    cin >> x >> y;
    cout << g(x, y) << endl;
    return 0;
}

这题是LCS

第三大题

#include <iostream>
#include <cmath>
using namespace std;

int solve1(int n) {
    return n * n;
}

int solve2(int n) {
    int sum = 0;
    for (int i = 1; i <= sqrt(n); i++) {
        if (n % i == 0) {
            if (n / i == i) {
                sum += i * i;
            } else {
                sum += i * i + (n / i) * (n / i);
            }
        }
    }
    return sum;
}

int main() {
    int n;
    cin >> n;
    cout << solve2(solve1(n)) << " " << solve1(solve2(n)) << endl;
    return 0;
}

三 完善程序

第一大题

(寻找被移除的元素)问题:原有长度为n+1、公差为1的等差升序数列;将数列输入到程序的数组时移除了一个元素,导致长度为n的升序数组可能不再连续,除非被移除的是第一个或最后一个元素。需要在数组不连续时,找出被移除的元素
试补全程序

#include <iostream>
#include <vector>

using namespace std;

int find_missing(vector<int>& nums) {
    int left = 0, right = nums.size() - 1;
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] == mid + ①) {
            ②
        } else {
            ③
        }
    }
    return ④;
}

int main() {
    int n;
    cin >> n;
    vector<int> nums(n);
    for(int i = 0; i < n; i++)cin >> nums[i];
    int missing_number = find_missing(nums);
    if (missing_number == ⑤) {
        cout << "Sequence is consecutive" << endl;
    } else {
        cout << "Missing number is " << missing_number << endl;
    }
    return 0;
}

T33

选B,
为什么不选A?
因为题目说了,除非被移除的是第一个或最后一个元素,则代表输入的第一个数可能不是1,所以需要用num[0]

T35

选C,自行模拟

第二大题

​(编辑距离)​给定两个字符串,每次操作可以选择删除Delete、 插入insert、替换Replace个字符,求将第一个字符串转换为第二个字符串所需要的最少操作次数

试 补 全 动 态 规 划 算 法

#include <iostream>
#include <string>
#include <vector>
using namespace std;

int min(int x, int y, int z) {
    return min(min(x, y), z);
}

int edit_dist_dp(string str1, string str2) {
    int m = str1.length();
    int n = str2.length();
    vector<vector<int>> dp(m + 1, vector<int>(n + 1));

    for (int i = 0; i <= m; i++) {
        for (int j = 0; j <= n; j++) {
            if (i == 0)
                dp[i][j] = ①;
            else if (j == 0)
                dp[i][j] = ②;
            else if (③)
                dp[i][j] = ④;
            else
                dp[i][j] = 1 + min(dp[i][j - 1], dp[i - 1][j], ⑤);
        }
    }
    return dp[m][n];
}

int main() {
    string str1, str2;
    cin >> str1 >> str2;
    cout << "Mininum number of operation:"
         << edit_dist_dp(str1, str2) << endl;
    return 0;
}

T40

选A
image.png

完

致谢

题目

上海市2025CSP-J十连测Round 6.pdf

大感

难度感觉很难,我只有69分,全班排No 3的状态

错题大纲

一 单项选择(错4题)

T4

如果对一个已经升序的数组进行排序,下列算法中可能花费时间反而比乱序数组多的是( )

A.堆排序
B.插入排序
C.冒泡排序
D.快速排序

先来一张统计表

排序算法平均时间复杂度最优时间复杂度最坏时间复杂度备注
A. 堆排序$O(n log n)$$O(n log n)$$O(n log n)$不稳定排序
B. 插入排序$O(n²)$$O(n)$$O(n²)$稳定排序,对小数据集高效
C. 冒泡排序$O(n²)$$O(n)$$O(n²)$稳定排序,效率较低
D. 快速排序$O(n log n)$$O(n log n)$$O(n²)$不稳定排序,平均性能最好

答案为D

原因如下:快速排序依赖于基准,如果数组已经有序,且选择第一个或最后一个元素作为基准(常见实现方式),则每次划分都会极度不平衡(因为基准是当前子数组的最小或最大值),导致递归深度达到最大($O(n)$),并且每次划分只能减少一个元素。因此,最坏时间复杂度为​$O(n²)​$,比乱序数组的平均情况($O(n log n)$)要慢得多

例如:
初始数组:[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

第一次排序(以 1 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [2, 3, 4, 5, 6, 7, 8, 9, 10] 排序(以 2 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [3, 4, 5, 6, 7, 8, 9, 10] 排序(以 3 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [4, 5, 6, 7, 8, 9, 10] 排序(以 4 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [5, 6, 7, 8, 9, 10] 排序(以 5 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [6, 7, 8, 9, 10] 排序(以 6 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [7, 8, 9, 10] 排序(以 7 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [8, 9, 10] 排序(以 8 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [9, 10] 排序(以 9 为基准):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

对右半部分 [10] 排序(只有一个元素,无需排序):
[1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

代码实现:

#include <iostream>
using namespace std;

// 划分函数,返回基准位置
int partition(int arr[], int low, int high) {
    int pivot = arr[low];  // 选择第一个元素为基准
    int i = low, j = high;
    while (i < j) {
        while (i < j && arr[j] >= pivot) j--; // 从右找小于基准的
        while (i < j && arr[i] <= pivot) i++; // 从左找大于基准的
        if (i < j) swap(arr[i], arr[j]);
    }
    swap(arr[low], arr[i]); // 将基准放到正确位置
    return i;
}

// 快速排序递归函数
void quickSort(int arr[], int low, int high) {
    if (low < high) {
        int pi = partition(arr, low, high); // 划分
        quickSort(arr, low, pi - 1);  // 排序左半
        quickSort(arr, pi + 1, high); // 排序右半
    }
}

// 打印数组
void printArray(int arr[], int n) {
    for (int i = 0; i < n; i++)
        cout << arr[i] << " ";
    cout << endl;
}

int main() {
    int arr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10}; // 待排序
    int n = sizeof(arr) / sizeof(arr[0]);
    
    printArray(arr, n);
    
    quickSort(arr, 0, n - 1);
    
    printArray(arr, n);
    
    return 0;
}

T6

题目:设一个栈与一个队列的初始状态均为空。元素 1、2、3、4、5、6依次进入栈,且每个元素出栈后即进入队列,若出队的顺序为2、4、3、6、5、1,则栈的容量至少应该为( )。

A 2
B 3
C 4
D 5

答案为B,模拟过程如下:

1入栈,容量为1
2入栈,容量为2
2出栈,容量为1
3入栈,容量为2
4入栈,容量为3
4出栈,容量为2
3出栈,容量为1
5入栈,容量为2
6入栈,容量为3
6出栈,容量为2
5出栈,容量为1
1出栈,容量为0

期间最大容量为3,所以栈容量至少为3

T7

题目:整型数组a中有n个元素,能计算a中有多少个数字大于lower且小于upper的函数,应该将下划线依次替换为( )

int solve(int a[], int n, int lower, int upper)
{
    std::sort(a, a + n);
    auto begin = std::_____(a, a + n, lower);
    auto end = std::_____(a, a + n, upper);
    return end - begin;
}
A lower_bound、lower_bound
B lower_bound、upper_bound
C upper_bound、lower_bound
D upper_bound、upper_bound

答案为B

原因:

先说好,lb和up是C++的STL容器

  • lower_bound:返回指向第一个大于或等于目标值的元素的迭代器
  • upper_bound:返回指向第一个大于目标值的元素的迭代器

T11

题目:设有一个含有13个元素的哈希表(0 12),哈希函数是H(key)=key%13。用线性探查法解决冲突,则对于序列{2,8,31,20,19,18,53,27},18应放在下标为( )的位置

A 0
B 4
C 5
D 9

答案为D
核心规则回顾

  1. 哈希函数:H(key) = key % 13,计算元素的初始哈希位置。
  2. 线性探查法:若初始位置已被占用,依次检查下一个位置(下标+1,超过12则循环到0),直到找到空位置。
  3. 哈希表下标范围:0~12,共13个位置。
    逐元素计算存储位置(重点跟踪18)

1. 元素2

  • 初始哈希位置:H(2) = 2 % 13 = 2
  • 位置2为空,存储2 → 哈希表:[空, 空, 2, 空, 空, 空, 空, 空, 空, 空, 空, 空, 空]

2. 元素8

  • 初始哈希位置:H(8) = 8 % 13 = 8
  • 位置8为空,存储8 → 哈希表:[空, 空, 2, 空, 空, 空, 空, 空, 8, 空, 空, 空, 空]

3. 元素31

  • 初始哈希位置:H(31) = 31 % 13 = 5(13×2=26,31-26=5)
  • 位置5为空,存储31 → 哈希表:[空, 空, 2, 空, 空, 31, 空, 空, 8, 空, 空, 空, 空]

4. 元素20

  • 初始哈希位置:H(20) = 20 % 13 = 7(13×1=13,20-13=7)
  • 位置7为空,存储20 → 哈希表:[空, 空, 2, 空, 空, 31, 空, 20, 8, 空, 空, 空, 空]

5. 元素19

  • 初始哈希位置:H(19) = 19 % 13 = 6(13×1=13,19-13=6)
  • 位置6为空,存储19 → 哈希表:[空, 空, 2, 空, 空, 31, 19, 20, 8, 空, 空, 空, 空]

6. 元素18(目标元素)

  • 初始哈希位置:H(18) = 18 % 13 = 5(13×1=13,18-13=5)
  • 冲突:位置5已存储31,按线性探查检查下一个位置6;
  • 再次冲突:位置6已存储19,继续检查下一个位置7;
  • 再次冲突:位置7已存储20,继续检查下一个位置8;
  • 再次冲突:位置8已存储8,继续检查下一个位置9;
  • 位置9为空,存储18 → 18的最终下标为9。

(后续元素验证,不影响18的结果)

  • 元素53:H(53)=53%13=1(13×4=52,53-52=1),位置1为空,存储53。
  • 元素27:H(27)=27%13=1,位置1已存53,探查位置2(存2)→ 位置3(空),存储27。

结论

18应放在下标为 9 的位置,答案选 D。

二 阅读程序

第一大题

int solve1(int n)
{
    int s = 0;
    for (int i = 1; i <= n; ++i) {
        int f = 1;
        for (int j = i; j >= 1; --j) {
            f = f * j;
        }
        s = s + f;
    }
    return s;
}

int solve2(int n)
{
    int s = 0;
    for (int i = n; i >= 1; --i)
    {
        s = s + 1;
        s = s * i;
    }
    return s;
}

第二大题

bool move(int b[], int n)
{
    for (int i = 0; i < n; ++i) {
        if (b[i] == 1) {
            b[i] = 0;
        } else {
            b[i] = 1;
            return true;
        }
    }
    return false;
}

void print(int n)
{
    int b[n];
    for (int i = 0; i < n; ++i) b[i] = 0;
    do {
        for (int i = 0; i < n; ++i) std::cout << b[i];
        std::cout << "\n";
    } while (move(b, n));
}

int count(int n)
{
    int b[n];
    for (int i = 0; i < n; ++i) b[i] = 0;
    int c = 0;
    do {
        c++;
    } while (move(b, n));
    return c;
}

T22

题目:print输出的0与1必然一样多

什么是必然?
必定这样。必然是指客观事物联系和发展的合乎规律的、确定不移的趋势,是在一定条件下的不可避免性和确定性。

所以,√

模拟即可

T27

题目:以下说法错误的是( )

A.print(n)前一半输出全是偶数,后一半输出全是奇数
B.若将print(n)输出的每行内容看成一个数字,则他们是依次递增的
C.print(n)输出的每一行内容都是不同的
D.print(n)输出的每一列内容都是不同的

选B

不是依次递增

是有位数为int n的二进制,但是倒着的,也就是说,如果调用print(2),则模拟过程如下:

0 0
1 0
0 1
1 1
0 0

把他旋转一下:

0 0 》0
0 1 》1
1 0 》2
1 1 》3
0 0 》0

所以本题选B

第三大题

struct flat_map {
    struct {
        int key;
        int value;
    } bucket[65536];
    int size = 0;

    struct result {
        int index;
        bool hit;
    };

    result find(int begin, int end, int key) {
        if (begin == end)
            return {begin, false};
        else {
            int mid = begin + (end - begin) / 2;
            if (key < bucket[mid].key)
                return find(begin, mid, key);
            else if (bucket[mid].key < key)
                return find(mid + 1, end, key);
            else
                return {mid, true};
        }
    }

    int get(int key) {
        result p = find(0, size, key);
        if (p.hit)
            return bucket[p.index].value;
        else
            return 0;
    }

    void put(int key, int value) {
        result p = find(0, size, key);
        for (int i = size; i > p.index; --i) {
            bucket[i] = bucket[i - 1];
        }
        size++;
        bucket[p.index].key = key;
        bucket[p.index].value = value;
    }
};

T30

题目:若数组bucket的下标在[b,e)范围内存在键k,find(b,e,k)函数返回的hit为false

答案为×

find 函数通过二分查找,在数组 bucket 的区间 [b, e) 内查找键 k:

  • 如果找到键 k,返回 {索引, true}(hit = true)。
  • 如果没找到键 k,返回 {应该插入的位置, false}(hit = false)。

找到hit后是true,所以说法错误

T32

题目:记$s$表示容器的大小size,调用get(key)的最坏时间复杂度为( )

A $O(s)$
B $O(log s)$
C $O(s log s)$
D $O(s^2)$

根据题意,选B

log 通常指的是以 2 为底的对数(log₂)

T35

题目:若调用put(k,v)时已经存在相同的键k时,以下哪一种处理策略最符合上述代码的逻辑( )

A. 熔断 (Breaker):掷出异常,向系统报告错误
B. 回滚 (Rollback):不做任何修改,撤销put操作
C. 覆盖 (Rewrite):将键所对应的老值覆盖成新值
D. 忽略 (lgnore):对有可能出错的操作置之不理

答案为D,程序没有做特别的判断

三 完善程序

第一大题

给定含有n个顶点的有向完全图(顶点编号为$0$到$n-1$)。顶点$x$到$y$的边的权重为g[x][y]了。
请找出一条不重复经过任何点的路径,从顶点$0$出发到顶点$n-1$结束,路径上所有边的权重的异或值尽可能大。

int n, m;
long long g[MAXN][MAXN];
bool visited[MAXN] = {false};

int dfs(int node, int path) {
    if (____(1)____)
    {
        return ____(2)____;
    }

    int best = 0;
    visited[node] = true;
    for (int next = 0; next < ____(3)____; ++next)
    {
        if (____(4)____)
        {
            best = std::max(best, ____(5)____);
        }
    }
    visited[____(6)____] = ____(7)____;
}

int solve()
{
    return ____(8)____;
}

T40

node为节点,path为id

所以选A

第二大题

$n$个岛屿由$n$座桥连成环。岛的编号为$0$到$n-1$
,第$i$座桥连第$i$号岛屿第$(i+1) mod n$号岛
某旅行团从第$x_1$号岛出发,依次访问的岛编号为$x_2,...,x_m$
请选择拆掉一座桥,使得旅行团的过桥次数达到最小,令solve函数返回这个最小值

int solve(int n, int m, int x[])
{
    int diff[n];

    for (int i = 0; i < n; ++i) diff[i] = 0;
    int base = 0;
    for (int i = 1; i < m; ++i)
    {
        int prev = x[i - 1];
        int next = x[i];
        int begin, end;
        if (prev < next) {
            begin = prev;
            end = next;
        }
        else {
            begin = next;
            end = prev;
        }

        base += ____(1)____;
        int inc = ____(2)____ ;
        diff[____(3)____] += inc;
        diff[____(4)____] -= inc;
        prev = next;
    }
    int best = n * m;
    int sum = 0;
    for (int i = 0; i < n; ++i)
    {
        ____(5)____;
        if (best > sum) best = sum;
    }
    return ____(6)____;
}

T42

联系上下文即可

T44

联系上下文即可

T45

联系上下文即可

完

致谢

题目

上海市2025CSP-J十连测Round 5

大感

难度感觉还好,我这次也是拿到了80分的成绩,试卷打印的时候少了第一道完善程序,所以这份试卷的第一道完善程序作废,不得分

错题大纲

一 单项选择

T6

题目:设某算法的计算时间表示为递推关系式$ T(n)=T(n-1)+n $,$ n $为正整数,$ T(0) = 1$则该算法的时间复杂度为( )

A $ O(logn) $
B $ O(nlogn) $
C $ O(n) $
D $ O(n^2)$

这道题,我当时是模拟了一下,模拟的结果是这样的:

T(5)=T(4)+5
T(4)=T(3)+4
T(3)=T(2)+3
T(2)=T(1)+2
T(1)=0

此时,$n$为5,一共做了5次的$T(n)$,则时间复杂度为$O(n)$

但是错了

我估摸着是答案写错了

然后,我们邀请AI:

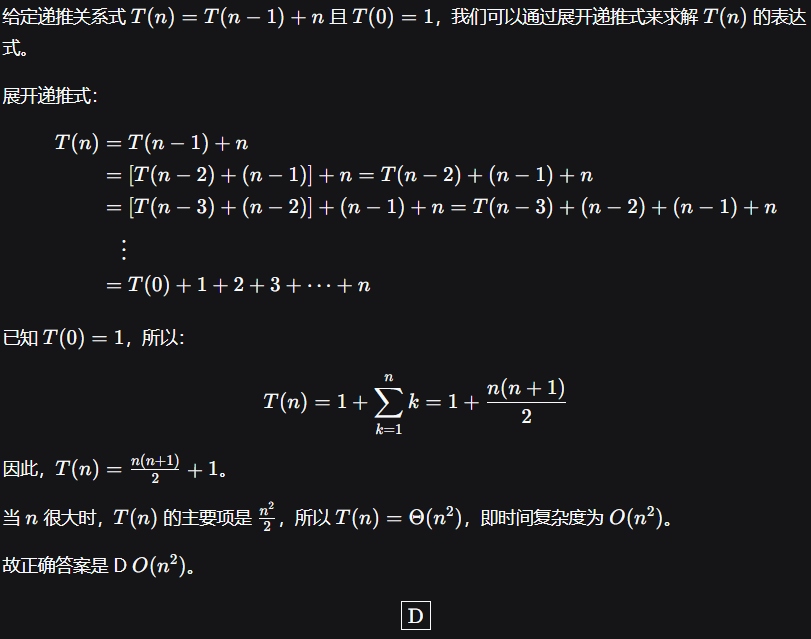
image.png

给定递推关系式 (T ( n )=T ( n-1 )+n)且 (T ( 0 )=1) ,我们可以通过展开递推式来求解 (T ( n ))的表达式。 展开递推式:

[
\begin{array}{l} T (n) = T (n - 1) + n \ = [ T (n - 2) + (n - 1) ] + n = T (n - 2) + (n - 1) + n \ = [ T (n - 3) + (n - 2) ] + (n - 1) + n = T (n - 3) + (n - 2) + (n - 1) + n \ \vdots \ = T (0) + 1 + 2 + 3 + \dots + n \ \end{array}
]

已知 T(0)=1,所以:

[
T (n) = 1 + \sum_ {k = 1} ^ {n} k = 1 + \frac {n (n + 1)}{2}
]

因此, (T ( n ) = \frac { n ( n + 1 ) } { 2 } + 1。) 当 (n) 很大时, (T(n)) 的主要项是 (\frac{n^2}{2}) ,所以 (T(n) = \Theta (n^2)) ,即时间复杂度为 (O(n^2)) 故正确答案是D (O(n^2)) 。

说人话,就是模拟的数据太小了,建议增加数据模拟值

T10

题目:具有$n$个顶点,$e$条边的图采用邻接表存储结构,进行DFS和BFS的时间复杂度均为( )

A $O(n+e)$
B $O(ne)$
C $O(e^2)$
D $O(n^2)$

我在考试中选了B,那时候我根本不知道邻接表是啥

现在让我们邀请AI

邻接表
邻接表是图的一种高效存储结构,用于表示顶点间的关联关系,尤其适合稀疏图(边数远少于顶点数平方)。
存储方式分两部分:

  1. 顶点表:用数组或链表存储所有顶点信息,每个顶点元素关联一个指针,指向其邻接边的列表。
  2. 邻接边表:为每个顶点建立一个链表,链表节点存储与该顶点直接相连的“邻接顶点索引”及边的权重(无向图/有向图通用)。比如无向图中顶点A连B,A的邻接表含B,B的邻接表也含A;有向图中A→B仅A的邻接表含B。
    相比邻接矩阵,邻接表节省空间,查询顶点邻接边时效率更高,是图论中常用的存储方式。

继续邀请ai分析题目

答案选A:$O(n+e)$
解析:在邻接表存储结构中,DFS(深度优先搜索)和BFS(广度优先搜索)遍历图时,每个顶点都会被访问一次(时间复杂度$O(n)$),同时每条边也会被检查一次(时间复杂度$O(e)$)。
两种算法的总操作次数是顶点访问次数与边检查次数的总和,因此时间复杂度均为$O(n+e)$,适用于有向图和无向图的情况。

所以,选A,说人话:分别遍历点和边

T15

题目:由数字1,1,2,4,8,8所组成的不同的四位数的个数是( )

A 102
B 120
C 560
D 720

考试中,不知道就选C

答案为A
本题有4种情况,他们分别是无重复数字 $A_4^4$共24种、含2个1(无8重复) $C_2^4 \times A_2^3=6 \times 6=36$、含两个8(无1重复) $C_2^4 \times A_2^3=36$、含两个1和两个8 C_2^4=6,综合为102种

二 阅读程序

第一大题

#include<iostream>
int main()
{
    int n, c;
    std::cin >> n >> c;
    long long sum = 0;
    int pre = 1000000000;
    for (int i = 0; i < n; ++i) {
        int a;
        std::cin >> a;
        if (pre > a) {
            pre = a;
        }
        sum += pre;
        pre += c;
    }
    std::cout << sum << "\n";
}

T16

题目:当输入的a全部相等时,程序输出的结果一定等于$n \times a$

我当时考试中填的是正确

当时也没模拟完整

考试后模拟的样例:

input

5 3
3 3 3 3 3

output

45

事实声明,本题为×

第二大题

bool c[max_size][max_size] = {false};
void draw(int size, int x, int y)
{
    if (size == 1)
    {
        c[x][y] = true;
    }
    else
    {
        int half = size / 2;
        draw(half, x + half, y);
        draw(half, x, y + half);
        draw(half, x + half, y + half);
    }
}
void print(int n)
{
    int length = 1 << n;
    draw(length, 0, 0);
    for (int x = 0; x < length; ++x)
    {
        for (int y = 0; y < length; ++y)
        {
            if (c[x][y])
                std::cout << '*';
            else
                std::cout << '.';
        }
        std::cout << "\n";
    }
}

这个代码怎么不完整

T20

题目:在draw的过程中,左上角的四分之一子区域始终不会被绘制

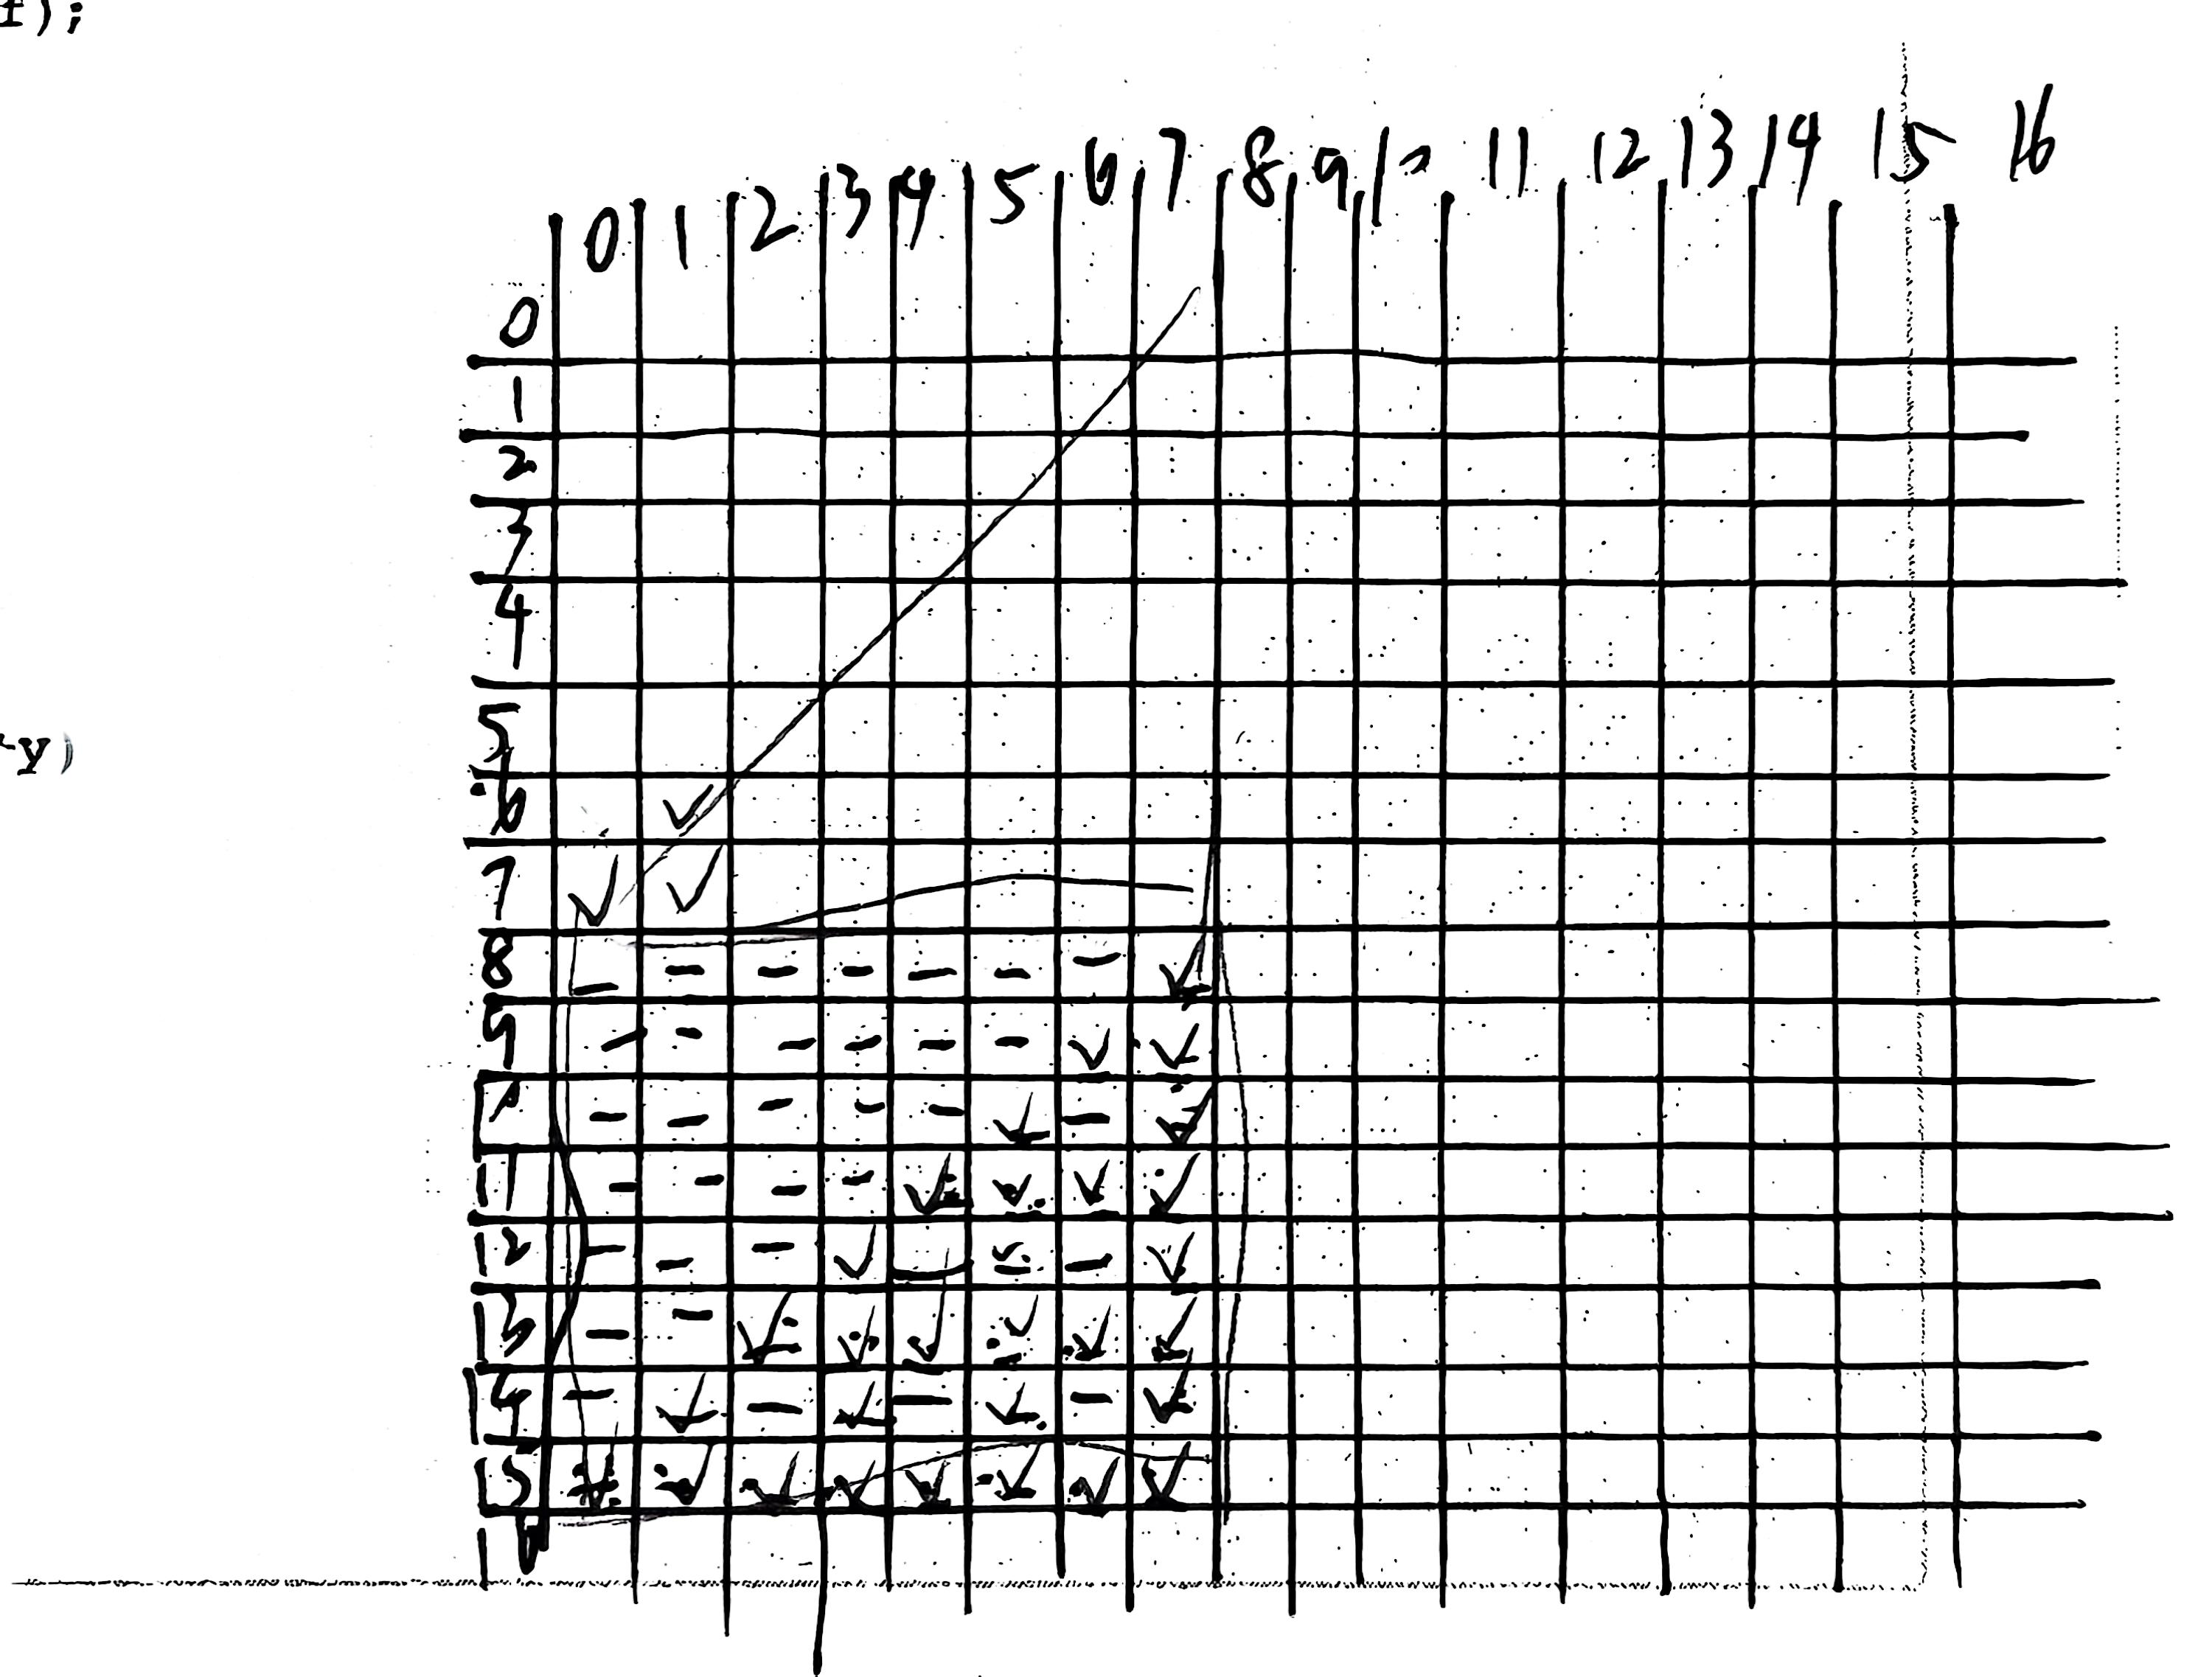
当时我模拟是模拟到这里了

模拟图.jpg

然后也懒得模拟了

如果按照这样的规律下去,那么左上角四分之一区域是会被绘制的

也不懂

估计是我题目理解问题

T24

题目:print(n)的时间复杂度为( )

A $O(n)$
B $O(2^n)$
C $O(3^n)$
D $O(4^n)$

答案为D,考试我选了B

但是deepseek的观点是选C,所以,我们需要注意:[font color="#FF0000"]内容由 AI 生成,请仔细甄别[/font]

T27

题目:程序输出的图形,是沿( )对称图形

A 对角线
B 水平中轴
C 垂直中轴
D 中心镜像

考试我选择C,因为从上面那张目前模拟的地方,选C确实对于模拟没错

but

为什么错了???

也许是模拟错了吧

其实还有另外一张模拟了一张的草稿纸,但被我当作lese扔进垃圾桶了

第三大题

bool valid = true;
std::vector<int> adj[max_node];
bool instack[max_node] = {false};
bool visited[max_node] = {false};
void dfs(int node)
{
    instack[node] = true;
    visited[node] = true;
    for (auto after : adj[node]) {
        if (!visited[after]) {
            visited[after] = true;
            dfs(after);
        } else if (instack[after]) {
            valid = false;
        }
    }
    instack[node] = false;
}
int main()
{
    int n, m;
    std::cin >> n >> m;
    for (int i = 0; i < m; i++)
    {
        int x, y;
        std::cin >> x >> y;
        adj[x].push_back(y);
    }
    for (int i = 1; i <= n; i++)
    {
        if (!visited[i])
        {
            dfs(i);
        }
    }
    if (valid) {
        std::cout << "Valid\n";
    } else {
        std::cout << "Invalid\n";
    }
}

T34

题目:当输入节点数$n=10^5$,边数$m=2 \times 10^5$时,程序是否能高效运行( )

A 能,$O(n+m)$复杂度
B 不能,$O(nm)$复杂度
C 不能,递归栈溢出
D 取决于图的具体结构

说实话,我考试中都不知道这个代码在干什么,全都是瞎懵的,选择题全队,选择题错了一个,即这个,考试懵了C,因为不知道就选C

让我们的deepseek来分析这道题

???deepseek选C???

小声os:@deepseek: look in my eyes . tell me ? why ? why baby ? why ?

三 完善程序

第一大题

S了
但是让deepseek根据题目写代码

#include <iostream>
#include <vector>
using namespace std;

const int MAX_N = 1005;
const int MAX_M = 1005;

int main() {
    int n, N;
    cin >> n >> N;
    vector<string> P(N);
    for (int i = 0; i < N; ++i) {
        cin >> P[i];
    }
    int Q;
    cin >> Q;

    // 前缀和数组,sum_black[i][j] 表示从(0,0)到(i-1,j-1)的黑格数量
    vector<vector<int>> sum_black(n + 1, vector<int>(n + 1, 0));

    for (int i = 1; i <= n; ++i) {
        for (int j = 1; j <= n; ++j) {
            int pi = (i - 1) % N;
            int pj = (j - 1) % N;
            int black = (P[pi][pj] == 'B') ? 1 : 0;
            sum_black[i][j] = sum_black[i - 1][j] + sum_black[i][j - 1] - sum_black[i - 1][j - 1] + black;
        }
    }

    while (Q--) {
        int A, B, C, D;
        cin >> A >> B >> C >> D;
        // 计算矩形区域内的黑格数量,注意坐标从0开始,转换为前缀和的1-based索引
        int black_count = sum_black[C + 1][D + 1] - sum_black[A][D + 1] - sum_black[C + 1][B] + sum_black[A][B];
        cout << black_count << endl;
    }

    return 0;
}

也不知道对不对

第二大题

#include<iostream>
int len(int n) {
    int length = 0;
    while (n > 0) {
        n /= 10;
        length++;
    }
    return length;
}
void print(int n, char ch) {
    while (n-- > 0) std::cout << ch;
}
int main() {
    int a, b;
    char dummy;
    std::cin >> a >> dummy >> b;
    int p = a;
    int q = b;
    while (a != 0 and b != 0) {
        if (a >= b) a %= b;
        else b %= a;
    }
    int gcd;
    if (____(1)____) gcd = b;
    else gcd = a;
    int i = p / q;
    p %= q;
    p /= gcd;
    q /= gcd;
    if (____(2)____) {
        std::cout << i << "\n";
    } else {
        int i_len = len(i);
        int p_len = len(p);
        int q_len = len(q);
        ____(3)____;
        std::cout << ____(4)____ << "\n";
        if (i != 0) std::cout << i;
        ____(5)____;
        std::cout << "\n";
        ____(6)____;
        std::cout << ____(7)____ << "\n";
    }
}

T44

考试的时候眼瞎了,看错位置了,这个是要输出杠的

完

致谢